Crawled – currently not indexed? A solução de verdade
Por Toy Wen Da, Cofundador · · 12 min de leitura
Traduzido do original em inglês. Ler em inglês
Crawled – currently not indexed significa que o Googlebot abriu sua página, mas decidiu não incluí-la nos resultados de busca por enquanto. Em geral, isso acontece por conteúdo raso ou duplicado, links internos fracos ou sinais que fazem a página parecer de baixa prioridade. Este guia explica as três causas e como corrigir cada uma.
O que "Crawled – currently not indexed" realmente significa
Quando o relatório Page Indexing do Google Search Console marca uma URL como "Crawled – currently not indexed", ele está dizendo algo bem específico. O Googlebot encontrou a página, buscou o conteúdo e o renderizou. Mas decidiu não guardá-la no índice de onde saem os resultados de busca. A página existe no seu servidor e o Google a leu. Ela só não está apta a aparecer quando alguém pesquisa.
Isso é diferente de uma página que o Google ainda não chegou a visitar, e também de uma página que você mandou o Google ignorar. O status crawled currently not indexed fica no meio do caminho: o Google olhou e respondeu "ainda não" ou "esta não".
Como ele se diferencia de outros status de não indexação
O relatório Page Indexing agrupa as URLs excluídas em vários grupos. Eles não significam a mesma coisa nem pedem a mesma resposta.
| Status | O que significa | Causa típica | Ação necessária |
|---|---|---|---|
| Crawled – currently not indexed | O Google rastreou a página, mas escolheu não indexá-la | Conteúdo raso, links fracos, baixo valor percebido | Melhorar conteúdo e links e depois esperar |
| Discovered – currently not indexed | O Google sabe que a URL existe, mas ainda não a rastreou | Limites de orçamento de rastreamento, baixa prioridade na fila | Melhorar os links internos e ter paciência |
| Excluded by "noindex" tag | Uma meta tag ou um cabeçalho mandou o Google não indexar | Diretiva noindex intencional ou acidental | Remover a tag se você quiser a indexação |
| Duplicate, Google chose different canonical | O Google encontrou conteúdo quase idêntico em outro lugar e escolheu outra URL | Conteúdo duplicado ou sindicalizado, canonical ausente | Definir uma tag canonical clara |
| Soft 404 | A página parece vazia ou com cara de erro, mesmo com código de status 200 | Conteúdo ausente, templates quebrados | Corrigir a página ou retornar um 404 de verdade |
O crawled – currently not indexed é o que mais frustra, porque não há uma regra óbvia sendo quebrada. Na maioria dos casos, o Google não está bloqueando a página de propósito. Ele está avaliando se a página merece um lugar no índice.
É mesmo um problema? Confira antes de corrigir
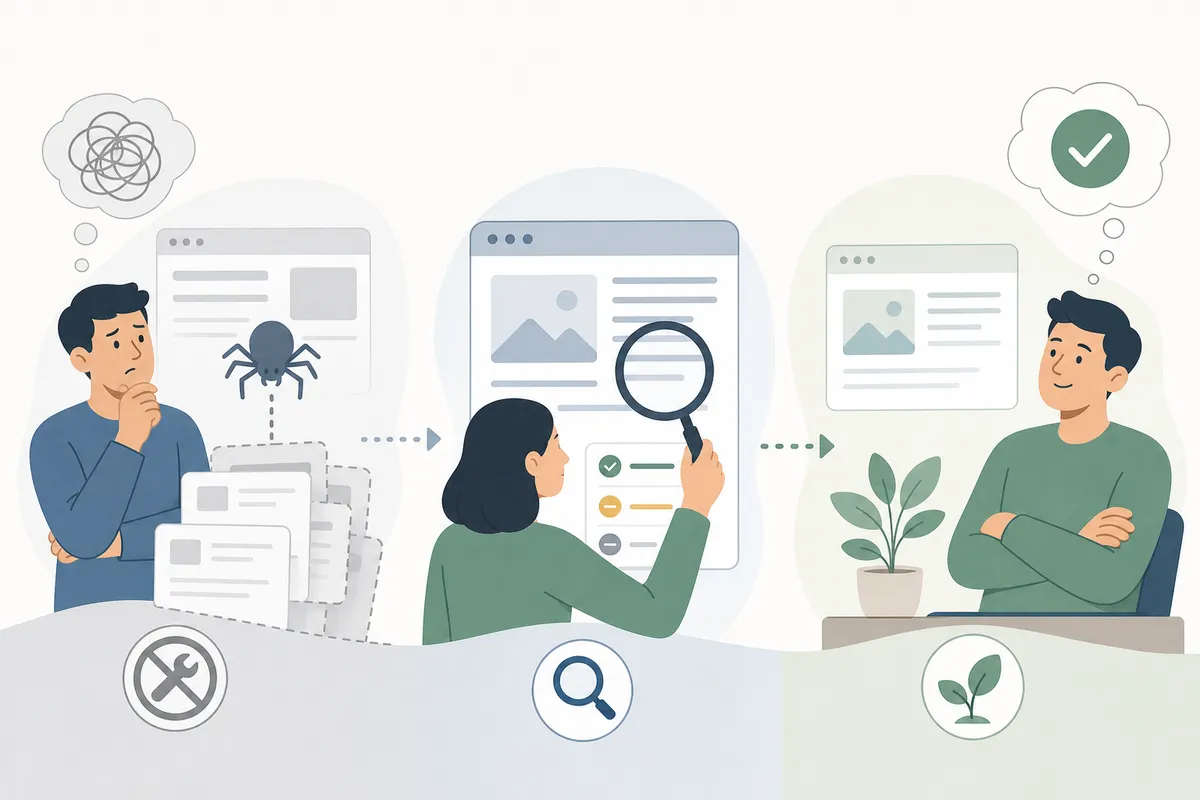
Antes de gastar horas com correções, confirme que o problema é real. O relatório Page Indexing pode ficar defasado em relação à realidade, principalmente em sites maiores. Uma URL marcada como não indexada pode já estar aparecendo na busca.
Faça uma verificação rápida:
- Abra a ferramenta Inspeção de URL (URL Inspection) no Search Console e veja a data do "último rastreamento". Uma data antiga pode indicar que o status não foi atualizado.
- Pesquise
site:seudominio.com/url-da-paginadireto no Google. Se a página aparecer, ela está indexada e o relatório só não acompanhou. - Se forem dezenas ou centenas de URLs afetadas, extraia a lista pela API do Search Console ou com um crawler como o Screaming Frog. Depois, cruze os dados com os resultados reais da busca em lote, em vez de conferir uma por uma.
Se, depois dessa verificação, a página realmente não estiver indexada, passe a decidir se ela deveria estar.
Páginas que podem ficar rastreadas e não indexadas
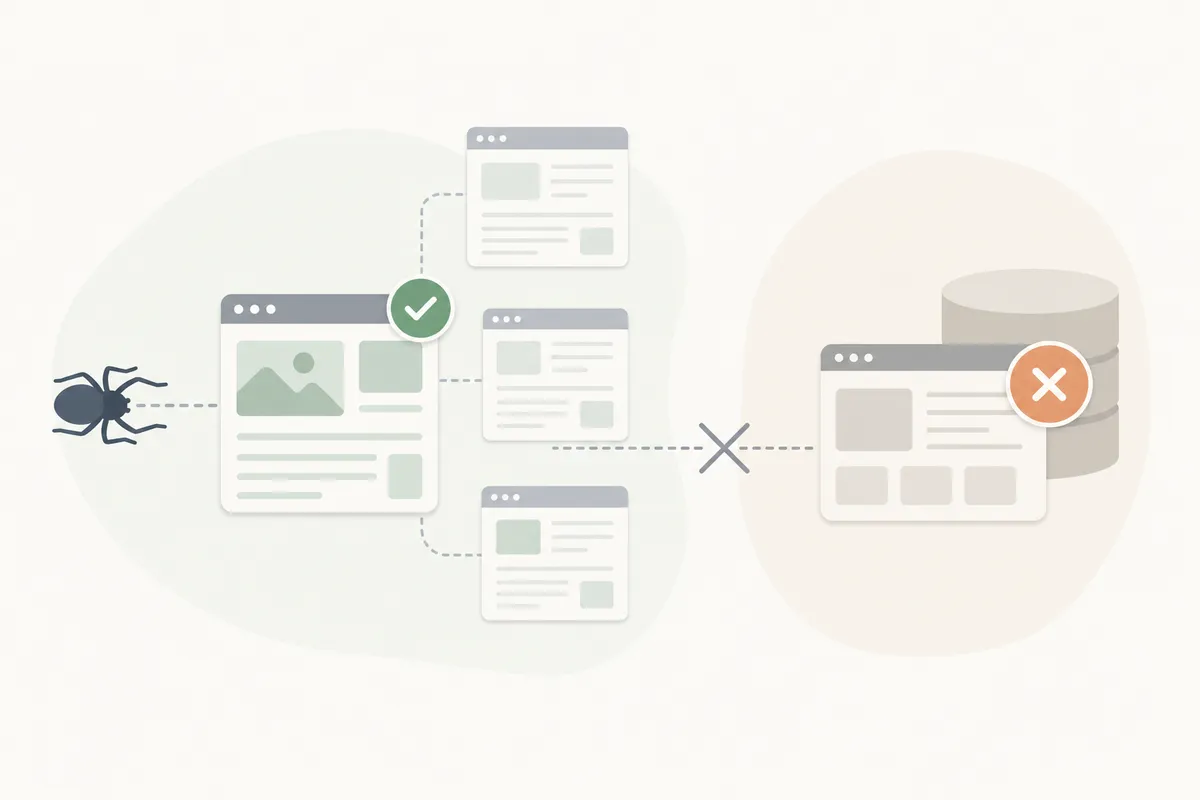
Boa parte das páginas em crawled currently not indexed não precisa de correção nenhuma. O Google tem razão em deixá-las de fora. Revise a sua lista e separe as que não importam das que importam.
| Tipo de página | Exemplo | Por que não tem problema ficar sem indexação |
|---|---|---|
| Resultados de busca interna | /search?q=blue-shoes |
Conteúdo quase duplicado, sem valor único para quem pesquisa |
| URLs com facetas/filtros | /products?color=red&size=m |
Variações da mesma página de catálogo; se indexadas, desperdiçam orçamento de rastreamento |
| Arquivos de tags ou categorias rasos | /tag/summer2022 |
Duplicam conteúdo que já está disponível em outro lugar |
| Páginas sazonais expiradas | /temp/new-year-sale-2023 |
Perdem a relevância quando o evento ou a promoção termina |
| Feeds RSS e sitemaps | /feed/latest-news, /sitemap.xml |
Feitos para sindicalização e descoberta, não para resultados de busca |
Se uma página desse grupo estiver poluindo seus relatórios, adicione uma tag noindex. Assim, ela deixa de aparecer como "problema". Isso é uma tarefa de limpeza, não uma batalha por indexação.
Causas comuns de páginas em Crawled – currently not indexed
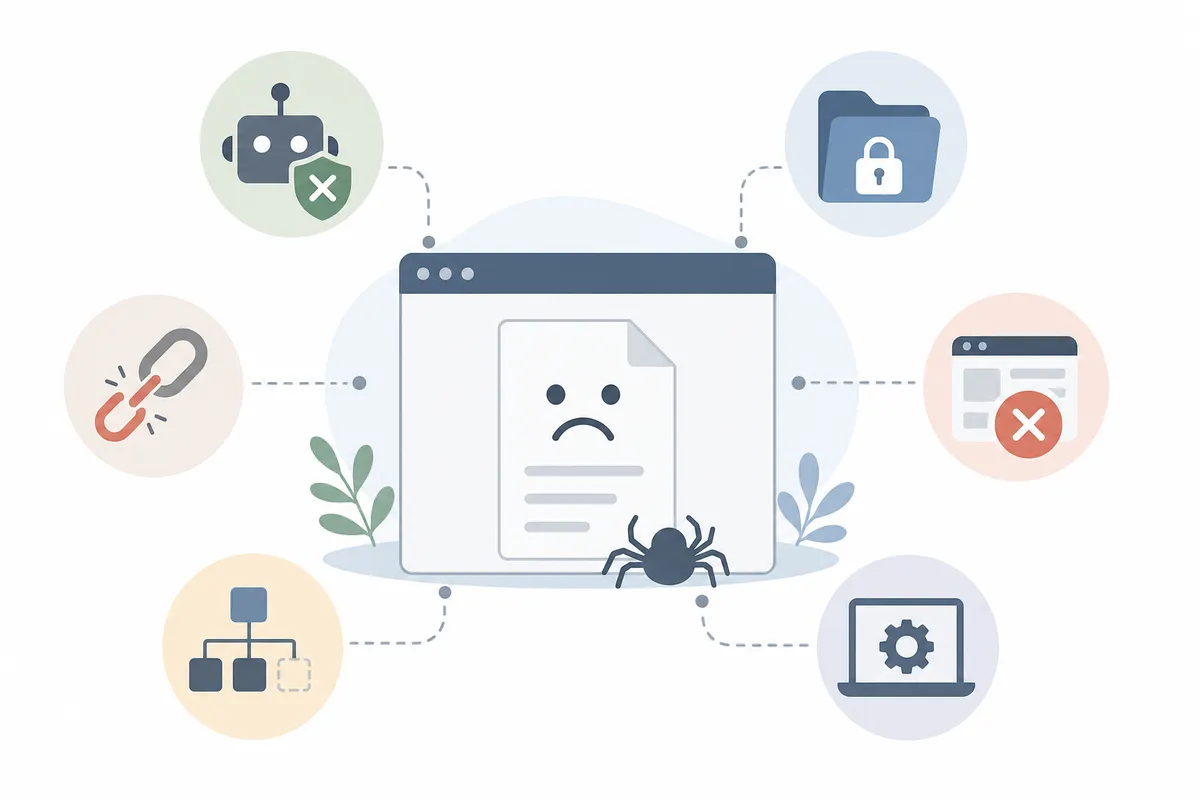
Para as páginas que realmente deveriam ranquear e não ranqueiam, a causa quase sempre cai em um destes poucos grupos. Analise-os na ordem em que mais aparecem em auditorias reais.
Conteúdo raso ou de baixo valor
Este é o motivo mais comum para páginas legítimas ficarem presas como crawled but not indexed. Algumas auditorias sinalizam como risco de conteúdo raso tudo o que tem menos de cerca de 600 palavras. Mas a contagem de palavras sozinha não é o teste de verdade. A pergunta que o Google faz é se a página acrescenta algo que o usuário ainda não encontra em outras dezenas de resultados.
Texto gerado automaticamente e descrições de produto padronizadas, copiadas do feed do fabricante, entram nessa categoria. O mesmo vale para páginas que repetem o título em três frases. Se você publica um grande volume de páginas para "cobrir mais palavras-chave", mais volume sem mais substância é exatamente o que provoca esse status. Esse padrão é tratado com mais profundidade nesta análise sobre estratégia de conteúdo guiada por feedback em vez de volume de publicação.
Conteúdo duplicado ou quase duplicado
Se os mesmos parágrafos aparecem em várias URLs, o que é comum em páginas de localidades, versões para impressão ou artigos sindicalizados, o Google indexa uma versão. As outras ficam rastreadas, mas não indexadas. Esse é o comportamento esperado, não uma penalidade. Só funciona direito se as suas tags canonical apontarem para a versão que você realmente quer ver ranqueada.
Sindicalizar conteúdo em outros sites traz um risco parecido. Se a cópia republicada ranquear melhor ou for indexada antes do original, o original pode acabar excluído. Este guia sobre sindicalização de conteúdo sem criar problemas de duplicidade para si mesmo explica como republicar sem prejudicar a indexação da página de origem.
Links internos fracos ou ausentes
Páginas órfãs, que não recebem nenhum link interno, passam um sinal fraco de prioridade. O Google pode rastrear uma URL que encontrou em um sitemap. Mas, se nada no seu site aponta para ela, há pouco motivo para tratá-la como importante. Uma linkagem interna densa e lógica é uma das formas mais confiáveis de fazer o Google reconsiderar uma página parada.
Orçamento de rastreamento e sinais de qualidade do site como um todo
Em sites grandes, o orçamento de rastreamento é limitado. O Googlebot consegue renderizar páginas de até cerca de 15 MB, mas não gasta tempo ilimitado em um site cheio de URLs de baixo valor. Se o seu domínio tem milhares de páginas rasas ou quase duplicadas, o Google pode reduzir a prioridade de rastrear e indexar as novas até que a qualidade melhore. A canibalização de palavras-chave, quando várias páginas competem pela mesma consulta, agrava a situação. O Google costuma excluir todas as versões concorrentes em vez de adivinhar qual delas ranquear.
Conteúdo desatualizado
Uma página pode ter bastante substância e, mesmo assim, parecer ultrapassada se nada nela muda há anos. Conteúdo que já foi útil, mas nunca é revisitado, tende a caminhar para esse status. Concorrentes mais atuais ocupam o lugar dele no índice. Manter as páginas principais atualizadas, sem reescrevê-las, apenas em dia, é uma das formas mais duradouras de evitar o limbo do "currently not indexed". Esse ponto é aprofundado em por que o conteúdo perene continua rendendo juros em vez de murchar depois de um pico de tráfego.
Como corrigir páginas em Crawled – currently not indexed
Depois de confirmar que a página realmente merece estar no índice e de isolar a causa provável, aplique as correções por ordem de prioridade. Nem todas têm o mesmo peso, então não passe uma semana mexendo em links internos se o problema de verdade é conteúdo raso.
| Correção | O que resolve | Esforço típico | Prioridade |
|---|---|---|---|
| Ampliar e fortalecer o conteúdo | Páginas rasas ou de baixo valor | Médio–alto | Alta |
| Definir tags canonical corretas | Conteúdo duplicado/quase duplicado | Baixo | Alta |
| Adicionar links internos de páginas relevantes | Páginas órfãs, sinais fracos | Baixo–médio | Alta |
| Corrigir o robots.txt e as meta tags robots | Bloqueio acidental ou noindex | Baixo | Alta |
| Melhorar a velocidade da página e a confiabilidade da renderização | Páginas que expiram o tempo ou renderizam de forma incompleta | Médio | Média |
| Consolidar páginas quase duplicadas | Canibalização de palavras-chave | Médio | Média |
| Construir ou conquistar links externos para a página | Baixa autoridade percebida | Alto | Média |
| Solicitar indexação pela Inspeção de URL | Dar um empurrão no Google depois de uma correção real | Baixo | Baixa |
Verifique primeiro os bloqueios técnicos
Abra o código-fonte da página e confirme que não há uma meta tag noindex nem um cabeçalho X-Robots-Tag que você não tenha colocado de propósito. Depois, passe a URL pelo robots.txt Tester no Search Console para garantir que nada nesse arquivo bloqueia o caminho. Essas verificações levam minutos e eliminam a explicação mais simples antes de você presumir que o problema é o conteúdo.
Reescreva ou amplie o conteúdo
Se a página é rasa, não encha de enrolação. Acrescente a informação específica que o usuário veio buscar: detalhes de preço, uma comparação, um exemplo prático ou uma resposta de verdade à pergunta. Páginas feitas para atender diretamente à intenção de busca tendem a sair desse status mais rápido do que páginas feitas para bater uma contagem de palavras. Para páginas de produto e de categoria, veja estas práticas de SEO para e-commerce, pensadas no que realmente gera vendas e não apenas tráfego. Elas tratam das lacunas de conteúdo que mais mantêm páginas de listagem presas aqui.
Corrija a linkagem interna e a estrutura do site
Adicione links contextuais a partir de páginas que já ranqueiam bem e tratam do mesmo assunto. Uma página de produto sem nenhum link interno apontando para ela, por exemplo, é um caso clássico de página órfã. Incluí-la em uma página de categoria, em um bloco de produtos relacionados ou em um post de blog relevante dá ao Google um motivo para indexá-la.
Configure um monitoramento automatizado em vez de reenviar manualmente
Clicar repetidamente em "Solicitar indexação" (Request Indexing) no Search Console não acelera nada e, se for exagerado, pode marcar a URL para revisão manual. Uma abordagem melhor é montar um fluxo que verifique o status de indexação em intervalos regulares e sinalize as páginas que passarem de um prazo razoável sem avanço. Este artigo sobre fluxos de automação de SEO que publicam correções em dias, não em semanas mostra como estruturar um monitoramento contínuo assim. Ele substitui as verificações manuais e pontuais.
Trate isso também como um problema de visibilidade em IA
Uma página que nunca é indexada pelo Google também nunca tem chance de ser citada por mecanismos de resposta de IA. A maioria dessas ferramentas se baseia muito na mesma web rastreada e indexada. Se você está investindo em conteúdo pensado para aparecer nas AI Overviews, nas respostas do Perplexity ou nas respostas do ChatGPT, passar da etapa "crawled" importa. Chegar ao índice é o primeiro portão, não um passo opcional. Este guia sobre como ser citado no Perplexity, e não apenas rastreado vale a leitura junto com as suas correções de indexação. Isso vale ainda mais se a visibilidade em IA fizer parte do objetivo. A mesma lógica se aplica às páginas de produto que alimentam respostas de IA sobre compras. Veja este texto sobre como fazer os produtos de e-commerce serem citados, e não ignorados, pela busca com IA.
Quanto tempo leva para indexar depois de uma correção?
Não há um prazo fixo, mas uma faixa realista vai de dias a algumas semanas. É o tempo que o Google leva para rastrear de novo e reconsiderar uma página depois de uma correção de qualidade de verdade. Sites maiores ou com menos autoridade tendem a ficar na ponta mais longa. O Google afirmou que reenviar uma URL pelo Search Console não é obrigatório e não força a indexação. Isso apenas recoloca a URL na fila de rastreamento um pouco mais cedo, conforme a documentação de ajuda do Search Console do próprio Google.
Se uma página continua em crawled but not indexed por mais de um mês depois de uma correção de conteúdo e de links, isso é um sinal. O problema de fundo não foi totalmente resolvido, então não fique apenas reenviando.
O crescimento vindo da correção de problemas de indexação tende a aparecer aos poucos, em muitas páginas, e não como um grande salto. Isso combina com o modo como o crescimento orgânico se acumula a partir de uma campanha planejada, e não de um único pico. Esperar que um único reenvio resolva tudo cria a expectativa errada desde o início.
Como evitar que esse status volte
Corrigir o lote de páginas excluídas de hoje importa menos do que acabar com o padrão que as criou. Alguns hábitos impedem que o número volte a crescer:
- Publique menos páginas, mas mais fortes, em vez de inundar o site com páginas rasas para correr atrás de volume de palavras-chave.
- Audite a linkagem interna a cada trimestre, para que páginas novas nunca nasçam órfãs.
- Mantenha um calendário fixo de atualização de conteúdo, em vez de deixar as páginas mais antigas ficarem defasadas e saírem do índice com o tempo.
- Confira o relatório Page Indexing todo mês, e não só quando algo parecer errado.
- Trate a saúde da indexação como um sistema único, e não como uma série de emergências sem relação. Essa é a mentalidade apresentada em este framework para construir domínio de SEO como um sistema repetível, em vez de correr atrás de truques isolados.
Vale lembrar também que a indexação, sozinha, não é a linha de chegada. Uma página indexada que ninguém clica nem cita continua com desempenho abaixo do ideal. Este roteiro para conquistar citações em ambientes de busca sem clique, em vez de perseguir apenas cliques é uma boa próxima leitura. Dê uma olhada quando os seus números de indexação se estabilizarem.
Quando buscar ajuda externa
Imagine que você já verificou a qualidade do conteúdo, as tags canonical, o robots.txt, as meta tags e os links internos. Mesmo assim, depois de várias semanas, as páginas continuam presas em crawled currently not indexed. A causa pode ser um problema de confiança ou de orçamento de rastreamento no site inteiro, mais difícil de diagnosticar página por página. Entre os suspeitos comuns estão uma migração recente, uma grande entrada de páginas de baixa qualidade diluindo o domínio ou sinais técnicos inconsistentes entre templates. Em geral, é aí que uma auditoria técnica mais completa se paga. Faça-a com alguém que consiga enxergar o site inteiro, e não uma URL de cada vez.
Perguntas frequentes
"Crawled – currently not indexed" significa que minha página tem um erro?
Não. Significa que o Google rastreou a página com sucesso e escolheu não indexá-la. Em geral, é uma decisão de qualidade do conteúdo ou de prioridade, não um erro técnico. Um erro de verdade normalmente apareceria como status 4xx, 5xx ou soft 404.
Devo reenviar a URL no Search Console a cada poucos dias?
Não. O Google já disse que reenviar não acelera nem força a indexação. Fazer isso várias vezes na mesma URL pode marcá-la para revisão manual sem ajudar em nada. Corrija primeiro a causa de fundo, solicite a indexação uma vez e depois acompanhe.
Uma página pode sair de crawled currently not indexed e ficar totalmente indexada por conta própria?
Sim, às vezes. De vez em quando o Google reconsidera uma página com o tempo, à medida que outros sinais do site melhoram, mesmo sem uma edição direta nela. Não é confiável o bastante para contar com isso, mas acontece.
Conteúdo raso é sempre o que fica abaixo de uma contagem específica de palavras?
Não necessariamente. A contagem de palavras é uma referência aproximada, não a regra de verdade. Algumas auditorias sinalizam tudo o que tem menos de 600 palavras, mas uma página curta que responde por completo a uma pergunta específica ainda pode ser indexada. Uma página longa, cheia de enrolação, ainda pode ser excluída.
Ter muitas páginas nesse status prejudica o SEO do meu site inteiro?
Um punhado de páginas utilitárias deixadas sem indexação de propósito não vai prejudicar você. Já um grande volume de páginas realmente ruins, presas nesse status, pode piorar a forma como o Google avalia a qualidade geral do seu site e a prioridade de rastreamento. Vale limpar isso em vez de ignorar.
Tenha uma visão clara dos seus próprios problemas de indexação
O seu relatório Page Indexing mistura páginas que podem ser ignoradas com outras que de fato fazem você perder tráfego. Distingui-las exige mais do que olhar a lista por cima. É preciso verificar qualidade do conteúdo, links e sinais técnicos, página por página. Se você prefere ver essa análise montada para o seu próprio site, fale com a equipe e peça um relatório de amostra. Ele mostra exatamente o que está impedindo as páginas de sair de crawled currently not indexed.
## Recursos / Referências

1. [Documentação de ajuda do Search Console do próprio Google](https://support.google.com/webmasters/answer/7440203)

## Fontes

- [How We Fix 'Crawled - currently not indexed' on Google ...](https://www.embarque.io/post/how-we-fix-crawled-currently-not-indexed-on-google-search-console)
- [Crawled – Currently Not Indexed in Google Search Console](https://seosly.com/blog/crawled-currently-not-indexed-in-google-search-console/)
- [Understanding and resolving 'Discovered - currently not ...](https://searchengineland.com/understanding-resolving-discovered-currently-not-indexed-392659)
- [Crawled - currently not indexed' mean and how do you fix it?](https://www.quora.com/In-Google-Search-Console-what-does-Excluded-Crawled-currently-not-indexed-mean-and-how-do-you-fix-it)
- [Crawled - Currently Not Indexed: Proven Ways to fix.](https://the7eagles.com/crawled-currently-not-indexed/)
Sobre o autor
O SearchBlueprint pesquisou, escreveu e avaliou este artigo com o mesmo pipeline de conteúdo que nossos clientes usam nos próprios sites. A nota que aparece na assinatura é a que nosso mecanismo de conteúdo deu a esta página antes de ela ser publicada. Nada aqui passa por revisão manual, e esse é justamente o ponto: é o resultado do produto, publicado onde qualquer pessoa pode conferir.