O que é indexação em buscadores e como ela funciona (e por que algumas páginas são ignoradas)
Por Toy Wen Da, Cofundador · Atualizado em · 21 min de leitura
Traduzido do original em inglês. Ler em inglês
O que é indexação em buscadores e como ela funciona? É o processo que um buscador usa para examinar uma página, armazenar o conteúdo dela em um banco de dados pesquisável e decidir se ela pode aparecer nos resultados. Sem indexação, uma página não existe para o Google nem para o Bing, por melhor que seja.

Se você publicou uma página e ficou se perguntando por que ela nunca aparece no Google, a resposta quase sempre está nessa etapa. O rastreamento encontra a página, a indexação decide se ela será guardada e o ranqueamento define em que posição ela fica depois de entrar. Se a etapa do meio falha, o resto não importa.
Você pode acertar na pesquisa de palavras-chave, escrever um artigo realmente útil e mesmo assim ter zero tráfego, porque a página nunca entrou no índice. O problema, nesse caso, não é o ranqueamento, e sim a indexação, e ele exige outra correção.
O que é indexação em buscadores?
A indexação em buscadores é o processo pelo qual um buscador analisa o conteúdo de uma página da web e o adiciona ao seu índice, um banco de dados pesquisável com as páginas que ele considera aptas a aparecer nos resultados. É a segunda de três etapas pelas quais uma página passa antes de poder ranquear: rastreamento, indexação e ranqueamento.
Pense em uma biblioteca. Rastrear é o bibliotecário percorrer as estantes anotando quais livros existem. Indexar é catalogar cada livro por assunto, autor e palavra-chave para que ele possa ser encontrado de novo em segundos. Ranquear é decidir qual livro entregar primeiro a determinado leitor.
Ser indexado não garante tráfego; só significa que você entrou no jogo. Uma página precisa estar indexada para poder ranquear por qualquer termo, e é por isso que essa etapa fica por baixo de quase todas as outras decisões de SEO que você vai tomar, incluindo as escolhas de on-page e técnicas abordadas em os fundamentos do SEO.
Como funciona a indexação em buscadores?
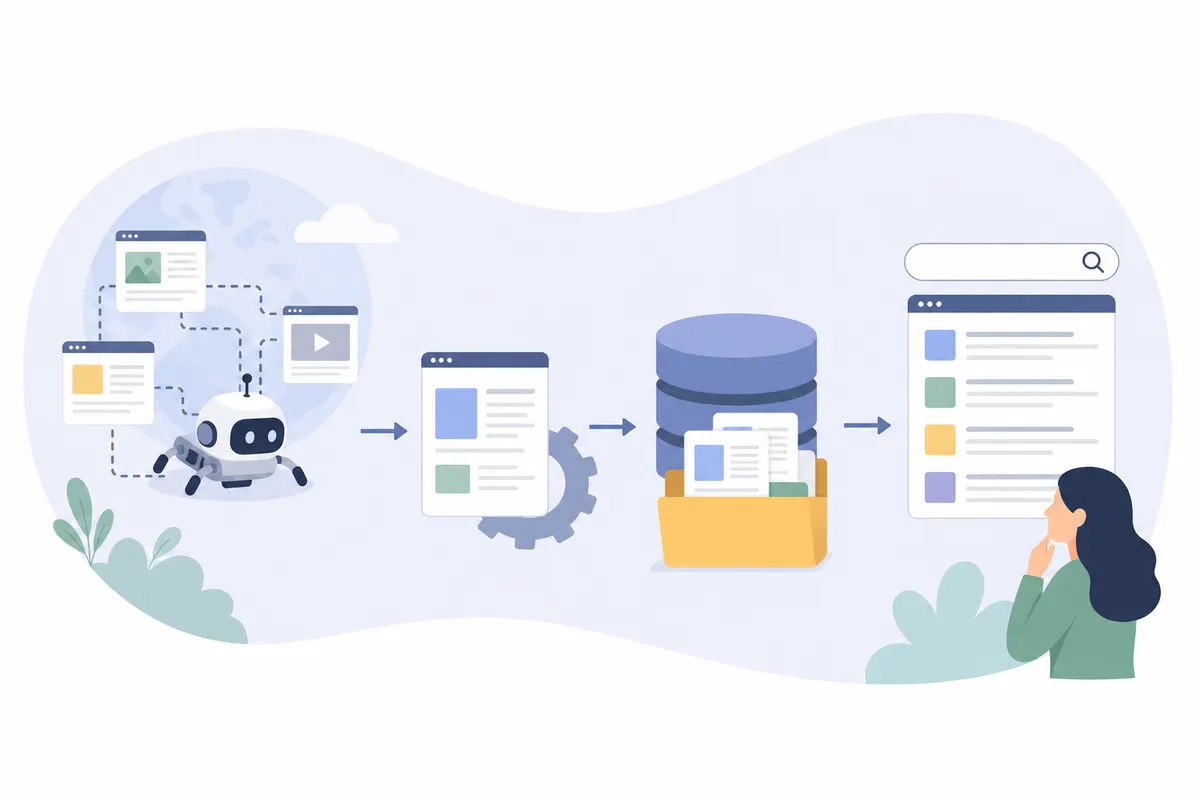
A indexação acontece em sequência. Um rastreador encontra a página, o buscador a renderiza e a analisa, e então decide se ela merece um lugar no índice.
Etapa 1: o rastreamento encontra a página
Antes de ser indexado, qualquer conteúdo precisa ser descoberto. Os buscadores usam programas automatizados, geralmente chamados de rastreadores, bots ou spiders, que seguem links de página em página pela web. O Googlebot e o Bingbot funcionam assim.
Um rastreador chega à sua página por um link vindo de uma página que ele já conhece ou porque você enviou a URL por um sitemap ou por uma ferramenta como o Google Search Console. Páginas novas, sem links de entrada e sem entrada no sitemap, podem ficar sem ser descobertas por tempo indeterminado.
Etapa 2: renderização e análise
Quando um rastreador chega a uma página, o buscador a renderiza de forma parecida com a de um navegador, carregando o HTML, o CSS e o JavaScript para ver a página finalizada. Segundo o Google Search Central, os sistemas do Google renderizam o conteúdo da página e registram sinais importantes, de palavras-chave a atualidade, antes de decidir o que fazer com ela.
Nessa etapa, o buscador lê o texto da página, a tag de título, os títulos internos, o texto alternativo das imagens, os links internos e os dados estruturados. Também verifica conteúdo duplicado, conteúdo raso e sinais técnicos como tags canônicas. A qualidade dos metadados começa a pesar aqui, e os sinais abordados em a real importância dos metadados para o SEO influenciam diretamente a forma como o buscador classifica a página.
Etapa 3: a indexação armazena o que importa
Se o buscador decide que a página tem valor único suficiente, ele armazena no índice a URL e os sinais de conteúdo dela. Essa é a indexação propriamente dita: o conteúdo agora faz parte do banco de dados pesquisável.
Nessa fase, o Google também define a canonicalização. Se várias URLs exibem conteúdo quase idêntico, o Google as agrupa e escolhe uma versão canônica para representar o grupo nos resultados. As demais são mantidas como alternativas, mas normalmente não aparecem de forma independente.
Etapa 4: o ranqueamento decide o que aparece
Estar indexada não significa que uma página apareça para toda busca relevante. O ranqueamento é o processo separado e contínuo de pontuar as páginas indexadas em relação a uma busca específica e ordená-las nos resultados. Uma página pode ficar meses no índice sem chegar à primeira página para a palavra-chave que ela tem como alvo.

Rastreamento, indexação e ranqueamento: por que a diferença importa
Em conversas informais, as pessoas usam essas três palavras como se fossem sinônimos, mas são processos diferentes, com pontos de falha diferentes. Uma página "rastreada" foi apenas visitada. Uma página "indexada" foi armazenada e considerada digna de ser mantida, e uma página que está "ranqueando" está competindo por uma busca específica.
| Etapa | O que acontece | Quem/o que realiza | Como é uma falha |
|---|---|---|---|
| Rastreamento | O bot descobre e visita a URL | Googlebot, Bingbot ou outros rastreadores | A URL nunca é visitada; nenhum link ou entrada de sitemap aponta para ela |
| Indexação | O conteúdo é analisado e armazenado no índice | Sistemas de indexação do buscador | Página rastreada, mas marcada como "Crawled – currently not indexed" |
| Ranqueamento | As páginas indexadas são pontuadas e ordenadas para uma busca | Algoritmo de ranqueamento, aplicado a cada busca | Página indexada, mas enterrada na página 5 ou além para a palavra-chave alvo |
Uma página pode ser rastreada sem ser indexada. É bem mais raro, mas uma página pode até estar indexada sem ter sido totalmente rastreada recentemente, se o Google já tiver dados mais antigos sobre ela. Manter as etapas separadas facilita muito o diagnóstico, porque "não está ranqueando" e "não está indexada" deixam de parecer o mesmo problema.
O que é um índice de buscador?
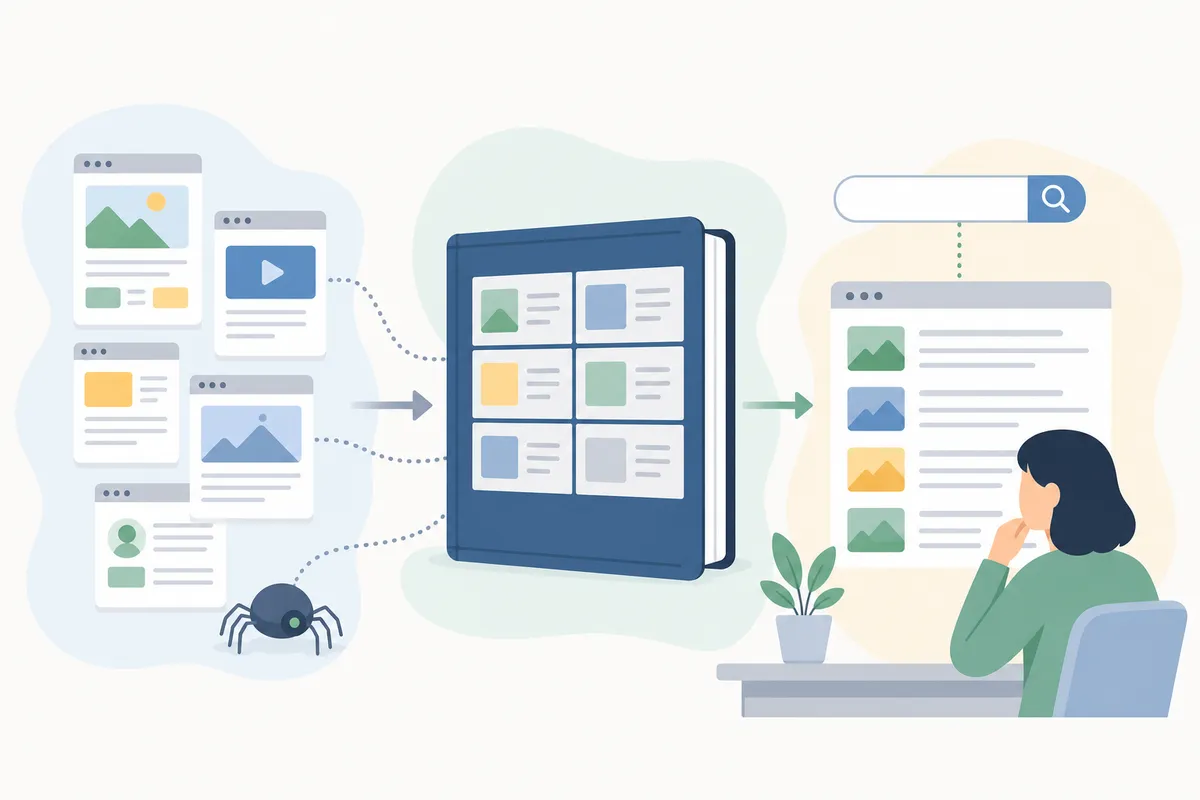
O índice de um buscador é o enorme banco de dados, atualizado continuamente, que o buscador constrói ao rastrear e armazenar informações sobre páginas da web. Quando você digita uma busca, é nele que o buscador realmente pesquisa, e não na internet ao vivo.
O buscador extrai as correspondências desse índice já pronto em vez de varrer a web em tempo real, e é por isso que os resultados chegam em uma fração de segundo mesmo com bilhões de páginas em jogo. O índice guarda a URL de cada página, um resumo do conteúdo e metadados como idioma, relevância de localização e compatibilidade com dispositivos móveis.
Todo grande buscador mantém a sua própria versão dessa estrutura, e entrar em um deles não garante automaticamente a entrada em outro.
O que é um índice invertido?
Um índice invertido é a estrutura de dados que torna possível essa consulta instantânea. Em vez de organizar os dados por página ("esta página contém estas palavras"), ele os organiza por palavra: "esta palavra aparece nestas páginas".
Quando você busca "melhores tênis de corrida", o buscador não varre todas as páginas atrás dessas palavras. Ele procura "melhores", "tênis" e "corrida" no índice invertido, pega a lista de páginas já associadas a cada termo, cruza essas listas e as ranqueia.
Esse é um dos principais motivos pelos quais a busca parece instantânea na escala da web moderna. É também por isso que a relevância das palavras-chave continua importando: se as palavras da sua página nunca foram mapeadas nas entradas certas, ela não vai aparecer para a busca, mesmo que esteja bem indexada em outros aspectos. Um conteúdo claro e bem estruturado, como o descrito em um guia prático de SEO on-page, dá ao índice uma linguagem limpa para trabalhar.

Indexação mobile-first: por que a versão que o Googlebot enxerga importa
Desde 2023, o Google indexa por padrão a versão mobile de uma página, e não a versão desktop, uma mudança que ele chama de indexação mobile-first. A equipe do Google Search Central confirmou, em seu blog oficial, que a migração foi praticamente concluída em toda a web. O Googlebot Smartphone é hoje o principal rastreador usado para montar o índice de praticamente todos os sites, e o antigo rastreador desktop ficou reservado para um pequeno número de exceções.
O que é indexado é o que a versão mobile realmente contém, e não o que um visitante no desktop vê. Esconder conteúdo atrás de um acordeão ou de uma aba no mobile geralmente não é problema, e esse conteúdo continua sendo indexado. Já o conteúdo deixado totalmente de fora do HTML mobile é outra história: navegação reduzida, descrições de produto encurtadas ou dados estruturados adicionados apenas ao template desktop simplesmente não estão lá para o Google indexar.
Sites que ainda usam um subdomínio mobile separado, geralmente com o prefixo m., correm um risco extra. Se as versões mobile e desktop não estiverem ligadas corretamente por tags rel=alternate e rel=canonical compatíveis, o Google pode indexar a versão errada ou tratar as duas como duplicadas e descartar uma. É o mesmo conflito de canonicalização visto acima, só que provocado pelo tipo de dispositivo em vez de parâmetros de URL.
A correção prática é o design responsivo: com um único documento HTML e uma única URL por página, a incompatibilidade entre mobile e desktop deixa de ser fonte de problemas de indexação. Para sites que não conseguem abandonar rapidamente um template mobile separado, o melhor passo seguinte é auditar a versão mobile em busca de todos os elementos que você quer indexados: texto, imagens com texto alternativo e dados estruturados.
Qual é o tamanho do índice? Números do Google e do Bing
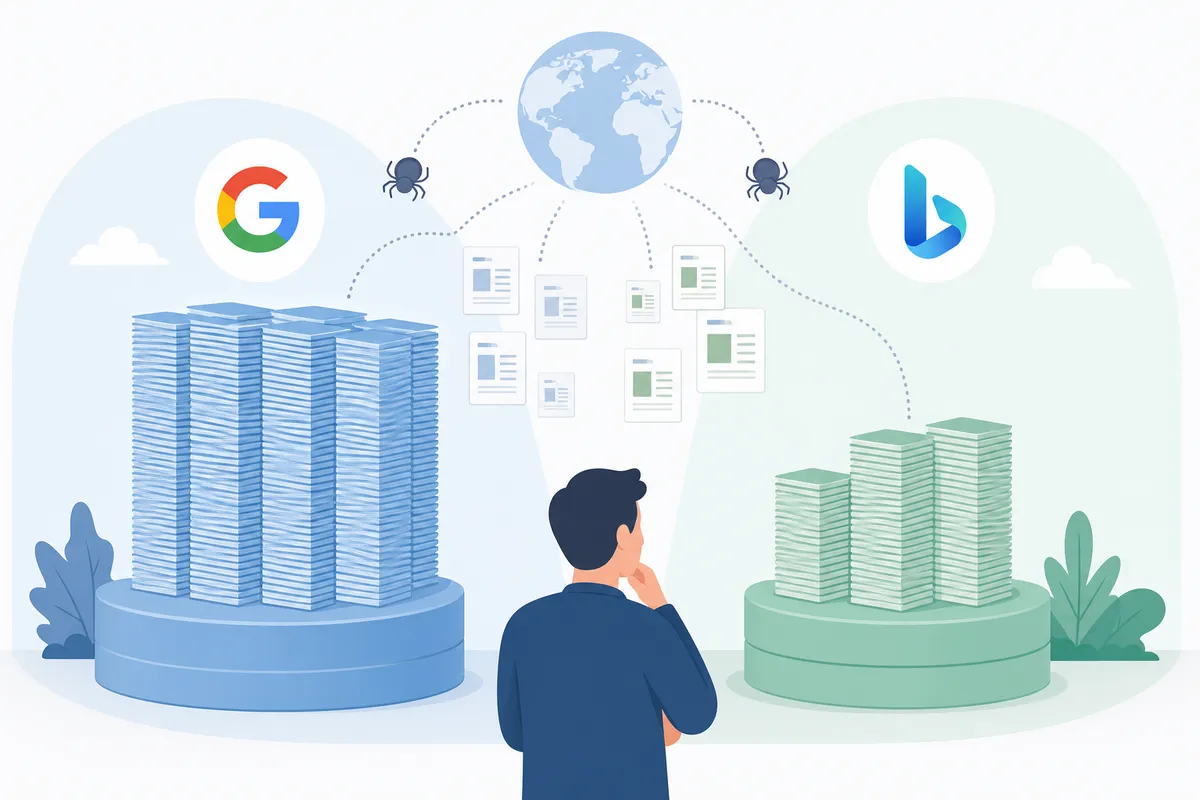
A própria explicação How Search Works, do Google, afirma que o índice contém centenas de bilhões de páginas da web e tem bem mais de 100.000.000 de gigabytes de tamanho total, construído por sistemas que rodam em data centers do mundo todo. O número varia, porque o Google já disse que o índice é reconstruído continuamente à medida que páginas são adicionadas, atualizadas ou removidas. Isso também ajuda a explicar por que uma página pode sair dele sem nenhuma ação do dono do site, como a seção de perguntas frequentes abaixo explica.
A Microsoft não divulga um número tão detalhado para o Bing. O próprio Webmaster Blog do Bing já descreveu o índice como tendo dezenas de bilhões de páginas, construído a partir do seu rastreador, o Bingbot, e de dados compartilhados por meio de parcerias. Essas parcerias incluem os dados de busca por trás dos resultados web do Yahoo e por trás dos resultados do DuckDuckGo nas buscas em que ele não depende do próprio rastreamento.
A diferença de escala é um dos motivos pelos quais uma página pode estar bem indexada no Bing e ainda assim faltar no Google, ou o contrário. Cada buscador tem o seu rastreador, os seus filtros de qualidade e o seu índice, então um diagnóstico que verifica apenas o Google Search Console pode deixar passar por completo um problema específico do Bing.
Por que a indexação em buscadores importa para o SEO
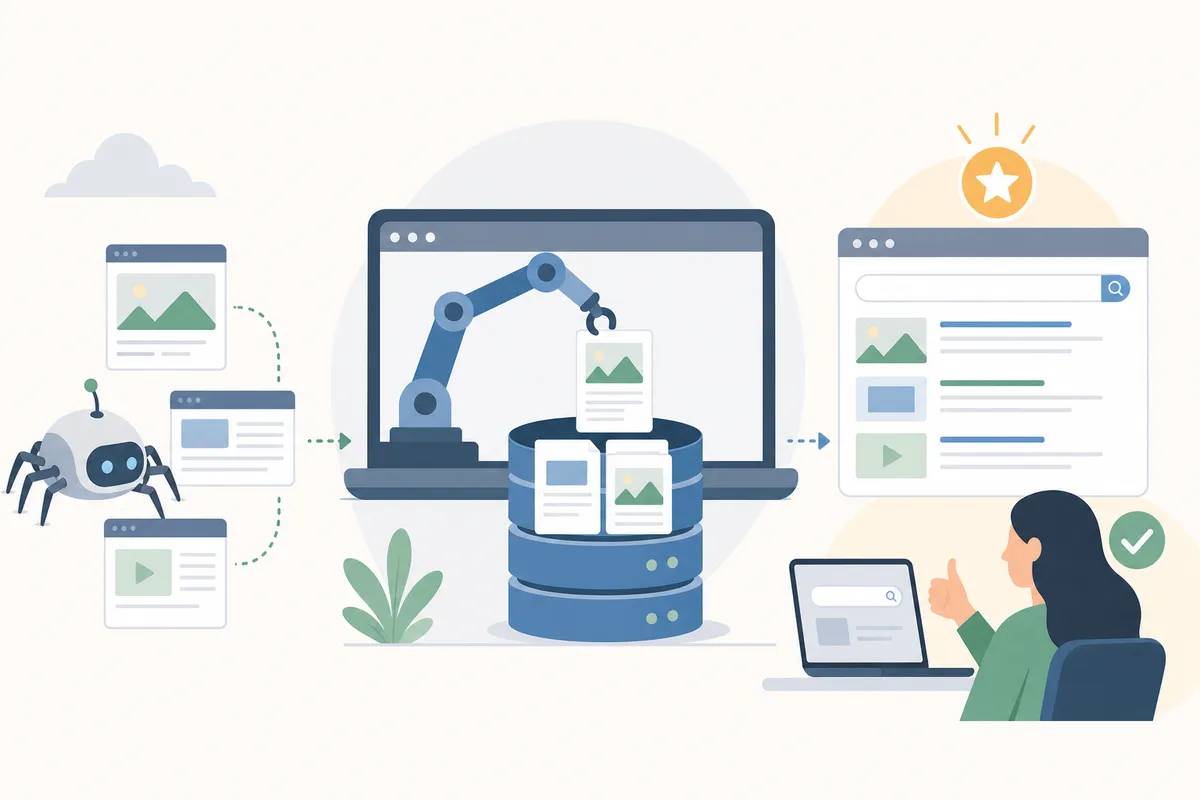
Se uma página não está indexada, ela tem chance zero de ranquear, de aparecer em uma AI Overview ou de gerar tráfego orgânico. Backlinks, segmentação por palavras-chave e qualidade do conteúdo só começam a render depois que a indexação acontece.
Isso faz dos problemas de indexação alguns dos erros mais caros em um site. Uma empresa pode passar semanas produzindo conteúdo e só perceber que ele está invisível para os buscadores quando alguém for conferir. O monitoramento do status de indexação deve andar junto com a produção de conteúdo, e não depois dela, e é por isso que um plano de ação de SEO estruturado para 90 dias costuma incluir uma verificação de indexação como um dos primeiros marcos.
A indexação também funciona como filtro de qualidade. O Google já disse com clareza que só adiciona ao índice páginas com valor genuíno, então páginas com excesso de palavras-chave, esquemas de links de baixa qualidade ou conteúdo raso e duplicado tendem a ser sinalizadas ou ignoradas. As core updates reavaliam periodicamente quais páginas de um site merecem continuar indexadas. Se uma grande parte das páginas de um site não atinge o padrão, o Google também pode reduzir o rastreamento e a indexação do restante do site, e é por isso que um punhado de páginas fracas pode prejudicar a visibilidade de um domínio inteiro.
Por que as páginas são ignoradas: motivos comuns para a indexação falhar
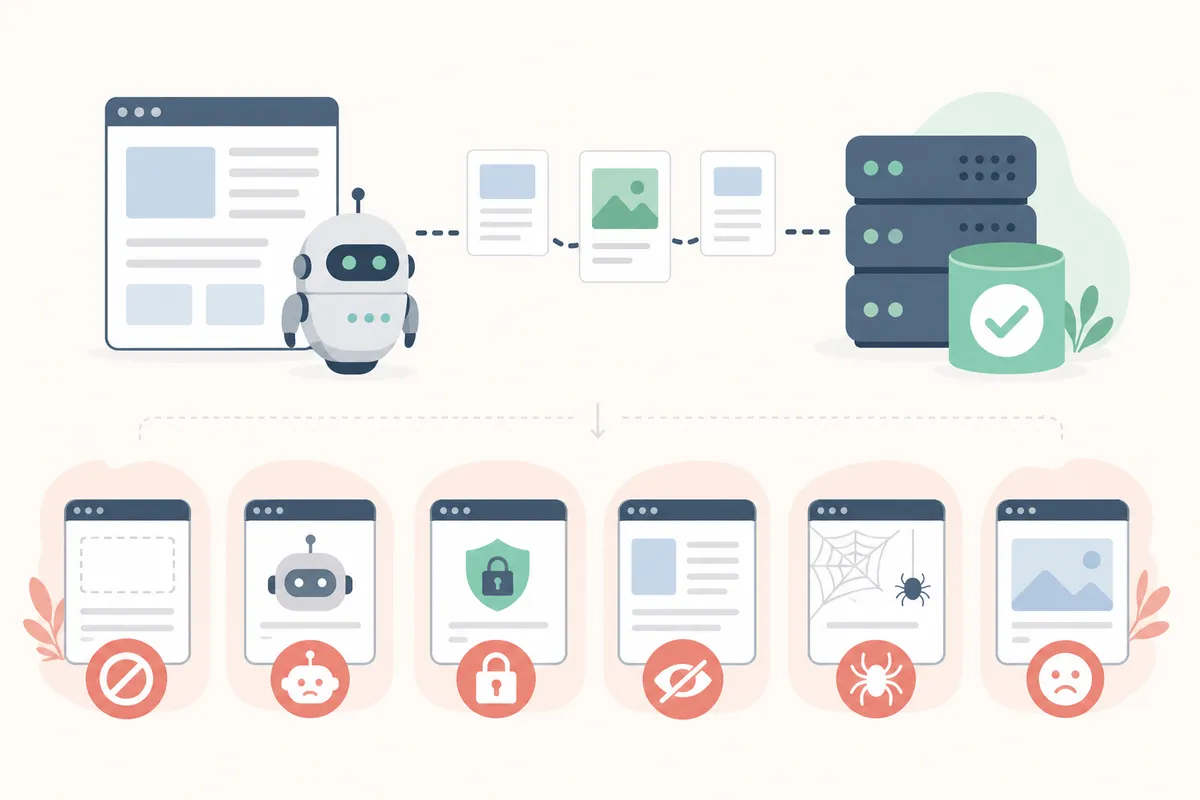
As páginas não são ignoradas de forma aleatória. Quase sempre há um motivo específico e diagnosticável, e a maioria cai em uma lista curta de causas recorrentes.
Conteúdo raso ou duplicado
Páginas com pouco valor único são o motivo mais comum para o Google decidir não indexar uma página. Páginas de produto curtas com texto do fabricante, páginas de localidades quase idênticas e filtros gerados automaticamente são exemplos típicos. O rastreador viu o conteúdo, mas o buscador decidiu que ele não valia ser armazenado separadamente.
Tags noindex e bloqueios no robots.txt
Uma meta tag ou um cabeçalho noindex diz diretamente ao buscador que ele não deve indexar a página. Isso é deixado em páginas por acidente o tempo todo, seja uma tag de site de homologação (staging) que não foi removida antes do lançamento, seja um padrão do CMS que aplica noindex em silêncio a certos tipos de página. Uma regra disallow no robots.txt tem um efeito parecido, mas diferente: ela pode bloquear o rastreamento por completo, o que impede a indexação por consequência. O protocolo de exclusão do robots.txt é mais do que uma convenção informal, já que a IETF o padronizou formalmente como RFC 9309 em 2022, e os rastreadores compatíveis, de diferentes buscadores, respeitam a mesma sintaxe de disallow.
Orçamento de rastreamento e tamanho do site
Os buscadores dedicam uma quantidade limitada de atenção de rastreamento a cada site, com base, em linhas gerais, no tamanho, na frequência de atualização e na saúde da resposta do servidor. Em sites muito grandes, páginas de baixo valor podem consumir o orçamento de rastreamento que deveria ir para as páginas que você realmente quer indexadas, de modo que algumas páginas acabam sendo rastreadas raramente ou nunca.
Páginas com muito JavaScript e aplicativos de página única
Os buscadores conseguem renderizar JavaScript, mas é uma etapa mais lenta e que consome mais recursos do que ler HTML simples, e nem sempre dá certo. Conteúdo que só aparece depois que o JavaScript do lado do cliente é executado, algo comum em aplicativos de página única (single-page applications), pode passar despercebido ou ser indexado tarde. É um modo de falha bem documentado, e por que os aplicativos de página única somem do Google explica a mecânica em detalhes.
Conflitos de canonicalização
Quando uma página tem uma tag canônica apontando para outra URL, de propósito ou por engano, o Google geralmente indexa a versão canônica em vez da que rastreou. Uma tag canônica mal configurada pode manter silenciosamente fora do índice uma página que, no mais, é boa, em favor da URL errada.
| Motivo para a página ser ignorada | Como aparece no Search Console | Correção típica |
|---|---|---|
| Conteúdo raso ou duplicado | "Duplicate, Google chose different canonical" ou "Crawled – currently not indexed" | Consolidar ou reescrever com conteúdo único e substancial |
| Tag noindex ou bloqueio no robots.txt | "Excluded by 'noindex' tag" ou "Blocked by robots.txt" | Remover a tag ou atualizar a regra disallow |
| Limites do orçamento de rastreamento (sites grandes) | "Discovered – currently not indexed" | Podar páginas de baixo valor; melhorar os links internos para as páginas prioritárias |
| Falhas de renderização de JavaScript | Conteúdo ausente na versão em cache/renderizada | Renderizar no servidor ou pré-renderizar o conteúdo principal |
| Conflitos de canonicalização | "Alternate page with proper canonical tag" | Corrigir ou remover tags canônicas incorretas |
A maioria desses casos remonta aos fundamentos de SEO técnico, e não apenas à qualidade do conteúdo. Se você vê um padrão de exclusões em muitas páginas, passe por as correções de SEO técnico que realmente movem seus rankings antes de presumir que o problema é o conteúdo.
Um exemplo prático: acompanhando uma página da publicação até o índice
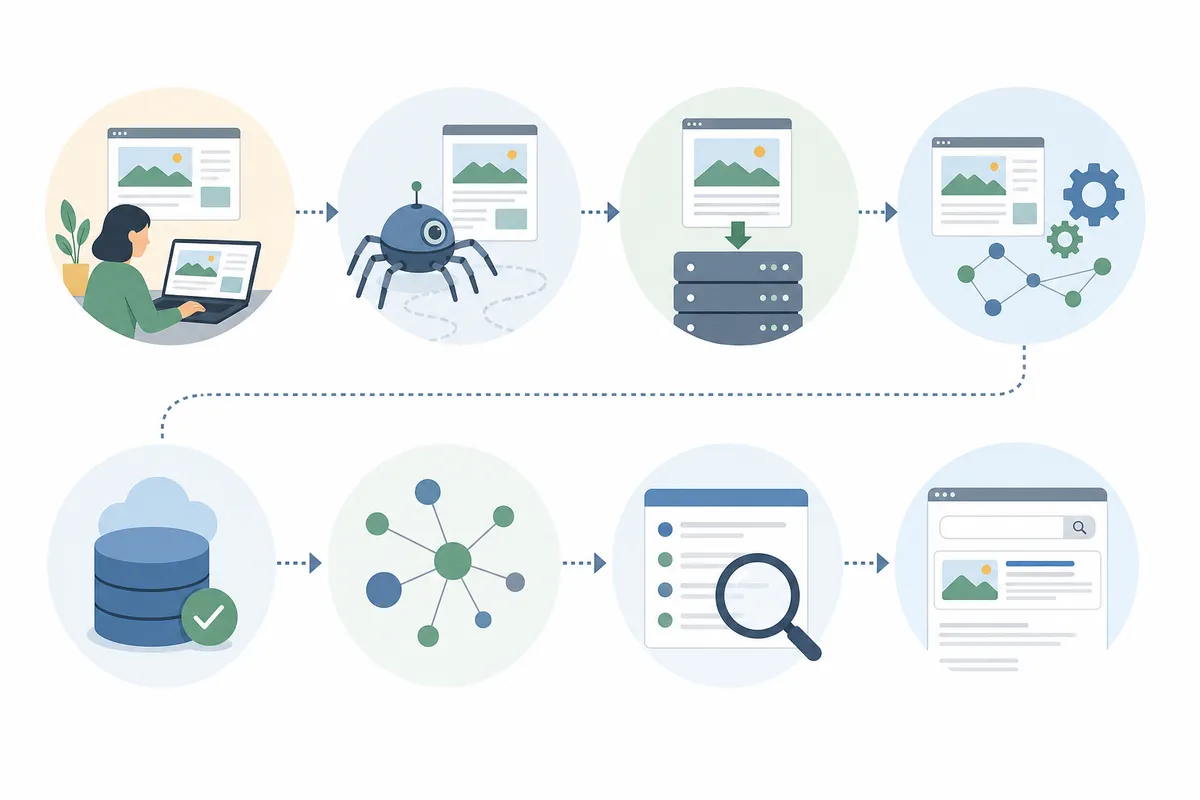
Esta é uma sequência realista para um novo post de blog em um site consolidado, com bom histórico de rastreamento, descrita com ações concretas em vez de tratar a indexação como uma caixa-preta.
- Dia 0: a página é publicada. O sitemap XML do site é regenerado automaticamente, então a nova URL é adicionada ao arquivo do sitemap em poucos minutos.
- Dia 0-1: outras páginas já têm links internos para o novo post e o sitemap foi atualizado, então o Googlebot descobre a URL no próximo rastreamento programado do sitemap, normalmente em até um dia para um domínio consolidado.
- Dia 1-3: o Googlebot rastreia e renderiza a página. A ferramenta Inspeção de URL (URL Inspection) do Search Console, consultada manualmente no dia 2, ainda não mostra "URL is on Google", mas um rastreamento já foi registrado.
- Dia 3-7: a página é avaliada quanto à singularidade e à qualidade em comparação com o restante do conteúdo do site. Se passar, é adicionada ao índice, e o relatório de Cobertura (Coverage), por volta do dia 5-7, normalmente mostraria a URL passando de "Discovered – currently not indexed" (se ela chegou a aparecer ali) para "Indexed".
- Dia 7 em diante: a página pode aparecer nos resultados de busca e começa a competir. Conquistar rankings relevantes para um termo concorrido pode levar bem mais tempo, mas isso pertence à etapa de ranqueamento, que funciona independentemente da indexação.
Agora considere um domínio novinho, sem backlinks e sem histórico de rastreamento. A mesma página pode nem ser descoberta até que um sitemap seja enviado manualmente pelo Search Console, já que o Googlebot não tem um padrão de rastreamento estabelecido a seguir nem autoridade de links internos puxando a página. Depois de descoberta, a janela entre o rastreamento e o índice pode se estender de dias a várias semanas, e a orientação do próprio Google reconhece que sites novos geralmente demoram mais para ser rastreados e indexados de forma consistente do que sites com histórico consolidado.
A diferença entre os dois cenários não está no conteúdo, e sim em tudo ao redor dele: atualização do sitemap, links internos e histórico de rastreamento do domínio. É por isso que a mesma correção, como solicitar a indexação pela Inspeção de URL, produz um resultado no mesmo dia em um site e quase nada em outro. A ferramenta apenas dá um empurrão na fila; ela não anula os sinais em que a decisão do índice se baseia.
Dá para corrigir problemas de indexação por conta própria?
Sim, na maioria dos casos comuns. Remover uma tag noindex acidental, corrigir uma regra do robots.txt, enviar um sitemap ou solicitar a indexação de uma única URL pelo Google Search Console são tarefas que o dono de um site pode fazer sem ajuda especializada, em geral em menos de uma hora.
O diagnóstico é mais difícil do que a execução. A correção para "Crawled – currently not indexed" pode ser uma reescrita de conteúdo, uma correção de canônica, uma mudança nos links internos ou um problema de orçamento de rastreamento, e o Search Console nem sempre diz qual se aplica. Ler o relatório de cobertura corretamente, e saber quais motivos de exclusão são urgentes e quais são esperados, exige alguma familiaridade com a forma como as decisões de indexação são tomadas.
Uma abordagem razoável é resolver primeiro as correções mecânicas: tags noindex, robots.txt e envio de sitemap. Se, depois de algumas semanas, as páginas continuarem sem indexação e sem causa óbvia, uma auditoria de SEO técnico mais profunda se paga.
Como fazer suas páginas serem indexadas mais rápido
Nenhum desses métodos obriga um buscador a indexar uma página de baixa qualidade, já que essa decisão continua dependendo de sinais de conteúdo e técnicos. O que eles fazem é encurtar o intervalo entre a publicação e a descoberta, o que importa muito para conteúdo sensível ao tempo.
Sitemaps XML
Um sitemap XML é um arquivo que lista todas as URLs do seu site que você quer que os buscadores conheçam. Ele funciona como um mapa para os rastreadores, apontando páginas que eles poderiam deixar passar, principalmente em sites grandes ou com estrutura muito profunda. Enviar um sitemap não garante a indexação, mas elimina o problema de "o rastreador nunca encontrou esta página".
Para enviar um sitemap no Google Search Console, abra o relatório Sitemaps, clique em "Add a new sitemap", informe a URL do sitemap (geralmente seusite.com/sitemap.xml) e envie. O Bing Webmaster Tools tem uma seção Sitemaps equivalente, com basicamente o mesmo fluxo.
Ferramenta Inspeção de URL do Google Search Console
Para uma única página que precisa de atenção agora, a ferramenta Inspeção de URL permite verificar o status de indexação de uma URL específica e solicitar um rastreamento diretamente. Cole a URL, revise os problemas apontados e, se nada estiver bloqueando a página, solicite a indexação na hora.
Use-a para casos como "acabei de corrigir uma tag noindex e quero que o Google perceba rápido". Ela não foi pensada para o envio em lote de centenas de URLs.
Indexing API do Google
A Indexing API do Google permite avisar o Google, de forma programática, sobre URLs novas ou atualizadas, sem esperar o rastreamento do sitemap nem uma solicitação manual de Inspeção de URL. O Google a posiciona como mais útil para sites com conteúdo de curta duração, como vagas de emprego, páginas de transmissões ao vivo e listagens de eventos, em que a velocidade importa mais do que a cobertura.
A configuração exige criar um projeto no Google Cloud e uma conta de serviço, verificar a propriedade no Search Console e gerar um token de acesso, o que é um esforço bem mais técnico do que um sitemap. O Google ainda recomenda enviar também um sitemap completo, porque a API é um complemento, e não uma substituição.
Bing Webmaster Tools e IndexNow
O Bing Webmaster Tools inclui um recurso próprio de envio de URLs, que permite enviar até 10.000 URLs por dia para rastreamento e avaliação quase imediatos. As páginas que atendem ao padrão de qualidade do Bing podem aparecer nos resultados pouco depois do envio.
O Bing também apoia o IndexNow, um protocolo que permite a um site avisar os buscadores no instante em que uma página é publicada, atualizada ou excluída, em vez de esperar o próximo rastreamento programado. Como os buscadores participantes compartilham o protocolo, um único envio pode notificar mais de um deles. A Microsoft descreveu o IndexNow como uma iniciativa conjunta que desenvolveu com o Yandex, criada para reduzir o rastreamento repetido e especulativo em que os dois buscadores, de outro modo, se apoiam para perceber que uma página mudou.
Links internos e backlinks
Uma página com links vindos de outras páginas do seu site, sobretudo páginas que os rastreadores já visitam com frequência, é mais fácil de encontrar e sinaliza que vale a pena revisitá-la. Páginas órfãs, sem nenhum link interno apontando para elas, estão entre as mais lentas para serem indexadas. Corrigir lacunas nos links internos costuma ter mais efeito do que qualquer ferramenta de envio, porque é um sinal permanente, e não um aviso pontual.
Os backlinks externos também ajudam, já que um rastreador que segue um link de outro site é uma das formas originais de descobrir páginas novas. Os sinais sociais podem, às vezes, acelerar a descoberta de forma indireta, quando um link compartilhado é clicado, rastreado ou repassado, mas não são um mecanismo direto de indexação como são um sitemap ou a Indexing API.
| Método | Buscador(es) | Melhor uso | Limite prático | Velocidade típica |
|---|---|---|---|---|
| Sitemap XML | Google, Bing | Cobertura do site inteiro, descoberta contínua | Um único envio cobre o site todo | Dias, revisitado conforme o cronograma de rastreamento |
| Ferramenta Inspeção de URL | Uma única página urgente | Uma URL por vez | De horas a alguns dias | |
| Indexing API | Google (oficialmente para conteúdo de vagas/transmissões ao vivo) | Páginas de curta duração e que mudam com frequência | Cota diária por projeto | Quase imediata depois de configurada |
| Envio de URLs do Bing | Bing | Envio em lote de páginas novas/atualizadas | Até 10.000 URLs por dia | Avaliação quase imediata |
| IndexNow | Bing e buscadores participantes | Notificação instantânea ao publicar/atualizar/excluir | Nenhum limite diário fixo informado | Aviso quase imediato |
Como verificar se suas páginas estão indexadas
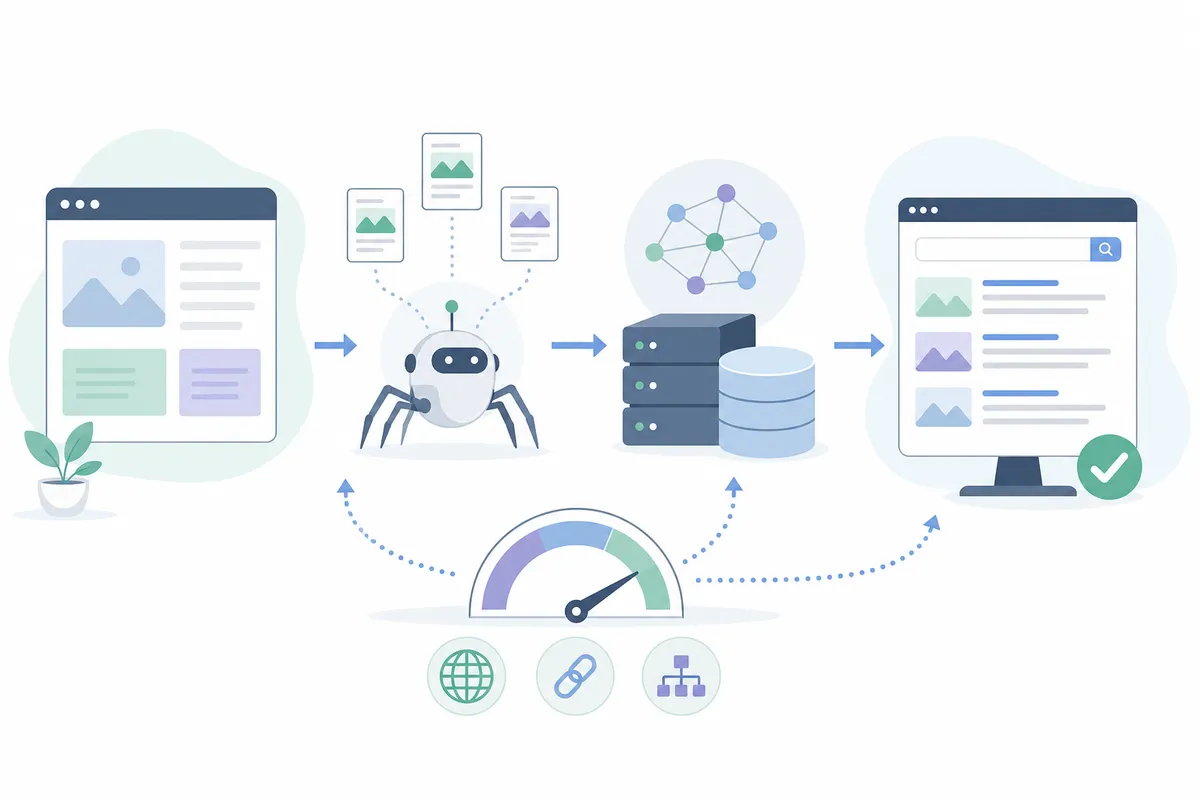
Antes de corrigir um problema de indexação, confirme que ele existe. Alguns métodos são confiáveis.
- O relatório de Cobertura/Indexação do Google Search Console mostra quais URLs estão indexadas, quais foram excluídas e o motivo específico de cada exclusão. É a fonte de verdade mais precisa para o Google.
- O operador de busca
site:(digitarsite:seudominio.com/url-da-paginano Google) oferece uma verificação rápida e aproximada, embora seja conhecido por ser impreciso para contagens exatas. - O Bing Webmaster Tools tem o seu próprio relatório de cobertura do índice, paralelo ao do Google, para o status específico no Bing.
- A ferramenta Inspeção de URL dá uma resposta definitiva, por página, para o Google, incluindo a data do último rastreamento e quaisquer problemas detectados.
Faça a verificação com regularidade, e não só uma vez após o lançamento. As páginas podem sair do índice depois por causa de uma reformulação do site, de uma tag noindex acidental introduzida em uma atualização de template ou de uma core update que reavalia a qualidade do conteúdo em todo o site.
Google vs. Bing vs. DuckDuckGo: como a indexação difere em cada buscador
Nem todo buscador indexa a web da mesma forma, e as diferenças afetam o modo como você diagnosticaria uma página ausente.
| Buscador | Rastreador próprio | Índice próprio | Velocidade típica de descoberta | Principal ferramenta de envio |
|---|---|---|---|---|
| Googlebot | Sim, centenas de bilhões de páginas segundo números do próprio Google | De horas a semanas, conforme a autoridade do site | Search Console (sitemaps, Inspeção de URL, Indexing API) | |
| Bing | Bingbot | Sim, dezenas de bilhões de páginas segundo números do próprio Bing | Faixa parecida com a do Google, muitas vezes mais rápida para sites pequenos via IndexNow | Bing Webmaster Tools, IndexNow |
| DuckDuckGo | Limitado (DuckDuckBot) | Parcial; combina o rastreamento próprio com resultados licenciados do Bing | Depende da fonte subjacente que exibir a página | Nenhuma ferramenta de envio dedicada para a maioria dos resultados |
O Google e o Bing mantêm, desde a base, sistemas de rastreamento e índice em larga escala, então as correções deste guia, como sitemaps, auditorias de noindex e IndexNow, valem para ambos, com apenas pequenas diferenças de ferramenta. O DuckDuckGo é um caso diferente. Ele já disse publicamente que obtém grande parte dos seus resultados web do índice do Bing, em vez de rastrear a web inteira de forma independente, além do rastreador próprio e de centenas de outras fontes. Uma página indexada e ranqueando no Bing tem, portanto, muito mais chance de aparecer no DuckDuckGo do que uma página indexada apenas no Google, e não existe um equivalente do Search Console no DuckDuckGo para verificar o status diretamente.
Se um negócio depende de visibilidade em vários buscadores, confirmar que uma página está indexada no Bing cobre mais terreno do que parece, já que esse único índice alimenta mais de uma página de resultados. Verificar apenas site:seudominio.com no Google e presumir que o quadro é o mesmo em todo lugar é um ponto cego comum.
Quando buscar ajuda profissional com a indexação
A maioria dos problemas de indexação pontuais pode ser resolvida sem ajuda externa. Procure apoio profissional quando o padrão for mais amplo do que uma página: grandes partes do site presas em "Discovered – currently not indexed", uma migração que derrubou a indexação do site inteiro ou um framework de JavaScript que os rastreadores nunca renderizaram direito.
Essas situações geralmente exigem alguém que saiba ler logs do servidor, comparar o HTML renderizado de fato com o que o rastreador enxerga e rastrear o problema por uma pilha de causas possíveis em vez de uma única causa óbvia. Se você publica conteúdo novo com regularidade e quer que ele já nasça bem estruturado e indexável, veja como o seu processo lida com a criação de conteúdo de SEO que ranqueia antes que o problema se multiplique por dezenas de páginas.
Perguntas frequentes
Qual é a diferença entre rastreamento e indexação?
Rastrear é um bot descobrir e visitar uma página. Indexar é o buscador decidir armazenar o conteúdo dessa página no seu banco de dados. Uma página pode ser rastreada sem nunca ser indexada.
Quanto tempo leva a indexação em buscadores?
Varia muito: de minutos, para um site consolidado e rastreado com frequência que use a Indexing API ou o IndexNow, a várias semanas, para um site novo com poucos links internos ou externos apontando para suas páginas.
Por que o Google rastrearia minha página, mas não a indexaria?
Isso geralmente significa que o Google considerou o conteúdo raso demais, parecido demais com outra página que ele já tem ou mais bem representado por outra URL canônica. Bloqueios técnicos, como tags noindex, também podem causar isso.
Enviar um sitemap garante a indexação?
Não. Um sitemap só ajuda os buscadores a descobrir uma URL mais rápido. Ela ser indexada ou não ainda depende da qualidade do conteúdo e de sinais técnicos, como tags noindex ou canonicalização.
Uma página pode perder o status de indexada depois de ter sido indexada uma vez?
Sim. As páginas podem ser removidas do índice depois por causa de mudanças de conteúdo, tags noindex acidentais, migrações de site ou uma reavaliação durante uma core update do algoritmo.
O Google indexa PDFs, imagens e vídeos da mesma forma que páginas da web?
Sim, com diferenças. O Google consegue indexar PDFs e extrair o texto deles. Google e Bing indexam imagens e vídeos por meio de sinais como texto alternativo, nomes de arquivo e o conteúdo da página ao redor, como descreve a própria documentação do Google sobre indexação de imagens e vídeos, e não por entender visualmente o arquivo da forma como interpretam o texto em HTML.
Quantas páginas o índice do Google realmente contém?
A página How Search Works, do Google, afirma que o índice contém centenas de bilhões de páginas da web. O Google não divulga uma contagem exata e atualizada continuamente, porque o número muda à medida que páginas são adicionadas e removidas.
Existe uma forma de ver o total de páginas indexadas do meu site?
O relatório Páginas (Pages), na seção Indexação do Google Search Console, é a contagem mais confiável para o seu próprio site, dividida em URLs indexadas e não indexadas, com um motivo para cada exclusão. O operador site: dá uma estimativa pública aproximada, mas o Google já alertou que ele não é preciso para contagens exatas.
Faça o diagnóstico dos seus problemas de indexação
A indexação em buscadores é o portão que toda página precisa atravessar antes de poder ranquear, e a maioria dos sites tem pelo menos algumas páginas silenciosamente presas atrás dele. A forma mais rápida de descobrir onde isso acontece no seu próprio site é ver seus dados reais de indexação e de ranqueamento em um só lugar. Fale com a equipe e receba um relatório de amostra que mostra quais das suas páginas estão indexadas, quais estão em risco e o que vale corrigir primeiro.
Leitura relacionada: Discourage Search Engines From Indexing This Site: A Setup Guide.
Leitura relacionada: "Discovered – Currently Not Indexed": What It Means and How to Fix It.
Leitura relacionada: SEO for News Sites: How to Get Articles Indexed and Ranking Fast.
Leitura relacionada: How to Get Google to Crawl My Site: A Step-by-Step Fix.
Fontes
Sobre o autor
O SearchBlueprint pesquisou, escreveu e avaliou este artigo com o mesmo pipeline de conteúdo que nossos clientes usam nos próprios sites. A nota que aparece na assinatura é a que nosso mecanismo de conteúdo deu a esta página antes de ela ser publicada. Nada aqui passa por revisão manual, e esse é justamente o ponto: é o resultado do produto, publicado onde qualquer pessoa pode conferir.