"Discovered – Currently Not Indexed": o que significa e como corrigir
Por Toy Wen Da, Cofundador · Atualizado em · 5 min de leitura
Traduzido do original em inglês. Ler em inglês
Se o Google Search Console mostra "discovered currently not indexed" ao lado de uma URL, o Googlebot sabe que a página existe, mas ainda não a rastreou. Ele não leu seu texto, seus títulos nem suas imagens, porque a página ainda está esperando em uma fila. Isso muda a forma de corrigir o problema, já que nada sobre a qualidade da página foi avaliado.
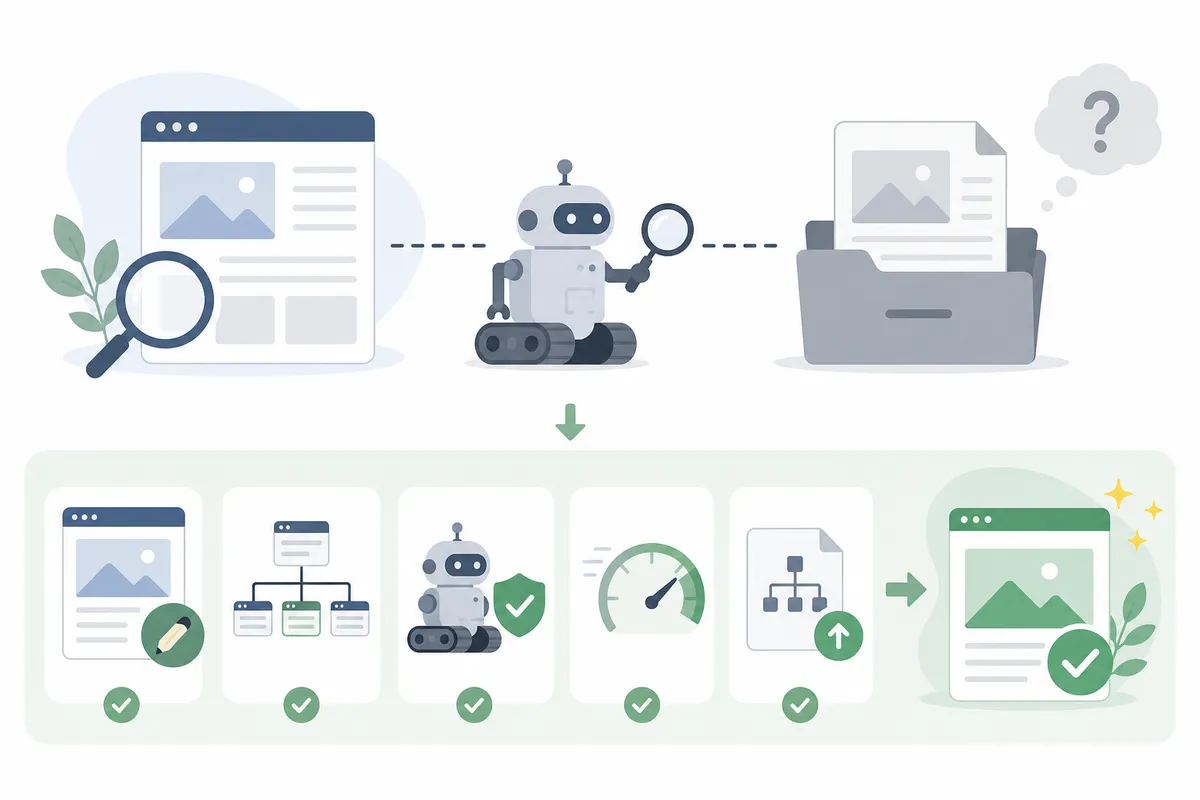
Discovered x crawled x noindex
As pessoas misturam esses status, mas cada um aponta para uma correção diferente, e confundi-los faz você perder tempo.
| Status | O que o Googlebot fez | Causa provável | O que realmente resolve |
|---|---|---|---|
| Discovered – currently not indexed | Colocou a URL na fila, mas não a buscou | Baixa prioridade de rastreamento, links internos fracos, site grande disputando orçamento de rastreamento | Links internos vindos de páginas rastreadas com frequência, limpeza do sitemap |
| Crawled – currently not indexed | Buscou e leu a página, mas decidiu não indexá-la | Conteúdo raso, duplicação, conflitos de canonical | Acrescentar valor único, corrigir as tags canonical |
| Noindex detected | Buscou a página e encontrou uma diretiva noindex | Uma tag de plugin ou de template | Remover a tag noindex e depois solicitar um novo rastreamento |
Se o seu status é "discovered", reescrever a página ainda não vai ajudar, porque o Google não a leu. É o erro mais comum entre donos de site.
Por que as páginas ficam presas em "discovered"
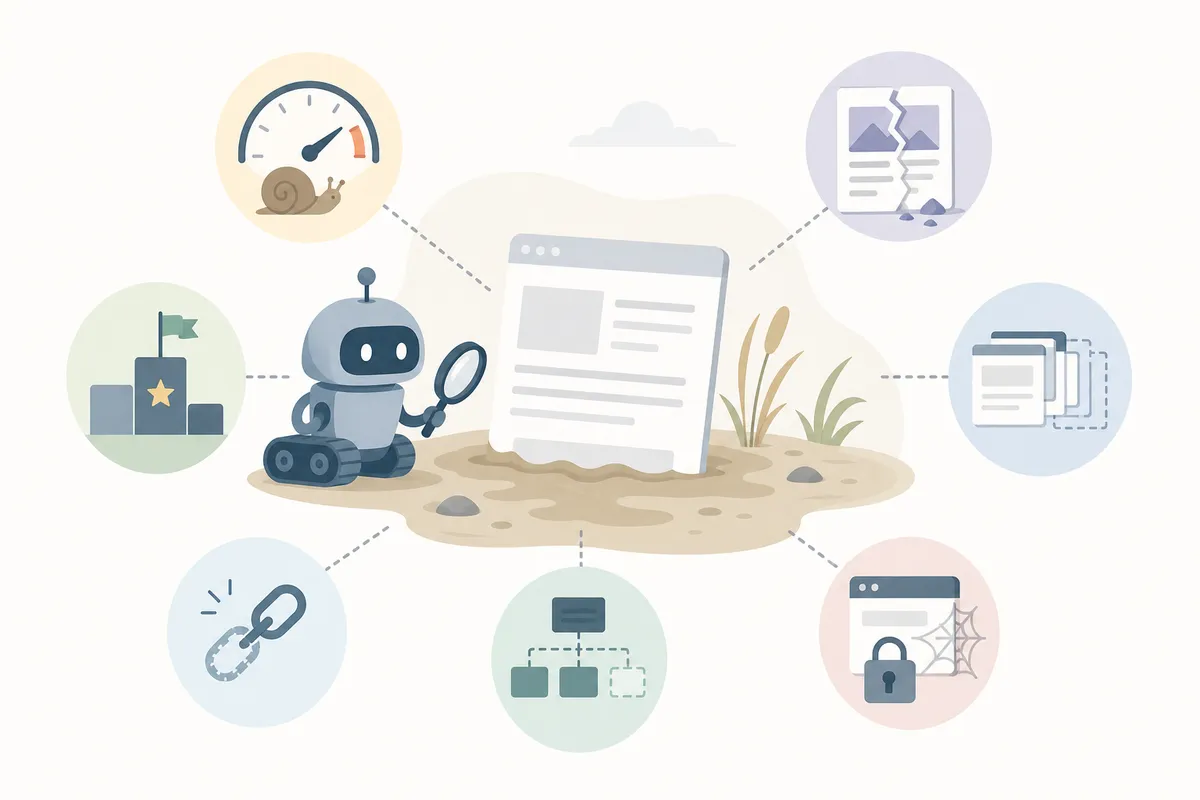
Algumas condições empurram uma URL para essa espera:
- Baixa demanda de rastreamento. Sites grandes ou novos disputam um orçamento de rastreamento limitado, e o Google dá menos prioridade a páginas que não parecem urgentes.
- Falta de links internos fortes. Uma página órfã, ou linkada apenas por posts com pouco tráfego, sinaliza baixa importância.
- Ruído no sitemap. Se o seu sitemap lista milhares de URLs rasas ou desatualizadas, o Google confia menos nele e o rastreia mais devagar.
- Problemas de resposta do servidor. Respostas lentas ou erros intermitentes durante as visitas do Googlebot podem fazê-lo recuar.
A documentação do Google Search Console descreve os status do relatório de indexação de páginas e confirma que "discovered" significa que a URL foi encontrada, mas ainda não foi buscada (Google Search Console Help).
Como corrigir o discovered currently not indexed, em ordem
Siga estas etapas em sequência. Quem parte direto para mudanças no conteúdo sem descartar problemas de acesso costuma continuar travado.
Etapa 1: descarte bloqueios de acesso
Verifique no robots.txt se há uma regra Disallow cobrindo a página e use a ferramenta de inspeção de URL para confirmar que "Indexing allowed" aparece como sim. Um bloqueio total é o único caso em que a solicitação de indexação realmente não ajuda, porque o Googlebot não consegue acessar a página.
Etapa 2: reforce os links internos
Em geral, é a correção que traz o maior retorno. Linke a página travada a partir de páginas que o Google já rastreia com frequência, como a página inicial, um post de muito tráfego ou uma página hub, e a nova URL entra no mesmo ciclo de rastreamento. Se você está montando uma estratégia de conteúdo mais ampla, em que as páginas se linkam com propósito em vez de aleatoriamente, o roteiro da estratégia de busca zero-click mostra como estruturar o conteúdo para ganhar prioridade de rastreamento e citações.
Etapa 3: limpe o sitemap
Remova do sitemap as URLs rasas, redirecionadas ou com noindex. Um sitemap cheio de páginas de baixo valor reduz a confiança nas boas.
Etapa 4: use a solicitação de indexação uma única vez
Depois de concluir o que vimos acima, solicite a indexação da URL específica no Search Console. Isso não força a indexação por si só, mas empurra a página para uma posição melhor na fila de rastreamento quando os bloqueios reais já foram eliminados.
Dá para resolver sozinho?
Na maioria dos casos, sim. Verificar o robots.txt, limpar um sitemap e adicionar links internos são tarefas que o dono do site pode fazer sem um desenvolvedor. A coisa fica mais difícil quando é preciso diagnosticar por que uma seção inteira do site é cronicamente pouco rastreada, já que isso costuma apontar problemas de arquitetura ou de desempenho que merecem uma auditoria técnica. Se você também está decidindo quais páginas valem o esforço e quais aposentar, usar sinais de engajamento em vez de publicar mais conteúdo é uma boa forma de priorizar.
Perguntas frequentes
"Discovered currently not indexed" significa que minha página foi penalizada?
Não. O Googlebot simplesmente ainda não rastreou a página, e isso é uma decisão de agendamento e prioridade baseada no orçamento de rastreamento e nos links internos.
Quanto tempo costuma levar para resolver?
Varia conforme o tamanho e a autoridade do site, mas muitas páginas saem desse status em alguns dias a duas semanas, depois que os problemas de links internos e de sitemap são tratados.
Backlinks resolvem uma página em discovered currently not indexed?
Backlinks externos podem ajudar ao gerar tráfego e sinais de referência, mas raramente são a correção principal. Links internos fortes vindos de páginas que o Google já rastreia com frequência tendem a funcionar mais rápido.
Devo clicar em "Request Indexing" todo dia?
Não. Solicitações repetidas sem corrigir a causa de fundo não ajudam e podem parecer comportamento de spam. Corrija primeiro os problemas de acesso e de links, e só então solicite uma vez.
Isso é o mesmo que uma tag noindex?
Não. O Google precisa rastrear a página antes de poder respeitar uma tag noindex, então isso aparece como "crawled", não como "discovered". Já um bloqueio real no robots.txt impede a busca por completo e mantém a página em "discovered" por tempo indeterminado.
Tenha uma visão clara do status de indexação
Ficar no palpite sobre quais páginas estão travadas e por quê faz você perder um tempo que não tem. Fale com a equipe e receba um exemplo de relatório de SEO que mostra exatamente quais URLs estão em discovered currently not indexed, por quê, e o que corrigir primeiro.
Leia também: Crawled – Currently Not Indexed? Here's the Real Fix.
Fontes
Sobre o autor
O SearchBlueprint pesquisou, escreveu e avaliou este artigo com o mesmo pipeline de conteúdo que nossos clientes usam nos próprios sites. A nota que aparece na assinatura é a que nosso mecanismo de conteúdo deu a esta página antes de ela ser publicada. Nada aqui passa por revisão manual, e esse é justamente o ponto: é o resultado do produto, publicado onde qualquer pessoa pode conferir.