¿«Rastreada: actualmente sin indexar»? Esta es la solución real
Por Toy Wen Da, Cofundador · · 12 min de lectura
Traducido del original en inglés. Léelo en inglés
«Rastreada: actualmente sin indexar» (Crawled – currently not indexed) significa que Googlebot abrió tu página, pero decidió no añadirla todavía a los resultados de búsqueda. Suele deberse a contenido escaso o duplicado, a una red de enlaces internos débil o a señales que hacen que la página parezca poco prioritaria. Esta guía cubre las tres causas y sus soluciones.
Qué significa realmente «Rastreada: actualmente sin indexar»
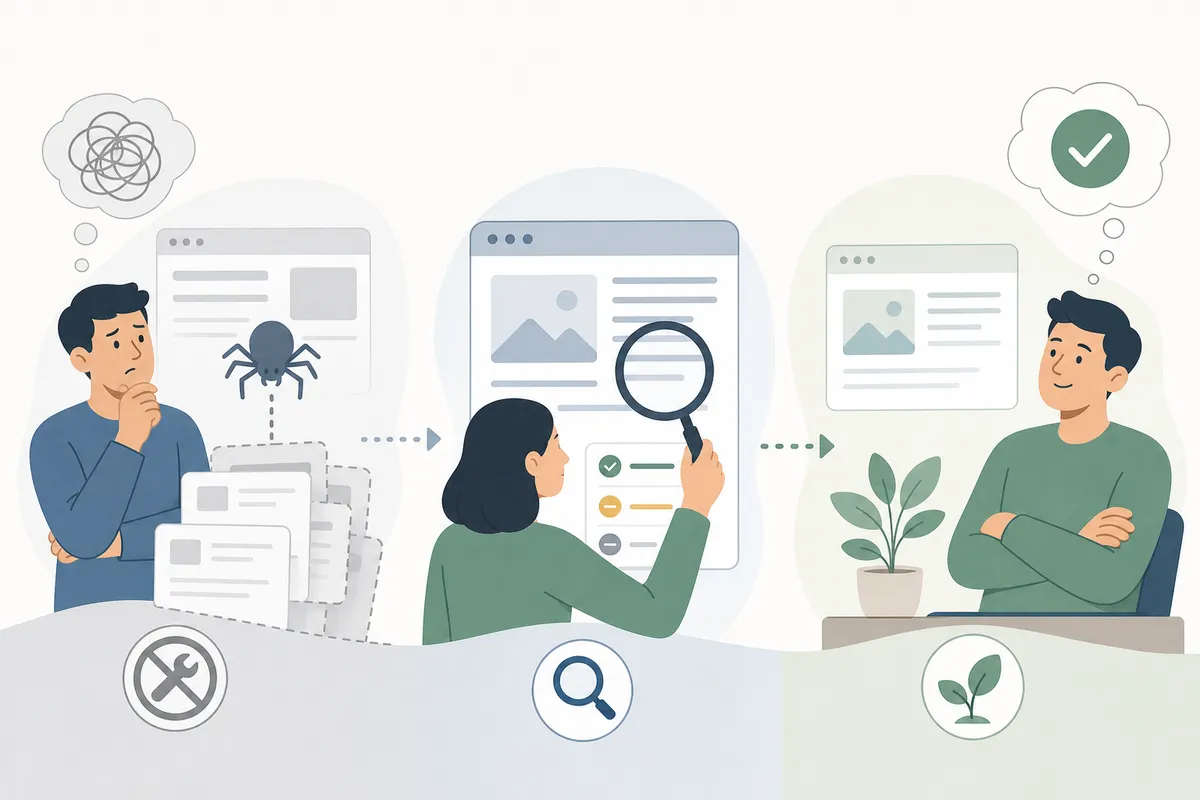
Cuando el informe de indexación de páginas (Page Indexing) de Google Search Console marca una URL como «Rastreada: actualmente sin indexar», te dice algo muy concreto. Googlebot descubrió la página, la descargó y la renderizó. Pero decidió no guardarla en el índice del que salen los resultados de búsqueda. La página existe en tu servidor y Google la ha leído. Simplemente no puede aparecer cuando alguien busca.
Eso es distinto de una página a la que Google aún no ha llegado, y distinto de una página que le has indicado expresamente que omita. «Rastreada, actualmente sin indexar» está en un punto intermedio: Google echó un vistazo y respondió «todavía no» o «esta no».
En qué se diferencia de otros estados de no indexación
El informe de indexación de páginas agrupa las URL excluidas en varias categorías. No significan lo mismo ni requieren la misma respuesta.
| Estado | Qué significa | Causa habitual | Acción necesaria |
|---|---|---|---|
| Rastreada: actualmente sin indexar | Google rastreó la página, pero decidió no indexarla | Contenido escaso, enlaces débiles, poco valor percibido | Mejorar el contenido y los enlaces, y esperar |
| Descubierta: actualmente sin indexar (Discovered – currently not indexed) | Google sabe que la URL existe, pero aún no la ha rastreado | Límites del presupuesto de rastreo, baja prioridad en la cola | Mejorar los enlaces internos y tener paciencia |
| Excluida por la etiqueta «noindex» (Excluded by "noindex" tag) | Una metaetiqueta o una cabecera indicó a Google que no la indexara | Directiva noindex intencionada o accidental | Quitar la etiqueta si quieres que se indexe |
| Duplicate, Google chose different canonical | Google encontró contenido casi idéntico en otro sitio y eligió otra URL | Contenido duplicado o sindicado, falta de canonical | Definir una etiqueta canonical clara |
| Soft 404 | La página parece vacía o con error aunque devuelva un código de estado 200 | Falta de contenido, plantillas rotas | Arreglar la página o devolver un 404 real |
«Rastreada: actualmente sin indexar» es el estado que más frustra, porque no se está incumpliendo ninguna regla evidente. En la mayoría de los casos Google no bloquea la página a propósito. Está valorando si la página merece un lugar en el índice.
¿Es de verdad un problema? Compruébalo antes de arreglar nada
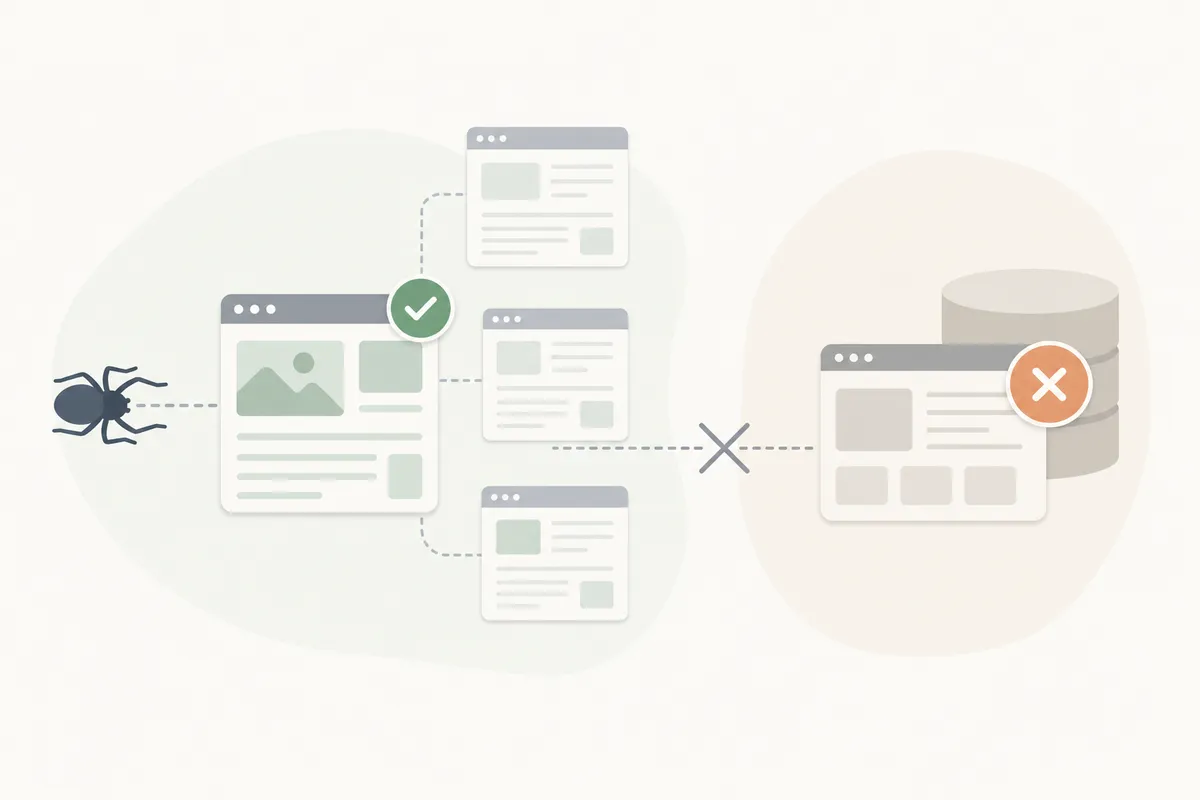
Antes de dedicar horas a las correcciones, confirma que el problema es real. El informe de indexación de páginas puede ir por detrás de la realidad, sobre todo en sitios grandes. Una URL marcada como no indexada puede estar ya en los resultados de búsqueda.
Haz una comprobación rápida:
- Abre la herramienta de inspección de URL (URL Inspection tool) de Search Console y mira la fecha de «Último rastreo» (last crawled). Una fecha antigua puede indicar que el estado no se ha actualizado.
- Busca
site:yourdomain.com/the-page-urldirectamente en Google. Si aparece, la página está indexada y el informe simplemente no se ha puesto al día. - Si hay decenas o cientos de URL afectadas, extráelas con la API de Search Console o con un rastreador como Screaming Frog. Después, contrástalas con los resultados de búsqueda reales de forma masiva, en lugar de una por una.
Si tras esa comprobación la página realmente no está indexada, pasa a decidir si debería estarlo.
Páginas que pueden quedarse rastreadas pero sin indexar
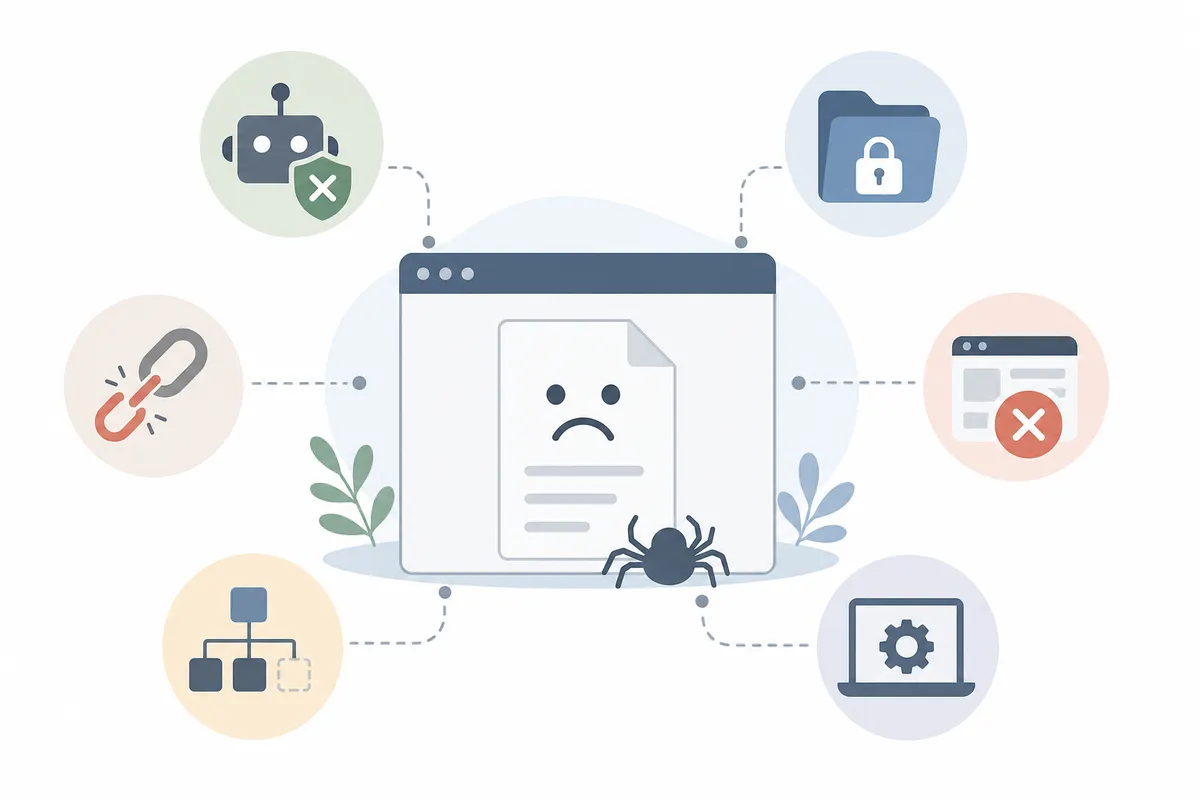
Una parte considerable de las páginas rastreadas pero sin indexar no necesita ningún arreglo. Google hace bien en dejarlas fuera. Revisa tu lista y separa las que no importan de las que sí.
| Tipo de página | Ejemplo | Por qué no pasa nada si no se indexa |
|---|---|---|
| Resultados de búsqueda internos | /search?q=blue-shoes |
Contenido casi duplicado, sin valor único para quien busca |
| URL con facetas o filtros | /products?color=red&size=m |
Variaciones de la misma página de catálogo; indexarlas malgasta presupuesto de rastreo |
| Archivos de etiquetas o categorías con poco contenido | /tag/summer2022 |
Duplican contenido que ya está disponible en otro sitio |
| Páginas de temporada caducadas | /temp/new-year-sale-2023 |
Dejan de ser relevantes cuando termina el evento o la promoción |
| Feeds RSS y sitemaps | /feed/latest-news, /sitemap.xml |
Están pensados para la sindicación y el descubrimiento, no para los resultados de búsqueda |
Si una página de este grupo te llena los informes de ruido, añade una etiqueta noindex. Así dejará de aparecer como un «problema». Es una tarea de limpieza, no una pelea por la indexación.
Causas comunes de las páginas rastreadas pero sin indexar
Para las páginas que de verdad deberían posicionar y no lo hacen, la causa casi siempre cae en un puñado de categorías. Revísalas en el orden en que aparecen con más frecuencia en las auditorías reales.
Contenido escaso o de poco valor
Es el motivo más común por el que páginas importantes se quedan en «rastreada pero sin indexar». Algunas auditorías señalan como riesgo de contenido escaso cualquier página de menos de unas 600 palabras. Pero el número de palabras por sí solo no es la prueba real. La pregunta que se hace Google es si la página aporta algo que quien busca no pueda obtener ya en una docena de resultados más.
El texto generado automáticamente y las descripciones de producto genéricas copiadas del feed de un fabricante entran en esta categoría. También las páginas que repiten un título en tres frases. Si publicas muchas páginas para «cubrir más palabras clave», más volumen sin más sustancia es justo lo que provoca este estado. Ese patrón se explica con más detalle en este análisis sobre una estrategia de contenido basada en el feedback en lugar del volumen de publicación.
Contenido duplicado o casi duplicado
Si los mismos párrafos aparecen en varias URL, algo habitual en páginas de ubicaciones, versiones para imprimir o artículos sindicados, Google indexa una versión. Deja el resto rastreadas pero sin indexar. Es el comportamiento esperado, no una penalización. Solo funciona bien si tus etiquetas canonical apuntan a la versión que de verdad quieres posicionar.
Sindicar contenido en otros sitios añade un riesgo relacionado. Si la copia republicada posiciona mejor o se indexa antes que el original, este puede acabar excluido. Esta guía sobre sindicación de contenido sin crearte problemas de duplicados explica cómo republicar sin perjudicar la indexación de la página original.
Enlaces internos débiles o inexistentes
Las páginas a las que no apunta ningún enlace interno, las páginas huérfanas, envían una señal débil de prioridad. Google puede rastrear una URL que encontró en un sitemap. Pero si nada de tu sitio enlaza a ella, hay pocos motivos para tratarla como importante. Una red de enlaces internos densa y lógica es una de las palancas más fiables para que se reconsidere una página atascada.
Presupuesto de rastreo y señales de calidad de todo el sitio
En los sitios grandes, el presupuesto de rastreo es limitado. Googlebot puede renderizar páginas de hasta unos 15 MB, pero no dedicará tiempo ilimitado a un sitio lleno de URL de poco valor. Si tu dominio tiene miles de páginas escasas o casi duplicadas, Google puede dar menos prioridad al rastreo y la indexación de las nuevas hasta que mejore la calidad. La canibalización de palabras clave, varias páginas que compiten por la misma consulta, agrava el problema. Google suele excluir todas las versiones que compiten en lugar de adivinar cuál posicionar.
Contenido obsoleto o desactualizado
Una página puede tener sustancia y aun así parecer anticuada si nada en ella ha cambiado en años. El contenido que fue útil en su día pero que nunca se revisa tiende a derivar hacia este estado. Competidores más recientes ocupan su lugar en el índice. Mantener actualizadas las páginas principales, sin reescribirlas, simplemente al día, es una de las formas más duraderas de evitar el purgatorio de «actualmente sin indexar». Este punto se desarrolla en por qué el contenido evergreen sigue acumulando resultados en lugar de apagarse tras un pico de tráfico.
Cómo corregir las páginas «Rastreada: actualmente sin indexar»
Cuando hayas confirmado que una página merece estar en el índice y hayas aislado la causa probable, aplica las correcciones por orden de prioridad. No todas pesan lo mismo, así que no dediques una semana a los enlaces internos si el problema real es el contenido escaso.
| Corrección | Qué soluciona | Esfuerzo habitual | Prioridad |
|---|---|---|---|
| Ampliar y reforzar el contenido | Páginas escasas o de poco valor | Medio-alto | Alta |
| Definir etiquetas canonical correctas | Contenido duplicado o casi duplicado | Bajo | Alta |
| Añadir enlaces internos desde páginas relevantes | Páginas huérfanas, señales débiles | Bajo-medio | Alta |
| Corregir robots.txt y las etiquetas meta robots | Bloqueo accidental o noindex | Bajo | Alta |
| Mejorar la velocidad de la página y la fiabilidad del renderizado | Páginas que agotan el tiempo o se renderizan de forma incompleta | Medio | Media |
| Consolidar páginas casi duplicadas | Canibalización de palabras clave | Medio | Media |
| Crear u obtener enlaces externos hacia la página | Baja autoridad percibida | Alto | Media |
| Solicitar indexación con la inspección de URL | Dar un empujón a Google tras una corrección real | Bajo | Baja |
Descarta primero los bloqueos técnicos
Abre el código fuente de la página y confirma que no hay una metaetiqueta noindex ni una cabecera X-Robots-Tag que no hayas puesto tú. Después, pasa la URL por el robots.txt Tester de Search Console para asegurarte de que nada en ese archivo bloquea la ruta. Estas comprobaciones llevan minutos y descartan la explicación más sencilla antes de dar por hecho que el fallo está en el contenido.
Reescribe o amplía el contenido
Si la página tiene poco contenido, no la rellenes con paja. Añade la información concreta que buscaba quien llegó a ella: detalle de precios, una comparación, un ejemplo práctico o una respuesta real a la pregunta. Las páginas construidas para satisfacer directamente la intención de búsqueda suelen salir de este estado antes que las pensadas para alcanzar un número de palabras. Para páginas de producto y de categoría, consulta estas prácticas de SEO para ecommerce centradas en lo que realmente genera ventas y no solo tráfico. Tratan las carencias de contenido que con más frecuencia mantienen atascadas aquí a las páginas de listados.
Mejora los enlaces internos y la estructura del sitio
Añade enlaces contextuales desde páginas que ya posicionan bien y comparten tema. Una página de producto sin ningún enlace interno que apunte a ella, por ejemplo, es una página huérfana de manual. Incluirla en una página de categoría, en un bloque de productos relacionados o en una entrada de blog relevante le da a Google un motivo para indexarla.
Configura una monitorización automática en lugar de reenviar a mano
Pulsar una y otra vez «Solicitar indexación» en Search Console no acelera nada y, si se abusa, puede marcar la URL para una revisión manual. Un enfoque mejor es montar un flujo de trabajo que compruebe el estado de indexación de forma periódica y señale las páginas atascadas más allá de un plazo razonable. Este repaso de flujos de automatización que publican correcciones en días y no en semanas explica cómo estructurar una monitorización continua como esta. Sustituye a las comprobaciones manuales y puntuales.
Trátalo también como un problema de visibilidad en IA
Una página que Google nunca indexa tampoco tiene opción de ser citada por los motores de respuestas de IA. La mayoría de esas herramientas se nutren en buena medida de la misma web rastreada e indexada. Si estás invirtiendo en contenido pensado para aparecer en AI Overviews, en las respuestas de Perplexity o en las de ChatGPT, pasar de «rastreada» a indexada importa. Llegar al índice es la primera puerta, no un paso opcional. Esta guía sobre cómo lograr que Perplexity te cite, y no solo que te rastree merece una lectura junto a tus correcciones de indexación. Más aún si la visibilidad en IA forma parte del objetivo. La misma lógica se aplica a las páginas de producto que alimentan respuestas de IA relacionadas con compras. Consulta este artículo sobre cómo conseguir que la búsqueda con IA cite tus productos de ecommerce en lugar de saltárselos.
¿Cuánto se tarda en indexar una página después de corregirla?
No hay un plazo fijo, pero un rango realista va de unos días a unas pocas semanas. Es lo que tarda Google en volver a rastrear y reconsiderar una página después de una corrección real de calidad. Los sitios más grandes o con menos autoridad tienden a acercarse al extremo largo. Google ha afirmado que reenviar una URL a través de Search Console no es necesario y no fuerza la indexación. Solo vuelve a poner la URL en la cola de rastreo un poco antes, según la propia documentación de ayuda de Search Console de Google.
Si una página sigue rastreada pero sin indexar más de un mes después de corregir el contenido y los enlaces, es una señal. El problema de fondo no se resolvió del todo, así que no te limites a seguir reenviándola.
El crecimiento que se obtiene al corregir problemas de indexación suele notarse de forma gradual en muchas páginas, no como un salto espectacular. Esto concuerda con cómo el crecimiento orgánico se acumula con una campaña bien planificada y no con un solo pico. Esperar que un único reenvío lo cambie todo crea una expectativa equivocada desde el principio.
Cómo evitar que este estado vuelva a aparecer
Arreglar el lote actual de páginas excluidas importa menos que frenar el patrón que las creó. Unos pocos hábitos evitan que la cifra vuelva a crecer:
- Publica menos páginas, pero más sólidas, en lugar de inundar el sitio con páginas escasas para perseguir volumen de palabras clave.
- Audita los enlaces internos cada trimestre para que las páginas nuevas nunca nazcan huérfanas.
- Mantén un calendario fijo de actualización de contenidos en lugar de dejar que las páginas antiguas se queden obsoletas y salgan del índice con el tiempo.
- Revisa el informe de indexación de páginas cada mes, no solo cuando algo parezca ir mal.
- Trata la salud de la indexación como un solo sistema, no como una serie de emergencias sin relación. Esa es la mentalidad que se explica en este marco para construir dominio del SEO como un sistema repetible y no perseguir trucos aislados.
Conviene recordar también que la indexación por sí sola no es la meta. Una página indexada en la que nadie hace clic ni que nadie cita sigue rindiendo por debajo de lo que podría. Esta hoja de ruta para conseguir citas en entornos de búsqueda sin clics, en lugar de perseguir solo los clics es una buena siguiente lectura. Échale un vistazo cuando tus cifras de indexación se estabilicen.
Cuándo conviene pedir ayuda externa
Imagina que ya has revisado la calidad del contenido, las etiquetas canonical, el robots.txt, las metaetiquetas y los enlaces internos. Las páginas siguen atascadas como «rastreada, actualmente sin indexar» después de varias semanas. La causa puede ser un problema de confianza o de presupuesto de rastreo que afecta a todo el sitio y que es más difícil de diagnosticar página por página. Entre los sospechosos habituales están una migración reciente, una gran entrada de páginas de baja calidad que diluye el dominio o señales técnicas incoherentes entre plantillas. Normalmente es el momento en que una auditoría técnica más completa se amortiza. Hazla con alguien que pueda ver el sitio entero y no una URL cada vez.
Preguntas frecuentes
¿«Rastreada: actualmente sin indexar» significa que mi página tiene un error?
No. Significa que Google rastreó la página correctamente y decidió no indexarla. Suele ser una decisión de calidad del contenido o de prioridad, no un error técnico. Un error de verdad aparecería normalmente como un estado 4xx, 5xx o soft 404.
¿Debo reenviar la URL en Search Console cada pocos días?
No. Google ha dicho que reenviarla no acelera ni fuerza la indexación. Hacerlo repetidamente con la misma URL puede marcarla para revisión manual sin que te ayude en nada. Corrige primero la causa de fondo, solicita la indexación una sola vez y después monitoriza.
¿Puede una página pasar de «rastreada, actualmente sin indexar» a estar totalmente indexada por sí sola?
Sí, a veces. Google reconsidera ocasionalmente una página con el tiempo, a medida que mejoran otras señales del sitio, incluso sin una edición directa de esa página. No es lo bastante fiable como para contar con ello, pero ocurre.
¿El contenido escaso siempre está por debajo de un número concreto de palabras?
No estrictamente: el número de palabras es una referencia aproximada, no la regla real. Algunas auditorías señalan cualquier página de menos de 600 palabras, pero una página corta que responde por completo a una pregunta concreta puede indexarse igualmente. Una página larga rellena de paja puede acabar excluida.
¿Tener muchas páginas en este estado perjudica al SEO de todo mi sitio?
Un puñado de páginas de utilidad que no indexas a propósito no te perjudicará. Un gran volumen de páginas de baja calidad atascadas aquí puede empeorar cómo Google evalúa la calidad general de tu sitio y su prioridad de rastreo. Conviene limpiarlas en lugar de ignorarlas.
Consigue una visión clara de tus propios problemas de indexación
Tu informe de indexación de páginas mezcla páginas que se pueden ignorar con otras que realmente te hacen perder tráfico. Distinguirlas requiere algo más que echar un vistazo a la lista. Hay que revisar la calidad del contenido, los enlaces y las señales técnicas página por página. Si prefieres ver ese desglose hecho para tu propio sitio, habla con el equipo y pide un informe de muestra. Te muestra exactamente qué impide que las páginas pasen de «rastreada, actualmente sin indexar».
## Recursos / Referencias

1. [La propia documentación de ayuda de Search Console de Google](https://support.google.com/webmasters/answer/7440203)

## Fuentes

- [How We Fix 'Crawled - currently not indexed' on Google ...](https://www.embarque.io/post/how-we-fix-crawled-currently-not-indexed-on-google-search-console)
- [Crawled – Currently Not Indexed in Google Search Console](https://seosly.com/blog/crawled-currently-not-indexed-in-google-search-console/)
- [Understanding and resolving 'Discovered - currently not ...](https://searchengineland.com/understanding-resolving-discovered-currently-not-indexed-392659)
- [Crawled - currently not indexed' mean and how do you fix it?](https://www.quora.com/In-Google-Search-Console-what-does-Excluded-Crawled-currently-not-indexed-mean-and-how-do-you-fix-it)
- [Crawled - Currently Not Indexed: Proven Ways to fix.](https://the7eagles.com/crawled-currently-not-indexed/)
Sobre el autor
SearchBlueprint investigó, escribió y puntuó este artículo con el mismo flujo de contenido que nuestros clientes usan en sus propios sitios. La puntuación que aparece junto al autor es la que nuestro motor de contenido dio a esta página antes de publicarla. Nada de esto se revisa a mano, y ese es el punto: es el resultado del producto, publicado donde cualquiera puede comprobarlo.