Qué es la indexación en buscadores y cómo funciona (y por qué se omiten algunas páginas)
Por Toy Wen Da, Cofundador · Actualizado · 21 min de lectura
Traducido del original en inglés. Léelo en inglés
¿Qué es la indexación en buscadores y cómo funciona? Es el proceso que usa un buscador para analizar una página, guardar su contenido en una base de datos consultable y decidir si puede aparecer en los resultados. Sin indexación, una página no existe para Google ni para Bing, por buena que sea.

Si alguna vez has publicado una página y te has preguntado por qué no aparece nunca en Google, la respuesta casi siempre está en este paso. El rastreo encuentra una página. La indexación decide si se queda. El posicionamiento decide dónde se coloca una vez dentro. Si falla el paso intermedio, lo demás no importa.
Esto es más importante de lo que creen la mayoría de los propietarios de sitios web. Puedes hacer una investigación de palabras clave impecable, escribir un artículo realmente útil y aun así no recibir ni una visita si la página nunca llega al índice. Eso no es un problema de posicionamiento. Es un problema de indexación, y requiere otra solución.
Qué es la indexación en buscadores
La indexación en buscadores es el proceso por el que un buscador analiza el contenido de una página web y lo añade a su índice, una base de datos consultable con las páginas que considera aptas para aparecer en los resultados. Es la segunda de las tres etapas que atraviesa una página antes de poder posicionarse: rastreo, indexación y posicionamiento.
Piensa en una biblioteca. El rastreo es el bibliotecario que recorre las estanterías y anota qué libros hay. La indexación es catalogar cada libro por tema, autor y palabra clave para poder encontrarlo de nuevo en segundos. El posicionamiento es decidir qué libro se le entrega primero a un lector concreto.
Estar indexado no garantiza tráfico. Solo significa que estás en juego. Una página tiene que estar indexada antes de poder posicionarse para nada, por eso este paso está por debajo de casi todas las demás decisiones de SEO que tomarás, incluidas las de optimización on-page y técnica que se tratan en los fundamentos del SEO.
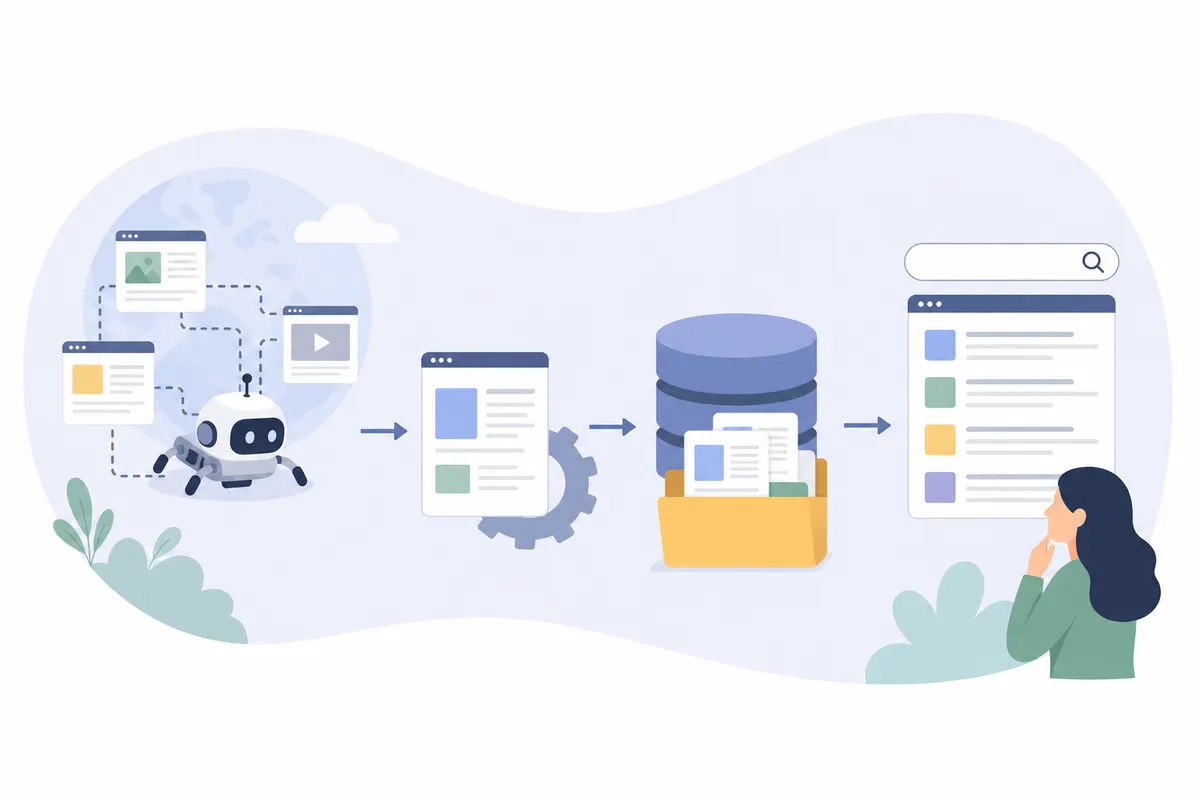
Cómo funciona la indexación en buscadores
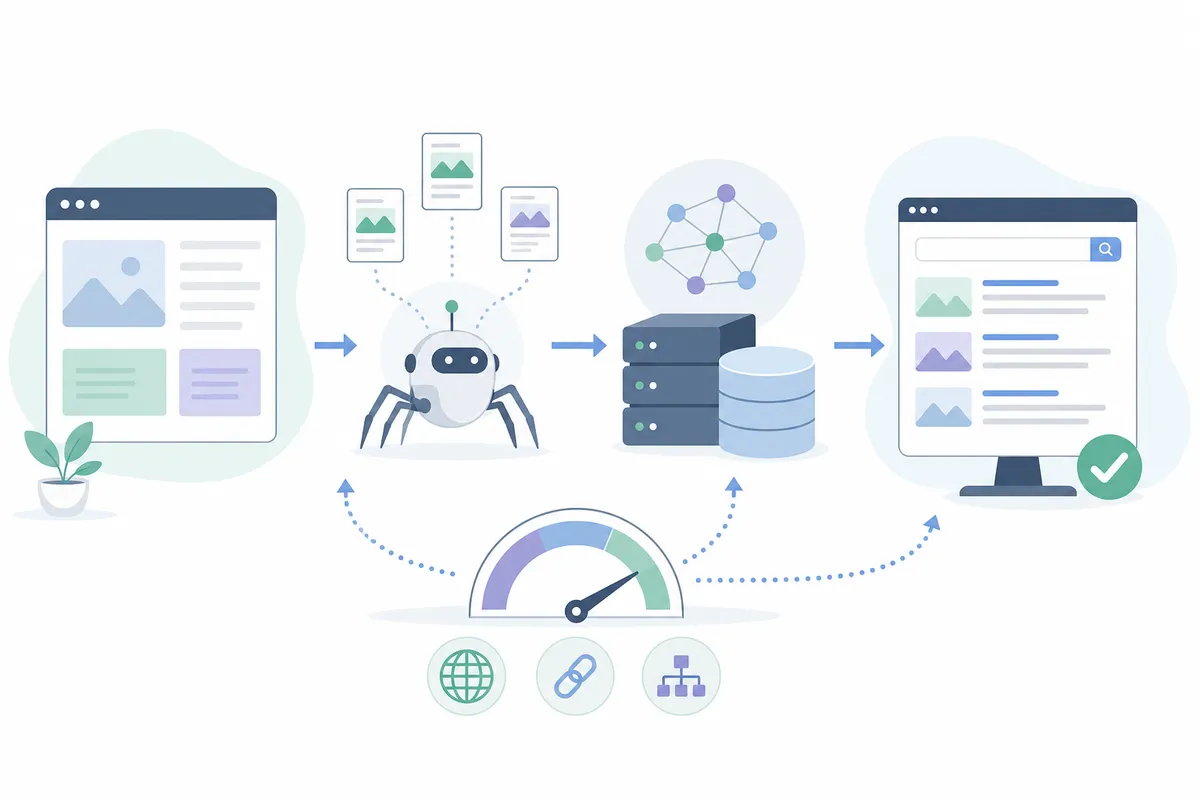
La indexación funciona como una secuencia. Un rastreador encuentra la página, el buscador la renderiza y la analiza, y después decide si merece un lugar en el índice. Estos son los pasos, en orden.
Paso 1: el rastreo encuentra la página
Para poder indexar algo, primero hay que descubrirlo. Los buscadores usan programas automáticos, a menudo llamados rastreadores, bots o arañas, que van saltando de una página a otra siguiendo enlaces por toda la web. Googlebot y Bingbot funcionan así.
Un rastreador llega a tu página a través de un enlace desde otra página que ya conoce, o porque tú has enviado la URL directamente mediante un sitemap o una herramienta como Google Search Console. Las páginas nuevas, sin enlaces que apunten a ellas y sin entrada en el sitemap, pueden quedarse sin descubrir indefinidamente.
Paso 2: renderizado y análisis
Cuando un rastreador llega a una página, el buscador la renderiza más o menos como lo haría un navegador: carga el HTML, el CSS y el JavaScript para ver la página terminada. Según Google Search Central, los sistemas de Google renderizan el contenido de la página y toman nota de las señales clave, desde las palabras clave hasta la actualidad, antes de decidir qué hacer con ella.
Durante este paso, el buscador lee el texto de la página, la etiqueta de título, los encabezados, el texto alternativo de las imágenes, los enlaces internos y los datos estructurados. También busca contenido duplicado, contenido escaso y señales técnicas como las etiquetas canónicas. Es la fase en la que empieza a importar la calidad de los metadatos: las señales que se explican en la importancia real de los metadatos para el SEO influyen directamente en cómo clasifica el buscador la página.
Paso 3: la indexación almacena lo que importa
Si el buscador decide que la página aporta suficiente valor único, guarda en el índice su URL y sus señales de contenido. Este es el paso de indexación propiamente dicho: el contenido pasa a formar parte de la base de datos consultable.
En esta fase, Google también determina la canonicalización. Si varias URL muestran un contenido casi idéntico, Google las agrupa y elige una versión canónica para representar al grupo en los resultados de búsqueda. Las demás se conservan como alternativas, pero normalmente no aparecen por separado en los resultados.
Paso 4: el posicionamiento decide qué se muestra
Estar indexada no significa que una página aparezca para todas las búsquedas relevantes. El posicionamiento es el proceso, distinto y continuo, de puntuar las páginas indexadas frente a una consulta concreta y ordenarlas en los resultados. Una página puede estar en el índice durante meses sin llegar nunca a la primera página para su palabra clave objetivo.

Rastreo, indexación y posicionamiento: por qué importa la diferencia
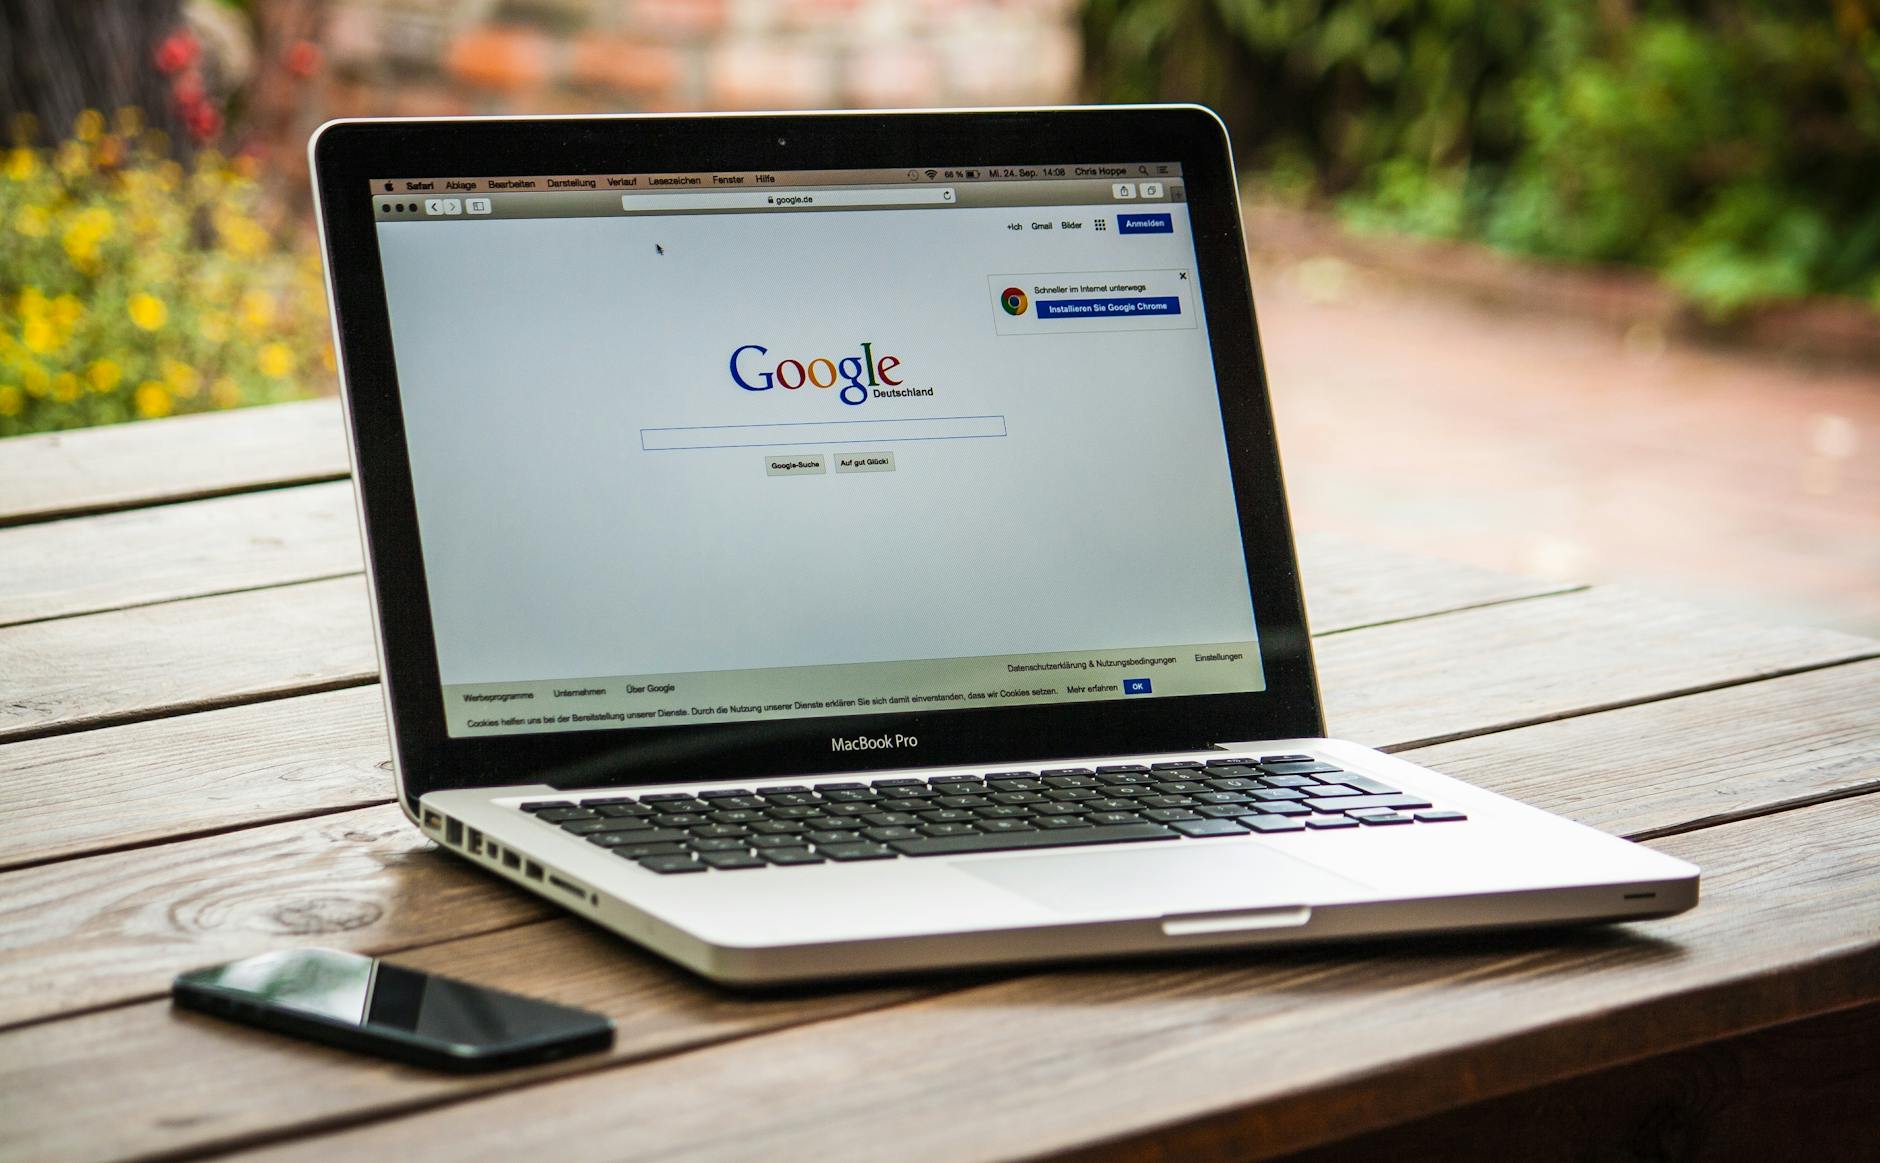
En una conversación informal se usan estos tres términos como si fueran lo mismo, pero son procesos distintos y fallan en puntos diferentes. Una página «rastreada» simplemente ha sido visitada. Una página «indexada» se ha almacenado y se ha considerado digna de conservarse. Una página que «se posiciona» está compitiendo por una búsqueda concreta.
| Etapa | Qué ocurre | Quién o qué la realiza | Cómo se ve un fallo |
|---|---|---|---|
| Rastreo | Un bot descubre y visita la URL | Googlebot, Bingbot u otros rastreadores | La URL nunca se visita; no hay enlaces ni entrada en el sitemap que apunten a ella |
| Indexación | El contenido se analiza y se guarda en el índice | Los sistemas de indexación del buscador | La página se rastrea, pero aparece como «Rastreada: actualmente sin indexar» («Crawled – currently not indexed») |
| Posicionamiento | Las páginas indexadas se puntúan y se ordenan para una consulta | Algoritmo de posicionamiento, aplicado en cada búsqueda | La página está indexada, pero queda enterrada en la página 5 o más para su palabra clave objetivo |
Una página puede rastrearse sin llegar a indexarse. Es mucho menos habitual, pero incluso puede estar indexada sin haber sido rastreada del todo hace poco, si Google ya tiene datos antiguos sobre ella. Mantener separadas estas etapas en tu cabeza hace mucho más fácil diagnosticar problemas: dejas de tratar «no se posiciona» y «no está indexada» como si fueran el mismo fallo.
Qué es un índice de buscador
Un índice de buscador es la enorme base de datos, actualizada de forma continua, que un buscador construye al rastrear y almacenar información sobre páginas web. Es lo que el buscador consulta realmente cuando escribes una búsqueda, no la internet en directo.
Cuando haces una búsqueda, el motor no recorre la web en tiempo real. Extrae coincidencias de este índice ya construido, y por eso los resultados llegan en una fracción de segundo aunque haya miles de millones de páginas en juego. El índice guarda la URL de la página, un resumen de su contenido y metadatos como el idioma, la relevancia geográfica y la compatibilidad con móviles.
Sin este catálogo almacenado, no habría forma de devolver un resultado relevante a una consulta en algo parecido al tiempo real. Todos los buscadores importantes, Google, Bing y los más pequeños, mantienen su propia versión de esta estructura, y entrar en uno no te mete automáticamente en otro.
Qué es un índice invertido
Un índice invertido es la estructura de datos que usan los buscadores para que esa consulta instantánea sea posible. En lugar de organizar los datos por página («esta página contiene estas palabras»), un índice invertido le da la vuelta y organiza por palabra: «esta palabra aparece en estas páginas».
Esa inversión es lo que hace rápida la búsqueda. Cuando buscas «mejores zapatillas de running», el motor no recorre todas las páginas comprobando si contienen esas palabras. Busca «mejores», «zapatillas» y «running» en el índice invertido, obtiene al instante la lista de páginas ya asociadas a cada término, y luego las cruza y las ordena.
Esta estructura es una de las razones principales de que la búsqueda parezca instantánea incluso a la escala de la web actual. También explica por qué la relevancia de las palabras clave sigue importando: si las palabras de tu página nunca se asociaron a las entradas correctas de ese índice invertido, no aparecerá para la consulta, aunque por lo demás esté bien indexada. Un contenido claro y bien estructurado, como el que se describe en una guía práctica de SEO on-page, le da al índice un lenguaje limpio con el que trabajar.

Indexación mobile-first: por qué importa la versión que ve Googlebot
Desde 2023, Google indexa por defecto la versión móvil de una página, no la de escritorio, un cambio al que llama indexación mobile-first. El equipo de Google Search Central confirmó en su blog oficial que la migración estaba prácticamente completada en toda la web, lo que significa que Googlebot Smartphone es ahora el rastreador principal con el que se construye el índice de prácticamente todos los sitios, y el rastreador de escritorio heredado queda reservado para un pequeño número de excepciones.
Esto importa porque lo que se indexa es lo que contiene realmente la versión móvil, no lo que ve un visitante en escritorio. Un error habitual y costoso: ocultar contenido tras un acordeón o una pestaña en móvil suele estar bien y se indexa igualmente, pero el contenido que queda fuera del HTML móvil por completo (navegación recortada, descripciones de producto acortadas o datos estructurados añadidos solo a la plantilla de escritorio) sencillamente no está ahí para que Google lo indexe.
Los sitios que aún usan un subdominio móvil independiente, normalmente con el prefijo m., corren un riesgo adicional. Si las versiones móvil y de escritorio no están bien enlazadas con las etiquetas rel=alternate y rel=canonical correspondientes, Google puede acabar indexando la versión equivocada, o tratando las dos como duplicados y descartando una. Es el mismo conflicto de canonicalización que ya hemos visto, solo que provocado por el tipo de dispositivo en lugar de por los parámetros de la URL.
La solución práctica es sencilla: usa un diseño adaptable (responsive) para que haya un único documento HTML y una única URL por página, lo que elimina por completo el desajuste entre móvil y escritorio como fuente de problemas de indexación. Para los sitios que no pueden abandonar rápidamente una plantilla móvil independiente, lo mejor es auditar que la versión móvil contenga todos los elementos que quieres indexar: texto, imágenes con texto alternativo y datos estructurados.
Qué tamaño tiene el índice: cifras de Google y Bing
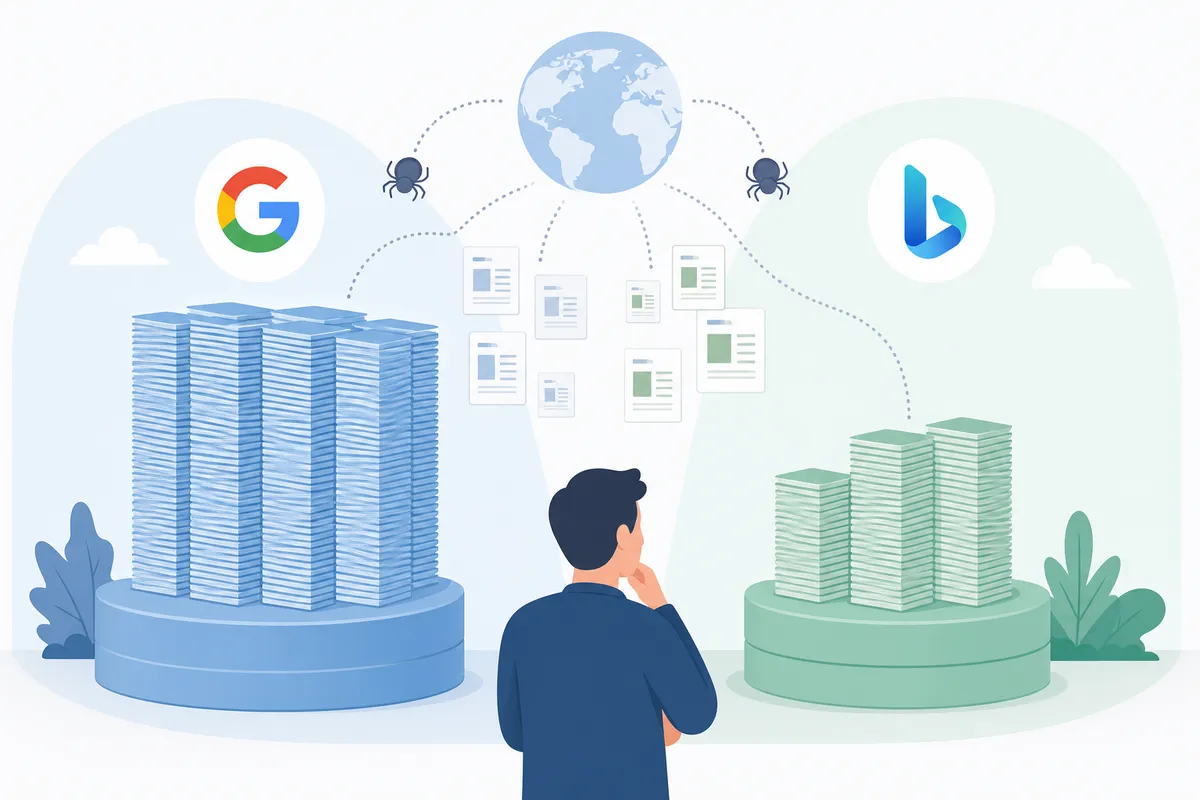
Es difícil imaginar lo que contiene «el índice» sin tener una idea de la escala. La propia explicación de Google, How Search Works, afirma que su índice contiene cientos de miles de millones de páginas web y supera con creces los 100.000.000 de gigabytes de tamaño total, construido con sistemas que funcionan en centros de datos de todo el mundo. Esa cifra no es estática; Google ha dicho que el índice se reconstruye continuamente a medida que se añaden, actualizan o eliminan páginas, y esa es una de las razones por las que una página puede salir de él sin que el propietario del sitio haga nada, algo que se explica en las preguntas frecuentes más abajo.
Microsoft no publica una cifra tan detallada para Bing, pero el propio Webmaster Blog de Bing ha descrito su índice como un conjunto de decenas de miles de millones de páginas, construido a partir de una combinación de su propio rastreador, Bingbot, y de datos compartidos mediante alianzas, incluidos los datos de búsqueda que alimentan los resultados web de Yahoo y de DuckDuckGo en las consultas en las que DuckDuckGo no se apoya en su propio rastreo.
La diferencia de escala entre los dos índices es una de las razones por las que una página puede estar indexada sin problemas en Bing y faltar en Google, o al revés. Cada motor tiene su propio rastreador, sus propios filtros de calidad y su propio índice; entrar en uno no te mete en el otro, y un diagnóstico que solo revise Google Search Console puede pasar por alto por completo un problema de indexación específico de Bing.
Por qué la indexación en buscadores importa para el SEO
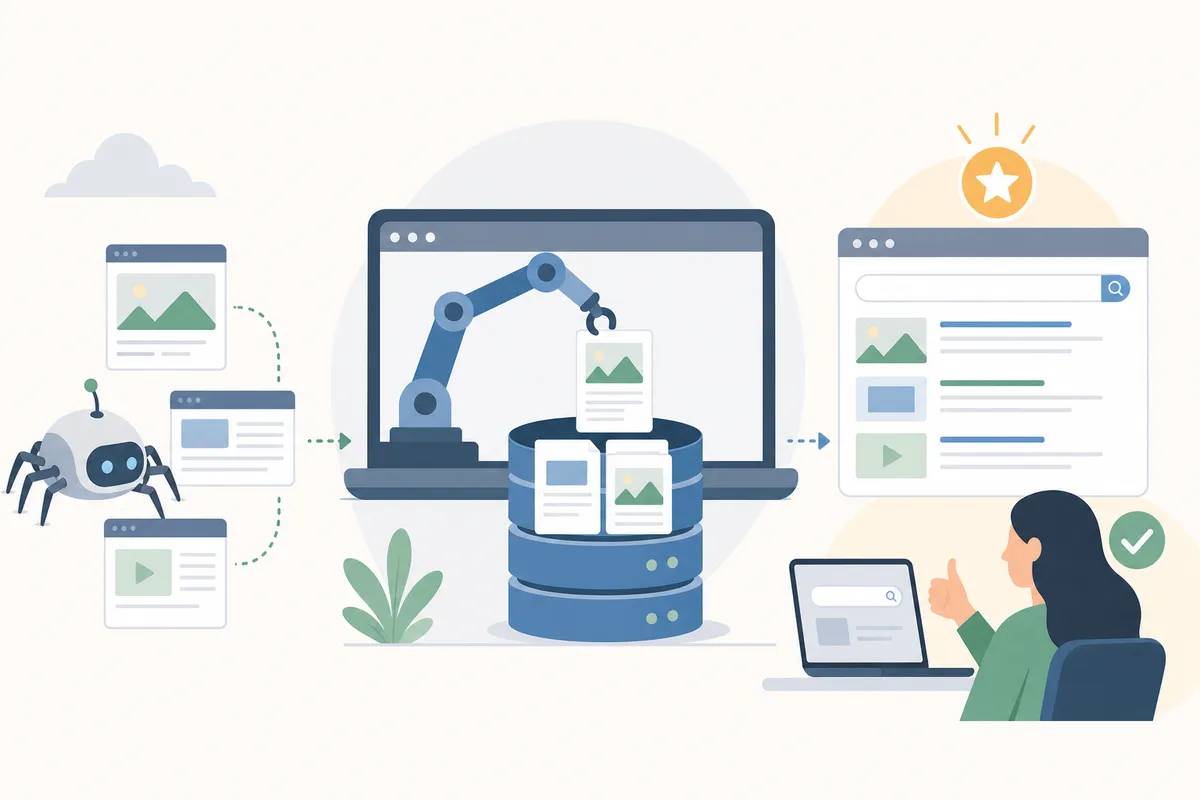
Si una página no está indexada, no tiene ninguna posibilidad de posicionarse, ninguna de aparecer en un AI Overview y ninguna de conseguir tráfico orgánico. Cualquier otra táctica de SEO, ya sean los backlinks, la segmentación por palabras clave o la calidad del contenido, solo empieza a dar frutos después de que se produzca la indexación.
Por eso los problemas de indexación suelen ser los errores más caros de un sitio. Una empresa puede pasar semanas produciendo contenido, publicarlo y no darse cuenta de que es invisible para los buscadores hasta que alguien lo comprueba. Vigilar el estado del índice debería ir a la par de la producción de contenido, no después, y por eso un plan de acción SEO estructurado a 90 días suele incluir una revisión de indexación como uno de los primeros hitos, no como algo secundario.
La indexación en buscadores también actúa como filtro de calidad. Google ha dicho claramente que solo añade al índice las páginas con valor real: las páginas que incurren en keyword stuffing, esquemas de enlaces de baja calidad o contenido escaso y duplicado tienden a ser marcadas o sencillamente omitidas. Las actualizaciones de los algoritmos, en particular las core updates de Google, reevalúan periódicamente qué páginas de un sitio merece la pena mantener indexadas. Si una gran parte de las páginas de un sitio no supera ese listón, Google también puede reducir el rastreo y la indexación del resto del sitio, y esa es una de las razones por las que un puñado de páginas débiles puede arrastrar hacia abajo la visibilidad de todo un dominio.
Por qué se omiten páginas: causas habituales de que falle la indexación
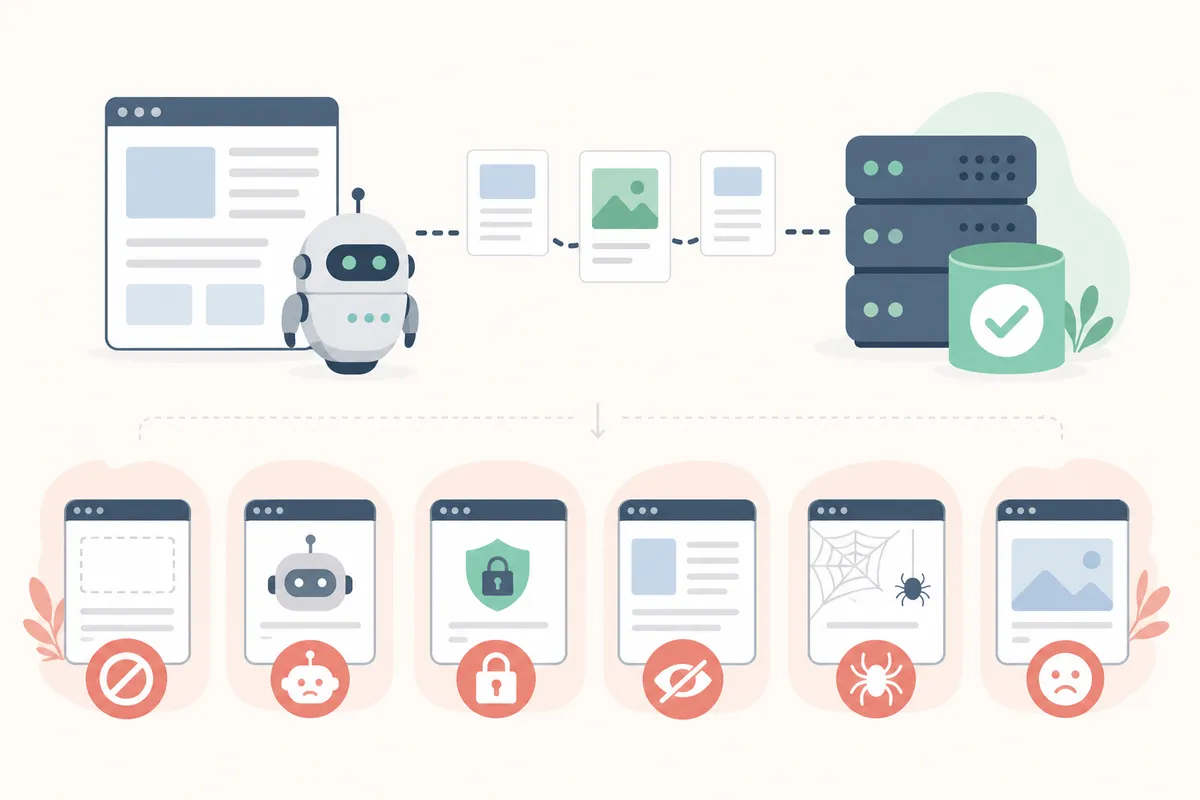
Las páginas no se omiten al azar. Casi siempre hay una causa concreta y diagnosticable, y la mayoría entra en una breve lista de culpables habituales.
Contenido escaso o duplicado
Las páginas con poco valor único, como fichas de producto cortas con el texto del fabricante, páginas de ubicación casi idénticas o filtros generados automáticamente, son la causa más frecuente de que Google decida no indexar una página. El contenido existe y el rastreador lo ha visto, pero el buscador ha decidido que no merecía la pena almacenarlo por separado.
Etiquetas noindex y bloqueos en robots.txt
Una metaetiqueta o un encabezado noindex le dice directamente al buscador: no indexes esta página. Se quedan en las páginas por accidente con muchísima frecuencia: una etiqueta de un sitio de pruebas que nunca se quitó antes del lanzamiento, o un valor predeterminado del CMS que aplica noindex en silencio a ciertos tipos de página. Una regla disallow de robots.txt tiene un efecto relacionado pero distinto: puede bloquear el rastreo por completo, lo que impide la indexación por extensión. Además, el protocolo de exclusión de robots no es solo una convención informal: el IETF lo estandarizó formalmente como RFC 9309 en 2022, y por eso los rastreadores que lo cumplen, de distintos buscadores, respetan todos la misma sintaxis de disallow.
Presupuesto de rastreo y tamaño del sitio
Los buscadores dedican una cantidad finita de atención de rastreo a cada sitio, basada más o menos en su tamaño, su frecuencia de actualización y el estado de las respuestas del servidor. En sitios muy grandes, las páginas de poco valor pueden consumir presupuesto de rastreo que debería ir a las páginas que sí quieres indexar, de modo que algunas se rastrean rara vez o nunca.
Páginas con mucho JavaScript y aplicaciones de una sola página
Los buscadores pueden renderizar JavaScript, pero es un paso más lento y que consume más recursos que leer HTML simple, y no siempre sale bien. El contenido que solo aparece después de ejecutarse JavaScript en el cliente, algo habitual en las aplicaciones de una sola página, puede pasarse por alto o indexarse con retraso. Es un fallo bien documentado; consulta por qué las aplicaciones de una sola página desaparecen de Google para ver la mecánica en detalle.
Conflictos de canonicalización
Cuando una página tiene una etiqueta canónica que apunta a otra URL, ya sea a propósito o por error, Google suele indexar la versión canónica en lugar de la que rastreó. Una etiqueta canónica mal configurada puede mantener fuera del índice, sin hacer ruido, una página que por lo demás es buena, en favor de la URL equivocada.
| Motivo por el que se omite la página | Cómo se ve en Search Console | Solución habitual |
|---|---|---|
| Contenido escaso o duplicado | «Duplicate, Google chose different canonical» o «Rastreada: actualmente sin indexar» | Consolidar o reescribir con contenido único y sustancial |
| Etiqueta noindex o bloqueo en robots.txt | «Excluida por la etiqueta "noindex"» (Excluded by 'noindex' tag) o «Bloqueada por robots.txt» (Blocked by robots.txt) | Quitar la etiqueta o actualizar la regla disallow |
| Límites del presupuesto de rastreo (sitios grandes) | «Detectada: actualmente sin indexar» (Discovered – currently not indexed) | Podar las páginas de poco valor; mejorar los enlaces internos hacia las páginas prioritarias |
| Fallos de renderizado de JavaScript | Contenido ausente en la versión en caché o renderizada | Renderizar en el servidor o prerrenderizar el contenido clave |
| Conflictos de canonicalización | «Página alternativa con etiqueta canónica adecuada» (Alternate page with proper canonical tag) | Corregir o eliminar las etiquetas canónicas incorrectas |
La mayoría de estos casos tienen su origen en los fundamentos del SEO técnico y no solo en la calidad del contenido. Si ves un patrón de exclusiones en muchas páginas, conviene repasar las correcciones de SEO técnico que de verdad mueven el posicionamiento antes de dar por hecho que el problema es el contenido.
Un ejemplo práctico: seguir una página desde la publicación hasta el índice
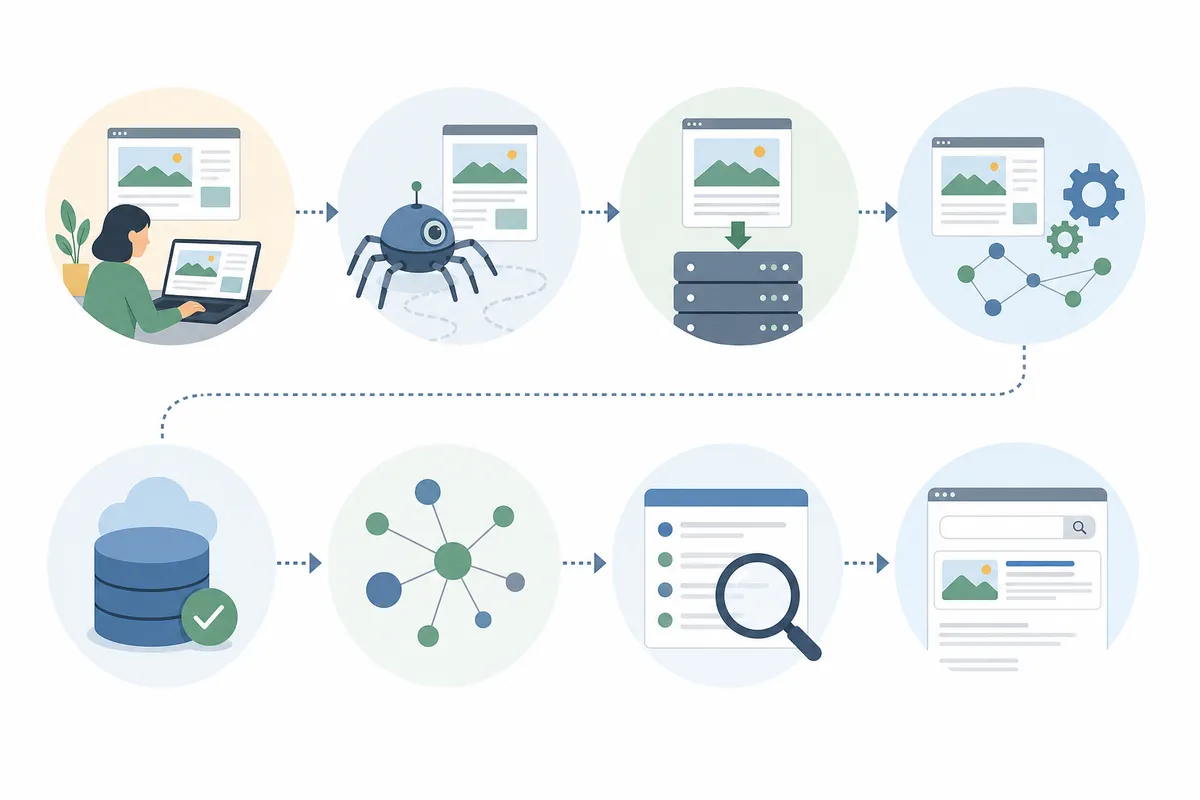
Ayuda ver la cronología con acciones reales, en lugar de tratar la indexación como una caja negra. Esta es una secuencia realista para una entrada nueva de blog en un sitio consolidado con un buen historial de rastreo:
- Día 0: se publica la página. El sitemap XML del sitio está configurado para regenerarse automáticamente, así que la nueva URL se añade al archivo del sitemap en cuestión de minutos.
- Día 0-1: como el sitio ya tiene otras páginas que enlazan internamente a la nueva entrada y su sitemap se actualiza automáticamente, Googlebot descubre la URL en su próximo rastreo programado del sitemap, normalmente en un día para un dominio consolidado.
- Día 1-3: Googlebot rastrea y renderiza la página. La herramienta de inspección de URLs de Search Console (URL Inspection), consultada manualmente el día 2, todavía no muestra «La URL está en Google» (URL is on Google), pero ya hay un rastreo registrado.
- Día 3-7: se evalúa la unicidad y la calidad de la página frente al resto del contenido del sitio. Si la supera, se añade al índice. Si se revisa el informe de Cobertura (Coverage) hacia el día 5-7, lo normal sería ver cómo la URL pasa de «Detectada: actualmente sin indexar» (si es que llegó a aparecer ahí) a «Indexada».
- Día 7 en adelante: la página ya puede aparecer en los resultados de búsqueda y empieza a competir por posicionarse, aunque puede tardar bastante más en conseguir posiciones significativas para un término competitivo; esa es la etapa de posicionamiento, que funciona con independencia de la indexación.
Ahora compáralo con un dominio nuevo, sin backlinks y sin historial de rastreo. Esa misma página podría no descubrirse en absoluto hasta que se envíe un sitemap manualmente desde Search Console, porque no hay un patrón de rastreo establecido que Googlebot pueda seguir ni autoridad de enlaces internos que la atraiga. Una vez descubierta, el tiempo entre el rastreo y el índice puede alargarse de días a varias semanas, y la propia guía de Google reconoce que los sitios nuevos suelen tardar más en rastrearse e indexarse de forma constante que los que tienen un historial consolidado.
La diferencia entre estos dos escenarios no es el contenido, sino todo lo que lo rodea: la frescura del sitemap, los enlaces internos y el historial de rastreo del dominio. Por eso la misma solución, por ejemplo solicitar la indexación mediante la inspección de URLs, da un resultado el mismo día en un sitio y casi no sirve de nada en otro. La herramienta solo empuja la cola; no anula las señales de fondo en las que se basa la decisión de indexar.
¿Puedes solucionar tú mismo los problemas de indexación?
Sí, en la mayoría de los casos habituales. Quitar una etiqueta noindex puesta por accidente, corregir una regla de robots.txt, enviar un sitemap o solicitar la indexación de una sola URL desde Google Search Console son tareas que un propietario de sitio puede hacer sin ayuda especializada, normalmente en menos de una hora.
Lo difícil es el diagnóstico, no la ejecución. La solución para «Rastreada: actualmente sin indexar» puede ser reescribir el contenido, corregir una canónica, cambiar los enlaces internos o resolver un problema de presupuesto de rastreo, y Search Console no siempre te dirá cuál se aplica a tu caso concreto. Leer bien el informe de cobertura y saber qué motivos de exclusión son urgentes y cuáles son esperables exige cierta familiaridad con cómo se toman realmente las decisiones de indexación.
Un enfoque razonable: encárgate primero tú de las soluciones claras y mecánicas: etiquetas noindex, robots.txt, envío del sitemap. Si pasadas unas semanas hay páginas sin indexar y sin una causa evidente, ese es el momento en que una auditoría de SEO técnico más a fondo compensa su coste.
Cómo conseguir que tus páginas se indexen más rápido
Ninguno de estos métodos obliga a un buscador a indexar una página de baja calidad: esa decisión sigue dependiendo del contenido y de las señales técnicas. Lo que hacen es eliminar la demora entre la publicación y el descubrimiento, algo que importa mucho para el contenido sensible al tiempo.
Sitemaps XML
Un sitemap XML es un archivo que lista todas las URL de tu sitio que quieres que conozcan los buscadores. Funciona como un mapa para los rastreadores y los dirige hacia páginas que de otro modo podrían pasar por alto, sobre todo en sitios grandes o con una estructura muy profunda. Enviar uno no garantiza la indexación, pero elimina por completo el problema de que «el rastreador nunca encontró esta página».
Para enviar un sitemap en Google Search Console: abre el informe Sitemaps, haz clic en «Add a new sitemap», escribe la URL del sitemap (normalmente yoursite.com/sitemap.xml) y envíalo. Bing Webmaster Tools tiene una sección de Sitemaps equivalente con el mismo flujo básico.
La herramienta de inspección de URLs de Google Search Console
Para una sola página que necesita atención ya, la herramienta de inspección de URLs (URL Inspection) de Google Search Console te permite comprobar el estado de indexación de una URL concreta y solicitar un rastreo directamente. Pega la URL, revisa los problemas que señale y, si nada la bloquea, puedes solicitar la indexación en el acto.
Es la herramienta adecuada para «acabo de corregir una etiqueta noindex y quiero que Google se entere pronto», no para enviar por lotes cientos de URL, algo para lo que no está pensada.
La Indexing API de Google
La Indexing API de Google te permite avisar a Google de forma programática sobre URL nuevas o actualizadas, sin esperar a un rastreo del sitemap ni a una solicitud manual de inspección de URLs. Google la plantea como más útil para sitios con contenido de corta duración, como ofertas de empleo, páginas de retransmisiones en directo o listados de eventos, donde la rapidez importa más que la cobertura.
Configurarla requiere crear un proyecto de Google Cloud y una cuenta de servicio, verificar la propiedad en Search Console y generar un token de acceso, lo que supone un esfuerzo bastante más técnico que un sitemap. Google sigue recomendando enviar un sitemap completo además de la API, ya que esta es un complemento, no un sustituto.
Bing Webmaster Tools e IndexNow
Bing Webmaster Tools incluye su propia función de envío de URL, que permite enviar hasta 10.000 URL al día para un rastreo y una evaluación casi inmediatos. Las páginas que cumplen el nivel de calidad de Bing pueden aparecer en los resultados poco después del envío.
Bing también respalda IndexNow, un protocolo que permite a un sitio avisar a los buscadores en el instante en que se publica, actualiza o elimina una página, en lugar de esperar al siguiente rastreo programado. Como IndexNow se comparte entre los buscadores participantes, enviar a través de él puede avisar a más de un buscador con un solo aviso. Microsoft ha descrito IndexNow como una iniciativa conjunta que desarrolló con Yandex, creada específicamente para reducir el rastreo repetido y especulativo en el que ambos motores se apoyan de otro modo solo para enterarse de que una página ha cambiado.
Enlaces internos y backlinks
Una página enlazada desde otras páginas de tu sitio, sobre todo desde páginas que los rastreadores ya visitan a menudo, es más fácil de encontrar y señala que merece la pena volver a visitarla. Las páginas huérfanas, sin ningún enlace interno que apunte a ellas, están entre las que más tardan en indexarse. Auditar y corregir las carencias de enlazado interno suele ser una palanca mayor que cualquier herramienta de envío, porque es una señal permanente y no un aviso puntual.
Los backlinks externos también ayudan, ya que un rastreador que sigue un enlace desde otro sitio es una de las formas originales en que descubre páginas nuevas. Las señales sociales pueden acelerar el descubrimiento de forma indirecta en alguna ocasión: un enlace compartido recibe clics, se rastrea o se enlaza desde otros sitios, pero no son un mecanismo directo de indexación como lo son un sitemap o la Indexing API.
| Método | Buscador(es) | Mejor uso | Límite práctico | Velocidad habitual |
|---|---|---|---|---|
| Sitemap XML | Google, Bing | Cobertura de todo el sitio, descubrimiento continuo | Un solo envío cubre todo el sitio | Días, se revisa según el calendario de rastreo |
| Herramienta de inspección de URLs | Una sola página urgente | Una URL cada vez | De horas a unos pocos días | |
| Indexing API | Google (oficialmente, contenido de empleo y retransmisiones en directo) | Páginas que cambian con frecuencia y duran poco | Cuota diaria por proyecto | Casi inmediata una vez configurada |
| Envío de URL de Bing | Bing | Envío por lotes de páginas nuevas o actualizadas | Hasta 10.000 URL al día | Evaluación casi inmediata |
| IndexNow | Bing y los buscadores participantes | Aviso instantáneo al publicar, actualizar o eliminar | No se indica un límite diario fijo | Aviso casi inmediato |
Cómo comprobar si tus páginas están indexadas
Antes de arreglar un problema de indexación, confirma que realmente existe. Hay varias formas fiables de comprobarlo.
- El informe de Cobertura/Indexación de Google Search Console muestra exactamente qué URL están indexadas, cuáles están excluidas y el motivo concreto de cada exclusión; es la fuente de verdad más precisa para Google.
- El operador de búsqueda
site:(escribirsite:tudominio.com/url-de-la-paginaen Google) permite una comprobación rápida y aproximada, aunque se sabe que no es preciso para recuentos exactos. - Bing Webmaster Tools tiene sus propios informes de cobertura del índice, paralelos a los de Google, para comprobar el estado específico de Bing.
- La herramienta de inspección de URLs da una respuesta definitiva por página, con la fecha del último rastreo y los problemas detectados, solo para Google.
Conviene hacer esta comprobación con regularidad, no solo una vez tras el lanzamiento, porque las páginas pueden salir del índice más adelante por un rediseño del sitio, una etiqueta noindex accidental introducida en una actualización de plantilla o una core update que reevalúe la calidad del contenido en todo el sitio.
Google, Bing y DuckDuckGo: en qué se diferencia la indexación según el buscador

No todos los buscadores indexan la web de la misma manera, y las diferencias influyen en cómo diagnosticarías una página que falta.
| Buscador | Rastreador propio | Índice propio | Velocidad de descubrimiento habitual | Herramienta principal de envío |
|---|---|---|---|---|
| Googlebot | Sí, cientos de miles de millones de páginas según las cifras de Google | De horas a semanas, según la autoridad del sitio | Search Console (sitemaps, inspección de URLs, Indexing API) | |
| Bing | Bingbot | Sí, decenas de miles de millones de páginas según las cifras de Bing | Un rango similar al de Google, a menudo más rápido para sitios pequeños mediante IndexNow | Bing Webmaster Tools, IndexNow |
| DuckDuckGo | Limitado (DuckDuckBot) | Parcial; combina su propio rastreo con resultados con licencia de Bing | Depende de la fuente subyacente en la que aparezca la página | Sin herramienta de envío específica para la mayoría de los resultados |
Google y Bing tienen sistemas de rastreo e índice a gran escala construidos desde cero, y por eso las soluciones de esta guía (sitemaps, auditorías de noindex, IndexNow) se aplican a ambos con solo pequeñas diferencias de herramientas. DuckDuckGo es un caso muy distinto: ha dicho públicamente que obtiene una parte importante de sus resultados web del índice de Bing en lugar de rastrear e indexar toda la web por su cuenta, junto con su propio rastreador y cientos de otras fuentes. En la práctica, esto significa que una página indexada y bien posicionada en Bing tiene muchas más probabilidades de aparecer en DuckDuckGo que una página indexada solo en Google, y no existe un equivalente de Search Console específico de DuckDuckGo para comprobar el estado directamente.
La conclusión práctica: si un negocio depende de su visibilidad en varios buscadores, no solo en Google, confirmar que una página está indexada en Bing abarca más de lo que parece, porque ese índice alimenta más de una página de resultados. Comprobar solo site:tudominio.com en Google y dar por hecho que el panorama es el mismo en todas partes es un punto ciego habitual.
Cuándo pedir ayuda profesional con la indexación
La mayoría de los problemas de indexación puntuales se pueden resolver sin ayuda externa. Recurre a un profesional cuando el patrón sea más amplio que una sola página: grandes partes de un sitio atascadas en «Detectada: actualmente sin indexar», una migración que hundió la indexación en todo el sitio o un framework de JavaScript que los rastreadores nunca han renderizado bien.
Estas situaciones suelen requerir a alguien que sepa leer los registros del servidor, comparar el HTML renderizado real con lo que ve un rastreador y seguir el problema a través de un conjunto de causas posibles en lugar de una sola evidente. Si produces contenido nuevo con regularidad y quieres tener la seguridad de que está bien estructurado e indexable desde el principio, conviene revisar cómo gestiona tu proceso de creación de contenido el escribir contenido SEO que se posicione antes de que el problema de indexación se agrave en decenas de páginas.
Preguntas frecuentes
¿Cuál es la diferencia entre rastreo e indexación?
El rastreo es cuando un bot descubre y visita una página. La indexación es cuando el buscador decide guardar el contenido de esa página en su base de datos. Una página puede rastrearse sin llegar a indexarse nunca.
¿Cuánto tarda la indexación en buscadores?
Varía mucho: desde unos minutos en un sitio consolidado y rastreado con frecuencia que use la Indexing API o IndexNow, hasta varias semanas en un sitio nuevo con pocos enlaces internos o externos que apunten a sus páginas.
¿Por qué Google rastrearía mi página pero no la indexaría?
Normalmente significa que Google consideró el contenido demasiado escaso, demasiado parecido a otra página que ya tiene, o que lo ve mejor representado por una URL canónica diferente. Los bloqueos técnicos, como las etiquetas noindex, también pueden causarlo.
¿Enviar un sitemap garantiza la indexación?
No. Un sitemap solo ayuda a los buscadores a descubrir una URL más rápido. Que acabe indexándose depende igualmente de la calidad del contenido y de señales técnicas como las etiquetas noindex o la canonicalización.
¿Puede una página perder su estado de indexada después de haberse indexado una vez?
Sí. Las páginas pueden salir del índice más adelante por cambios de contenido, etiquetas noindex accidentales, migraciones del sitio o una reevaluación durante una core update del algoritmo.
¿Google indexa los PDF, las imágenes y los vídeos igual que las páginas web?
Sí, con diferencias. Google puede indexar PDF y extraer su texto, y tanto Google como Bing indexan imágenes y vídeos mediante señales como el texto alternativo, los nombres de archivo y el contenido de la página que los rodea, según recoge la documentación de Google sobre indexación de imágenes y vídeos, y no interpretando visualmente el archivo como hacen con el texto HTML.
¿Cuántas páginas contiene realmente el índice de Google?
La página How Search Works de Google afirma que el índice contiene cientos de miles de millones de páginas web, aunque Google no publica un recuento exacto y actualizado de forma continua; la cifra cambia a medida que se añaden y eliminan páginas.
¿Hay forma de ver el total de páginas indexadas de mi sitio?
El informe Páginas (Pages), dentro de la sección Indexación de Google Search Console, es el recuento más fiable para tu propio sitio, desglosado en URL indexadas y no indexadas con un motivo para cada exclusión. El operador site: ofrece una estimación pública aproximada, pero Google ha advertido de que no es exacta para recuentos precisos.
Haz que diagnostiquen tus problemas de indexación
Entender qué es la indexación en buscadores y cómo funciona importa sobre todo cuando se aplica a tu propio sitio: la indexación es la puerta que toda página tiene que cruzar antes de poder posicionarse, y la mayoría de los sitios tienen al menos unas cuantas páginas atascadas tras ella sin que nadie se dé cuenta. La forma más rápida de saber dónde ocurre eso en tu sitio es ver tus datos reales de indexación y posicionamiento reunidos en un solo lugar. Habla con el equipo y consigue un informe de muestra que te muestre exactamente cuáles de tus páginas están indexadas, cuáles están en riesgo y qué conviene arreglar primero.
Lectura relacionada: Desalentar a los buscadores de indexar este sitio: guía de configuración.
Lectura relacionada: "Detectada: actualmente sin indexar": qué significa y cómo solucionarlo.
Fuentes
- How Does Search Engines Work?
- How Search Engines Work - On Digital Marketing
- How Do Search Engines Work?
- How Search Engines Work: Crawling to Ranking
Aviso legal: Este artículo es información general sobre salud, no un consejo médico personalizado. No puede tener en cuenta tus antecedentes, tu medicación ni los hallazgos de tu exploración. Para recibir asesoramiento sobre tus propios síntomas, habla con un profesional sanitario cualificado; si los síntomas son graves o empeoran, busca atención urgente.
Sobre el autor
SearchBlueprint investigó, escribió y puntuó este artículo con el mismo flujo de contenido que nuestros clientes usan en sus propios sitios. La puntuación que aparece junto al autor es la que nuestro motor de contenido dio a esta página antes de publicarla. Nada de esto se revisa a mano, y ese es el punto: es el resultado del producto, publicado donde cualquiera puede comprobarlo.