«Detectada: actualmente sin indexar»: qué significa y cómo solucionarlo
Por Toy Wen Da, Cofundador · Actualizado · 5 min de lectura
Traducido del original en inglés. Léelo en inglés
Si Google Search Console muestra «Detectada: actualmente sin indexar» (Discovered – currently not indexed) junto a una URL, Googlebot sabe que la página existe, pero todavía no la ha rastreado. No ha leído tu texto, tus encabezados ni tus imágenes, porque la página sigue esperando en una cola. Eso cambia la forma de solucionarlo, ya que todavía no se ha juzgado nada sobre la calidad de la página.
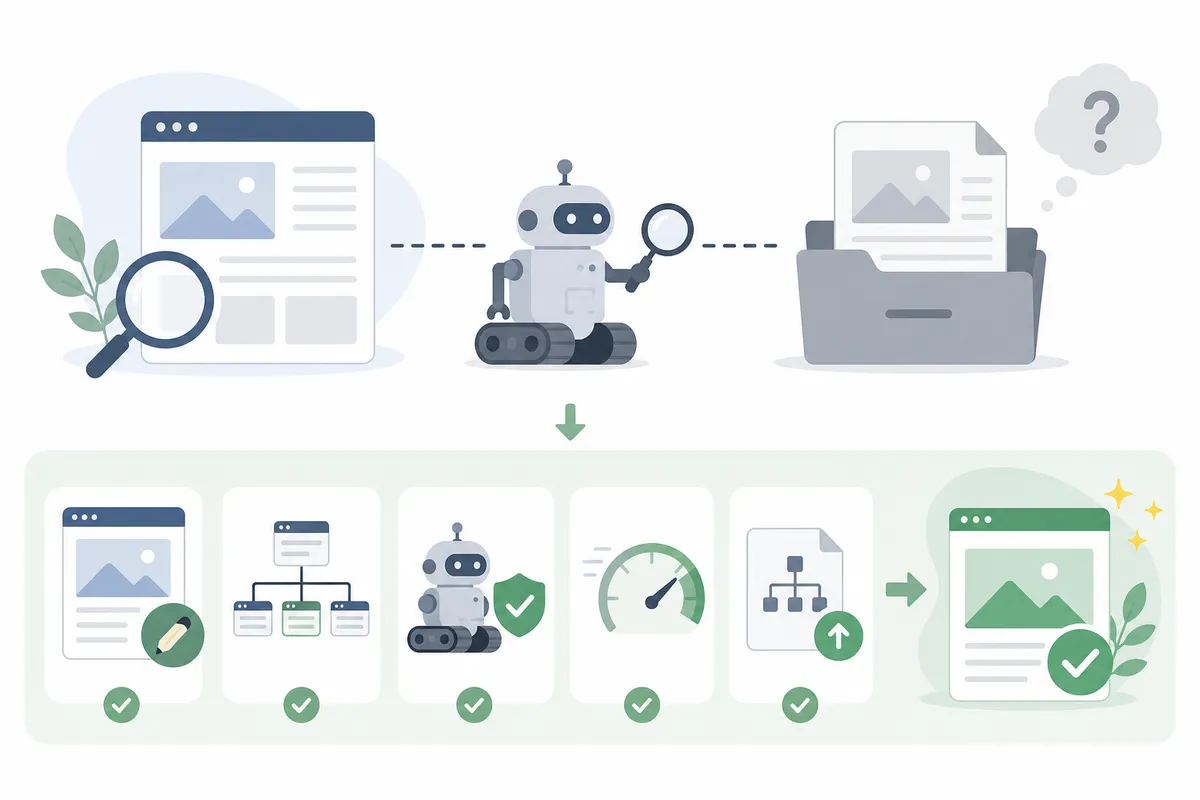
Detectada vs. rastreada vs. noindex
Mucha gente mezcla estos estados, pero cada uno apunta a una solución distinta, y confundirlos hace perder tiempo.
| Estado | Qué hizo Googlebot | Causa probable | Qué lo soluciona de verdad |
|---|---|---|---|
| Detectada: actualmente sin indexar | Puso la URL en cola, aún no la ha obtenido | Baja prioridad de rastreo, enlaces internos débiles, un sitio grande que compite por el presupuesto de rastreo | Enlaces internos desde páginas que se rastrean con frecuencia, limpieza del sitemap |
| Rastreada: actualmente sin indexar | Obtuvo y leyó la página, y decidió no indexarla | Contenido escaso, duplicación, conflictos de canonical | Aportar valor único, corregir las etiquetas canonical |
| Noindex detected | Obtuvo la página y encontró una directiva noindex | Una etiqueta de un plugin o de la plantilla | Eliminar la etiqueta noindex y luego solicitar un nuevo rastreo |
Si tu estado es «detectada», reescribir la página no te servirá todavía, porque Google no la ha leído. Es el error que más cometen los propietarios de sitios.
Por qué las páginas se quedan atascadas en «detectada»
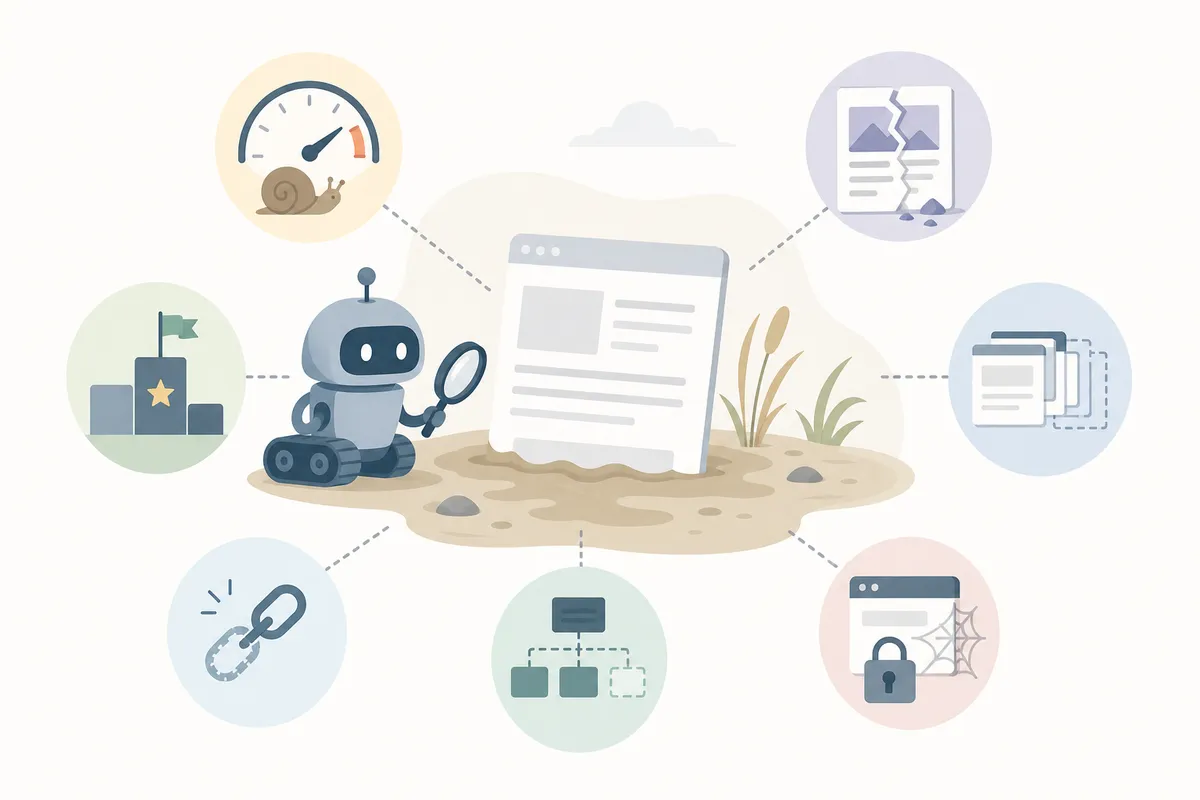
Algunas condiciones dejan una URL en esta sala de espera:
- Poca demanda de rastreo. Los sitios grandes o recientes compiten por un presupuesto de rastreo limitado, y Google da menos prioridad a las páginas que no considera urgentes.
- Sin enlaces internos fuertes. Una página huérfana, o enlazada solo desde entradas con poco tráfico, transmite poca importancia.
- Ruido en el sitemap. Si tu sitemap enumera miles de URL pobres o desactualizadas, Google confía menos en él y lo rastrea más despacio.
- Problemas de respuesta del servidor. Las respuestas lentas o los errores intermitentes durante las visitas de Googlebot pueden hacer que se retire.
La documentación de Search Console de Google describe los estados del informe de indexación de páginas (Page Indexing) y confirma que «detectada» significa que la URL se encontró pero aún no se ha obtenido (Google Search Console Help).
Cómo solucionar «Detectada: actualmente sin indexar», por orden
Sigue estos pasos en secuencia. Quienes saltan a cambiar el contenido antes de descartar los problemas de acceso suelen seguir atascados.
Paso 1: Descarta los bloqueos de acceso
Revisa en robots.txt si hay una regla Disallow que afecte a la página y usa la herramienta de inspección de URLs (URL Inspection) para confirmar que «Indexing allowed» aparece como «Yes». Un bloqueo total es el único caso en el que solicitar la indexación realmente no ayuda, porque Googlebot no puede llegar a la página.
Paso 2: Refuerza los enlaces internos
Suele ser la solución con mayor retorno. Enlaza la página atascada desde páginas que Google ya rastrea a menudo, como tu página de inicio, una entrada con mucho tráfico o una página hub, y la nueva URL entrará en el mismo ciclo de rastreo. Si estás construyendo una estrategia de contenidos más amplia, en la que las páginas se enlazan entre sí con un propósito en lugar de al azar, la hoja de ruta de la estrategia de búsqueda sin clics explica cómo estructurar el contenido para ganar tanto prioridad de rastreo como citas.
Paso 3: Limpia el sitemap
Elimina del sitemap las URL pobres, redirigidas o con noindex. Un sitemap lleno de páginas de poco valor diluye la confianza en las buenas.
Paso 4: Solicita la indexación una sola vez
Cuando hayas hecho lo anterior, solicita la indexación de esa URL concreta en Search Console. Por sí sola no fuerza la indexación, pero sí sube la página en la cola de rastreo una vez despejados los bloqueos reales.
¿Puedes solucionarlo tú mismo?
En la mayoría de los casos, sí. Revisar robots.txt, limpiar un sitemap y añadir enlaces internos son tareas que un propietario del sitio puede hacer sin un desarrollador. Se complica cuando necesitas diagnosticar por qué toda una sección del sitio se rastrea poco de forma crónica, ya que eso suele apuntar a problemas de arquitectura o de rendimiento que merecen una auditoría técnica. Si además estás decidiendo qué páginas merecen el esfuerzo y cuáles retirar, usar señales de interacción en lugar de publicar más contenido es una buena manera de priorizar.
Preguntas frecuentes
¿«Detectada: actualmente sin indexar» significa que mi página ha sido penalizada?
No. Googlebot simplemente aún no ha rastreado la página, y eso es una decisión de programación y prioridad basada en el presupuesto de rastreo y en los enlaces internos.
¿Cuánto tarda normalmente en resolverse?
Depende del tamaño y la autoridad del sitio, pero muchas páginas salen de este estado en un plazo de entre unos días y un par de semanas una vez resueltos los problemas de enlaces internos y de sitemap.
¿Los backlinks solucionan una página «Detectada: actualmente sin indexar»?
Los backlinks externos pueden ayudar al generar tráfico y señales de referencia, pero rara vez son la solución principal. Los enlaces internos fuertes desde páginas que Google ya rastrea con frecuencia suelen funcionar más rápido.
¿Debería pulsar «Solicitar indexación» (Request Indexing) todos los días?
No. Las solicitudes repetidas sin corregir la causa de fondo no ayudan y pueden parecer un comportamiento de spam. Soluciona primero los problemas de acceso y de enlaces, y solicita la indexación una sola vez.
¿Es lo mismo que una etiqueta noindex?
No. Google tiene que rastrear una página antes de poder respetar una etiqueta noindex, así que eso aparece como «rastreada», no como «detectada». Un bloqueo real en robots.txt, en cambio, impide por completo la obtención de la página y la mantiene en «detectada» indefinidamente.
Obtén una visión clara del estado de tu indexación
Adivinar qué páginas están atascadas y por qué te hace perder un tiempo que no tienes. Habla con el equipo y consigue un informe SEO de muestra que te muestre exactamente qué URL están en «Detectada: actualmente sin indexar», por qué y qué corregir primero.
Lectura relacionada: Crawled – Currently Not Indexed? Here's the Real Fix.
Fuentes
Sobre el autor
SearchBlueprint investigó, escribió y puntuó este artículo con el mismo flujo de contenido que nuestros clientes usan en sus propios sitios. La puntuación que aparece junto al autor es la que nuestro motor de contenido dio a esta página antes de publicarla. Nada de esto se revisa a mano, y ese es el punto: es el resultado del producto, publicado donde cualquiera puede comprobarlo.