„Discovered – Currently Not Indexed“: Was es bedeutet und wie Sie es beheben
Von Toy Wen Da, Mitgründer · Aktualisiert · 5 Min. Lesezeit
Übersetzt aus dem englischen Original. Auf Englisch lesen
Wenn die Google Search Console neben einer URL „Discovered currently not indexed“ anzeigt, weiß der Googlebot, dass die Seite existiert, hat sie aber noch nicht gecrawlt. Er hat weder Ihren Text noch Ihre Überschriften oder Bilder gelesen, denn die Seite wartet noch in einer Warteschlange. Das verändert die Vorgehensweise bei der Behebung, denn über die Qualität der Seite wurde noch gar nicht geurteilt.
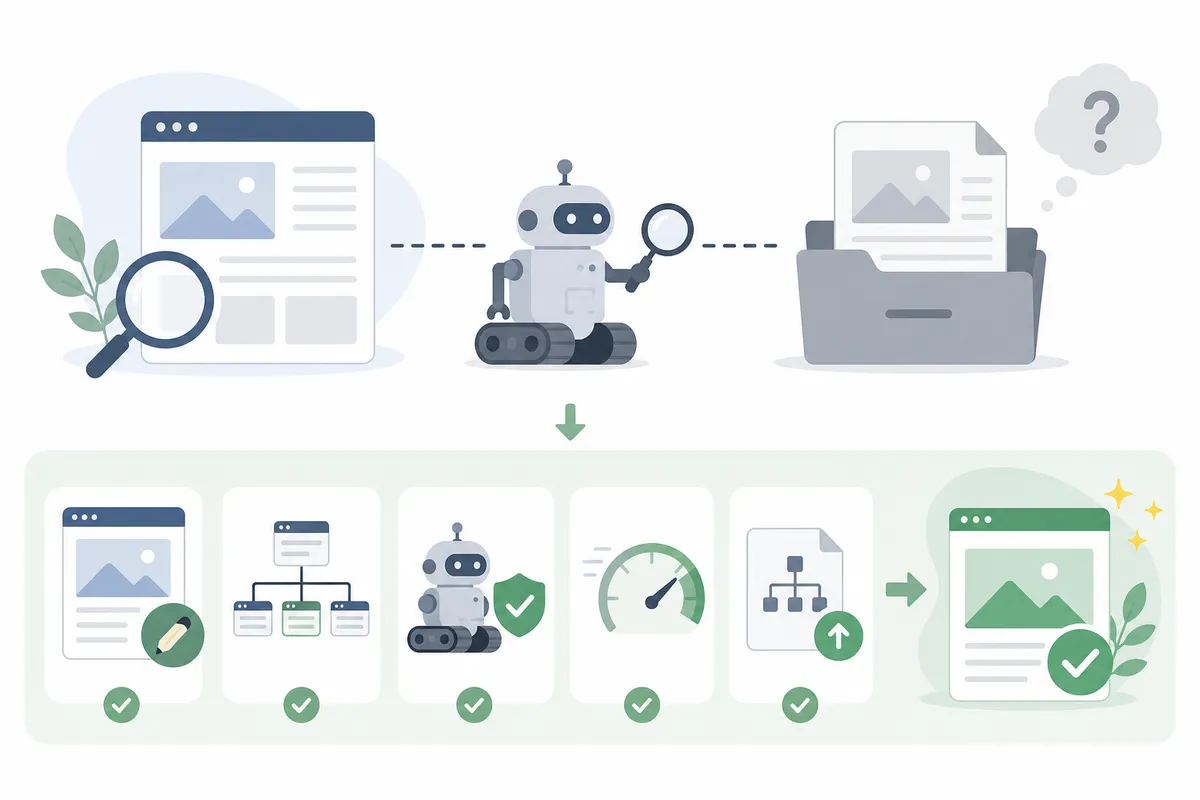
Discovered vs. crawled vs. noindex
Viele werfen diese Status in einen Topf, doch jeder verlangt eine andere Lösung, und Verwechslungen kosten Zeit.
| Status | Was der Googlebot getan hat | Wahrscheinliche Ursache | Was wirklich hilft |
|---|---|---|---|
| Discovered – currently not indexed | Die URL eingereiht, aber nicht abgerufen | Niedrige Crawl-Priorität, schwache interne Links, große Website, die um das Crawl-Budget konkurriert | Interne Links von häufig gecrawlten Seiten, Sitemap bereinigen |
| Crawled – currently not indexed | Die Seite abgerufen und gelesen, aber nicht indexiert | Dünner Inhalt, Duplikate, Canonical-Konflikte | Einzigartigen Mehrwert ergänzen, Canonical-Tags korrigieren |
| Noindex detected | Die Seite abgerufen und eine noindex-Anweisung gefunden | Ein Plugin oder ein Tag auf Template-Ebene | Das noindex-Tag entfernen, dann ein erneutes Crawling anfordern |
Lautet Ihr Status „discovered“, hilft es noch nichts, die Seite umzuschreiben, denn Google hat sie ja noch nicht gelesen. Diesen Fehler machen Website-Betreiber am häufigsten.
Warum Seiten im Status „discovered“ hängen bleiben
Mehrere Bedingungen schieben eine URL in diese Warteposition:
- Geringe Crawl-Nachfrage. Große oder neuere Websites konkurrieren um ein begrenztes Crawl-Budget, und Google stuft Seiten zurück, die es nicht als dringlich ansieht.
- Keine starken internen Links. Eine verwaiste Seite oder eine, die nur von wenig besuchten Beiträgen verlinkt wird, signalisiert geringe Bedeutung.
- Unruhe in der Sitemap. Listet Ihre Sitemap Tausende dünner oder veralteter URLs auf, vertraut Google ihr weniger und crawlt sie langsamer.
- Probleme bei den Serverantworten. Langsame Antworten oder sporadische Fehler während der Besuche des Googlebots können dazu führen, dass er sich zurückzieht.
Die Dokumentation der Google Search Console beschreibt die Status im Bericht „Seitenindexierung“ (Page Indexing) und bestätigt, dass „discovered“ bedeutet, dass die URL gefunden, aber noch nicht abgerufen wurde (Google Search Console Help).
So beheben Sie „Discovered currently not indexed“ in der richtigen Reihenfolge
Gehen Sie diese Schritte nacheinander durch. Wer Inhalte ändert, bevor er Zugriffsprobleme ausgeschlossen hat, steckt meist weiter fest.
Schritt 1: Zugriffsblockaden ausschließen
Prüfen Sie in der robots.txt, ob eine Disallow-Regel die Seite betrifft, und bestätigen Sie mit dem URL-Prüftool (URL Inspection), dass bei „Indexing allowed“ „yes“ steht. Eine vollständige Sperre ist der einzige Fall, in dem eine Indexierungsanfrage wirklich nicht hilft, weil der Googlebot die Seite überhaupt nicht erreichen kann.
Schritt 2: Interne Links stärken
Das ist meist die Maßnahme mit dem größten Effekt. Verlinken Sie die hängende Seite von Seiten aus, die Google bereits häufig crawlt, etwa von Ihrer Startseite, einem stark besuchten Beitrag oder einer Übersichtsseite, dann wird die neue URL in denselben Crawl-Zyklus gezogen. Wenn Sie eine umfassendere Content-Strategie aufbauen, bei der sich Seiten gezielt statt wahllos verlinken, zeigt die Roadmap zur Zero-Click-Search-Strategie, wie Sie Inhalte so strukturieren, dass sie sowohl Crawl-Priorität als auch Zitierungen erhalten.
Schritt 3: Die Sitemap bereinigen
Entfernen Sie dünne, weitergeleitete oder mit noindex versehene URLs aus Ihrer Sitemap. Eine Sitemap voller wenig wertvoller Seiten verwässert das Vertrauen in die guten.
Schritt 4: Die Indexierung einmal anfordern
Wenn das alles erledigt ist, fordern Sie in der Search Console die Indexierung der betreffenden URL an. Das erzwingt die Indexierung nicht von selbst, schiebt die Seite in der Crawl-Warteschlange aber nach oben, sobald die eigentlichen Hindernisse beseitigt sind.
Können Sie das selbst beheben?
In den meisten Fällen ja. Die robots.txt prüfen, eine Sitemap bereinigen und interne Links setzen kann ein Website-Betreiber ohne Entwickler erledigen. Schwieriger wird es, wenn Sie herausfinden müssen, warum ein ganzer Bereich einer Website dauerhaft zu selten gecrawlt wird, denn das deutet oft auf Probleme bei Architektur oder Performance hin, die ein technisches Audit verdienen. Wenn Sie außerdem entscheiden, welche Seiten den Aufwand wert sind und welche Sie aufgeben, ist Engagement-Signale zu nutzen, statt mehr Inhalte zu veröffentlichen ein hilfreicher Weg zur Priorisierung.
Häufig gestellte Fragen
Bedeutet „Discovered currently not indexed“, dass meine Seite abgestraft wurde?
Nein. Der Googlebot hat die Seite lediglich noch nicht gecrawlt, und das ist eine Entscheidung über Zeitplanung und Priorität auf Grundlage von Crawl-Budget und interner Verlinkung.
Wie lange dauert die Behebung in der Regel?
Das hängt von Größe und Autorität der Website ab, doch viele Seiten verlassen diesen Status innerhalb weniger Tage bis zu ein paar Wochen, sobald die Probleme bei interner Verlinkung und Sitemap behoben sind.
Beheben Backlinks eine Seite mit dem Status „Discovered currently not indexed“?
Externe Backlinks können helfen, indem sie Traffic und Verweissignale erzeugen, sind aber selten die eigentliche Lösung. Starke interne Links von Seiten, die Google ohnehin häufig crawlt, wirken tendenziell schneller.
Sollte ich jeden Tag erneut auf „Request Indexing“ klicken?
Nein. Wiederholte Anfragen helfen nicht, solange die zugrunde liegende Ursache nicht behoben ist, und können wie Spam wirken. Beheben Sie zuerst die Zugriffs- und Verlinkungsprobleme und fordern Sie die Indexierung dann einmal an.
Ist das dasselbe wie ein noindex-Tag?
Nein. Google muss eine Seite crawlen, bevor es ein noindex-Tag beachten kann, deshalb erscheint das als „crawled“, nicht als „discovered“. Eine echte Sperre in der robots.txt dagegen verhindert den Abruf vollständig und hält eine Seite unbegrenzt im Status „discovered“.
Verschaffen Sie sich einen klaren Überblick über Ihren Indexierungsstatus
Zu raten, welche Seiten hängen und warum, kostet Zeit, die Sie nicht haben. Sprechen Sie mit dem Team und fordern Sie einen Beispiel-SEO-Report an, der genau zeigt, welche URLs den Status „Discovered currently not indexed“ haben, warum und was zuerst zu beheben ist.
Weiterführende Lektüre: Crawled – Currently Not Indexed? Here's the Real Fix.
Quellen
Über den Autor
SearchBlueprint hat diesen Artikel mit der Content-Pipeline recherchiert, geschrieben und bewertet, die unsere Kunden auf ihren eigenen Websites einsetzen. Die Bewertung in der Autorenzeile ist die, die unsere Content-Engine dieser Seite vor der Veröffentlichung gegeben hat. Nichts davon wird von Hand geprüft, und genau das ist der Punkt: Es ist das Ergebnis des Produkts, veröffentlicht dort, wo jeder es nachprüfen kann.