Was ist Suchmaschinen-Indexierung und wie funktioniert sie (und warum Seiten übersprungen werden)
Von Toy Wen Da, Mitgründer · Aktualisiert · 21 Min. Lesezeit
Übersetzt aus dem englischen Original. Auf Englisch lesen
Was ist Suchmaschinen-Indexierung und wie funktioniert sie? Es ist der Vorgang, mit dem eine Suchmaschine eine Seite erfasst, ihren Inhalt in einer durchsuchbaren Datenbank speichert und entscheidet, ob die Seite in den Suchergebnissen erscheinen darf. Ohne Indexierung existiert eine Seite für Google oder Bing nicht, egal wie gut sie ist.

Wenn Sie eine Seite veröffentlicht haben und sich fragen, warum sie bei Google nie auftaucht, liegt die Ursache fast immer in diesem Schritt. Das Crawling findet eine Seite, die Indexierung entscheidet, ob sie behalten wird, und das Ranking bestimmt, wo sie landet, sobald sie im Index ist. Fällt der mittlere Schritt aus, spielt alles andere keine Rolle.
Sie können Ihre Keyword-Recherche perfekt erledigen und einen wirklich nützlichen Artikel schreiben und trotzdem keinen einzigen Besucher bekommen, weil die Seite nie in den Index gelangt ist. Das Problem liegt dann nicht im Ranking, sondern in der Indexierung, und es braucht eine andere Lösung.
Was ist Suchmaschinen-Indexierung?
Suchmaschinen-Indexierung ist der Vorgang, bei dem eine Suchmaschine den Inhalt einer Webseite analysiert und in ihren Index aufnimmt, eine durchsuchbare Datenbank der Seiten, die sie als geeignet für die Anzeige in den Ergebnissen betrachtet. Sie ist die zweite von drei Stufen, die eine Seite durchläuft, bevor sie ranken kann: Crawling, Indexierung und Ranking.
Stellen Sie sich eine Bibliothek vor. Beim Crawling geht der Bibliothekar die Regale ab und notiert, welche Bücher es gibt. Bei der Indexierung wird jedes Buch nach Thema, Autor und Stichwort katalogisiert, damit es in Sekunden wiedergefunden werden kann. Das Ranking entscheidet, welches Buch einem bestimmten Leser zuerst in die Hand gegeben wird.
Indexiert zu sein garantiert keinen Traffic; es bedeutet nur, dass Sie im Spiel sind. Eine Seite muss indexiert sein, bevor sie für irgendetwas ranken kann. Deshalb liegt dieser Schritt unter fast jeder anderen SEO-Entscheidung, auch unter den On-Page- und technischen Entscheidungen, die in den Grundlagen der SEO behandelt werden.
Wie funktioniert Suchmaschinen-Indexierung?
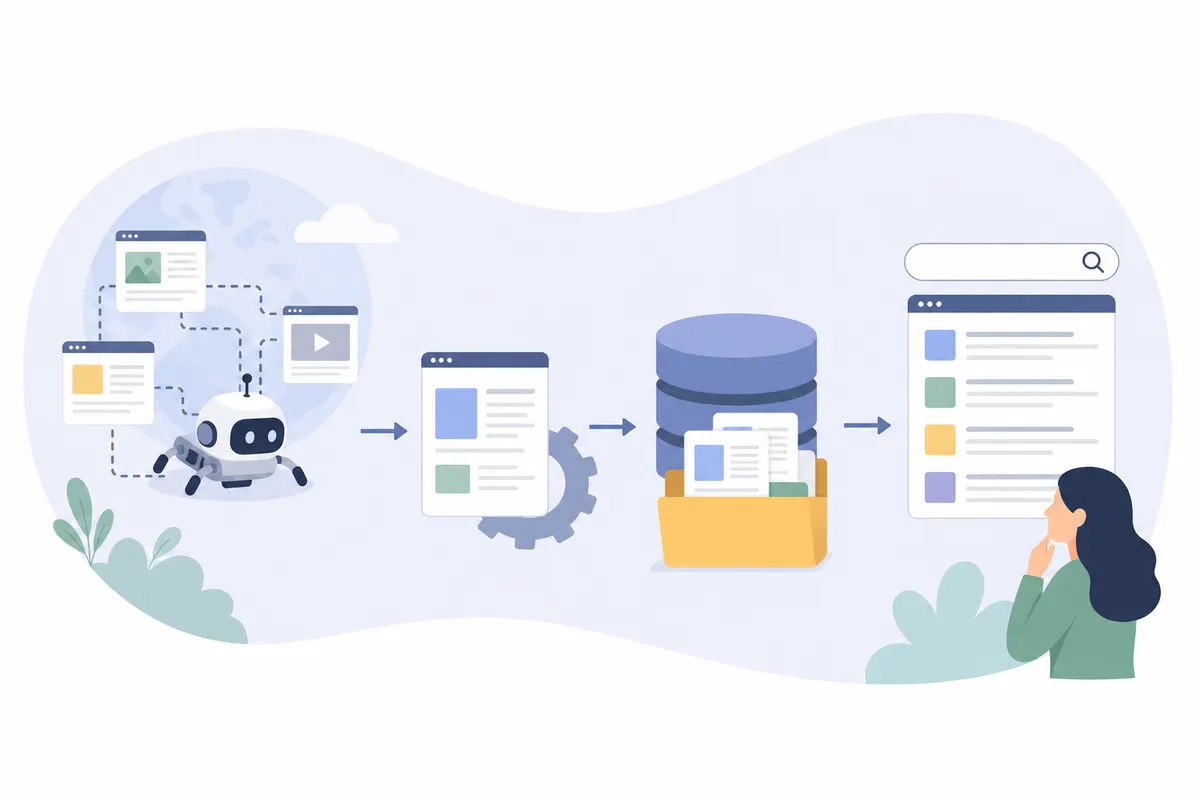
Die Indexierung läuft in einer Abfolge ab. Ein Crawler findet die Seite, die Suchmaschine rendert und analysiert sie, und dann entscheidet sie, ob die Seite einen Platz im Index verdient.
Schritt 1: Das Crawling findet die Seite
Bevor etwas indexiert werden kann, muss es entdeckt werden. Suchmaschinen nutzen automatisierte Programme, oft Crawler, Bots oder Spider genannt, die Links von Seite zu Seite im gesamten Web folgen. Googlebot und Bingbot arbeiten beide so.
Ein Crawler erreicht Ihre Seite entweder über einen Link von einer Seite, die er bereits kennt, oder weil Sie die URL über eine Sitemap oder ein Tool wie die Google Search Console eingereicht haben. Neue Seiten ohne eingehende Links und ohne Sitemap-Eintrag können unbegrenzt unentdeckt bleiben.
Schritt 2: Rendering und Analyse
Sobald ein Crawler auf einer Seite angekommen ist, rendert die Suchmaschine sie ähnlich wie ein Browser und lädt dazu HTML, CSS und JavaScript, um die fertige Seite zu sehen. Laut Google Search Central rendern die Systeme von Google den Seiteninhalt und erfassen wichtige Signale, von Keywords bis zur Aktualität, bevor sie entscheiden, wie sie mit der Seite verfahren.
In diesem Schritt liest die Suchmaschine den Text der Seite, das Title-Tag, die Überschriften, den Alt-Text von Bildern, interne Links und strukturierte Daten. Sie prüft außerdem auf doppelte Inhalte, dünne Inhalte und technische Signale wie Canonical-Tags. Hier beginnt die Qualität der Metadaten eine Rolle zu spielen, und die Signale, die in der tatsächlichen Bedeutung von Metadaten für SEO behandelt werden, fließen direkt in die Einordnung der Seite durch die Suchmaschine ein.
Schritt 3: Die Indexierung speichert, was zählt
Entscheidet die Suchmaschine, dass die Seite genug eigenständigen Wert bietet, speichert sie die URL der Seite und die Inhaltssignale im Index. Das ist der eigentliche Indexierungsschritt: Der Inhalt ist nun Teil der durchsuchbaren Datenbank.
In dieser Phase ermittelt Google auch die Kanonisierung. Zeigen mehrere URLs nahezu identische Inhalte, fasst Google sie zusammen und wählt eine kanonische Version, die die Gruppe in den Ergebnissen vertritt. Die übrigen werden als Alternativen behalten, erscheinen aber in der Regel nicht eigenständig.
Schritt 4: Das Ranking entscheidet, was angezeigt wird
Indexiert zu sein bedeutet nicht, dass eine Seite bei jeder passenden Suchanfrage erscheint. Das Ranking ist der eigene, fortlaufende Prozess, indexierte Seiten für eine bestimmte Suchanfrage zu bewerten und in den Ergebnissen zu ordnen. Eine Seite kann monatelang im Index stehen, ohne für ihr Ziel-Keyword die erste Seite zu erreichen.

Crawling, Indexierung und Ranking im Vergleich: warum die Unterscheidung wichtig ist
Im Alltag werden diese drei Begriffe oft austauschbar verwendet, doch es sind unterschiedliche Prozesse mit unterschiedlichen Fehlerquellen. Eine „gecrawlte“ Seite wurde schlicht besucht. Eine „indexierte“ Seite wurde gespeichert und für behaltenswert befunden, und eine Seite, die „rankt“, konkurriert um eine bestimmte Suchanfrage.
| Stufe | Was passiert | Wer/was führt sie aus | So sieht ein Fehler aus |
|---|---|---|---|
| Crawling | Der Bot entdeckt die URL und besucht sie | Googlebot, Bingbot oder andere Crawler | URL wurde nie besucht; keine Links oder Sitemap-Einträge, die auf sie verweisen |
| Indexierung | Der Inhalt wird analysiert und im Index gespeichert | Die Indexierungssysteme der Suchmaschine | Seite gecrawlt, aber als „Crawled – currently not indexed“ markiert |
| Ranking | Indexierte Seiten werden für eine Suchanfrage bewertet und geordnet | Ranking-Algorithmus, bei jeder Suche angewendet | Seite indexiert, versinkt aber für ihr Ziel-Keyword auf Seite 5 oder weiter hinten |
Eine Seite kann gecrawlt werden, ohne indexiert zu werden. Weit seltener kann eine Seite sogar indexiert sein, ohne dass sie kürzlich vollständig gecrawlt wurde, wenn Google bereits ältere Daten zu ihr hat. Wer die Stufen getrennt hält, kann Fehler viel leichter eingrenzen, denn „sie rankt nicht“ und „sie ist nicht indexiert“ sehen dann nicht mehr wie derselbe Fehler aus.
Was ist ein Suchmaschinen-Index?
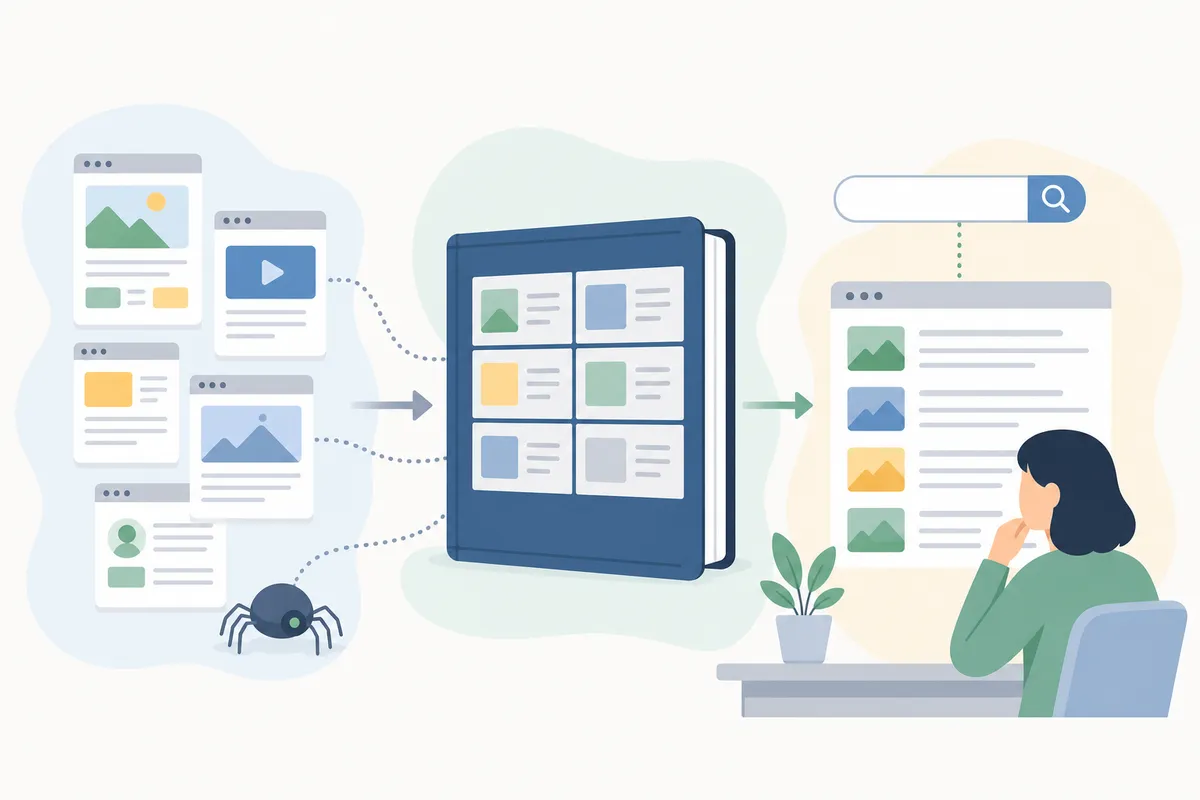
Ein Suchmaschinen-Index ist die riesige, laufend aktualisierte Datenbank, die eine Suchmaschine aufbaut, indem sie Informationen über Webseiten crawlt und speichert. Wenn Sie eine Suchanfrage eingeben, durchsucht die Suchmaschine tatsächlich diesen Index, nicht das Live-Internet.
Die Suchmaschine holt Treffer aus diesem vorab aufgebauten Index, statt das Web in Echtzeit zu durchsuchen. Deshalb kommen die Ergebnisse in Sekundenbruchteilen, selbst wenn Milliarden von Seiten im Spiel sind. Der Index enthält die URL jeder Seite, eine Zusammenfassung ihres Inhalts und Metadaten wie Sprache, Ortsbezug und Mobilfreundlichkeit.
Jede große Suchmaschine pflegt ihre eigene Version dieser Struktur, und die Aufnahme in einen Index bedeutet nicht automatisch die Aufnahme in einen anderen.
Was ist ein invertierter Index?
Ein invertierter Index ist die Datenstruktur, die diese blitzschnelle Suche möglich macht. Statt die Daten nach Seiten zu ordnen („diese Seite enthält diese Wörter“), ordnet er sie nach Wörtern: „dieses Wort kommt auf diesen Seiten vor“.
Wenn Sie nach „beste Laufschuhe“ suchen, durchsucht die Suchmaschine nicht jede Seite nach diesen Wörtern. Sie schlägt „beste“ und „Laufschuhe“ im invertierten Index nach, holt die Liste der Seiten, die bereits mit jedem Begriff verknüpft sind, bildet dann die Schnittmenge und bewertet diese.
Das ist ein Hauptgrund dafür, dass sich die Suche im Maßstab des heutigen Webs augenblicklich anfühlt. Es ist auch der Grund, warum die Keyword-Relevanz weiterhin zählt: Wenn die Wörter Ihrer Seite nie den richtigen Einträgen zugeordnet wurden, taucht sie für die Suchanfrage nicht auf, selbst wenn sie sonst gut indexiert ist. Klare, gut strukturierte Inhalte, wie sie in einem praktischen Leitfaden zur On-Page-SEO beschrieben werden, liefern dem Index eine saubere Sprache, mit der er arbeiten kann.

Mobile-First-Indexierung: warum die Version zählt, die der Googlebot sieht
Seit 2023 indexiert Google standardmäßig die mobile Version einer Seite statt der Desktop-Version, eine Umstellung, die es Mobile-First-Indexierung nennt. Das Search-Central-Team von Google bestätigte in seinem offiziellen Blog, dass die Umstellung im gesamten Web im Wesentlichen abgeschlossen war. Googlebot Smartphone ist inzwischen der primäre Crawler, mit dem der Index für praktisch jede Website aufgebaut wird, und der ältere Desktop-Crawler ist einer kleinen Zahl von Ausnahmen vorbehalten.
Indexiert wird, was die mobile Version tatsächlich enthält, nicht das, was ein Desktop-Besucher sieht. Inhalte hinter einem mobilen Akkordeon oder Tab zu verbergen, ist in der Regel unproblematisch und wird weiterhin indexiert. Anders sieht es bei Inhalten aus, die im mobilen HTML ganz fehlen: gekürzte Navigation, verkürzte Produktbeschreibungen oder strukturierte Daten, die nur dem Desktop-Template hinzugefügt wurden, sind für Google schlicht nicht vorhanden und können nicht indexiert werden.
Websites, die noch eine separate mobile Subdomain betreiben, meist mit dem Präfix m., tragen ein zusätzliches Risiko. Wenn die mobile und die Desktop-Version nicht korrekt mit passenden rel=alternate- und rel=canonical-Tags verknüpft sind, kann Google die falsche Version indexieren oder die beiden als Duplikate behandeln und eine verwerfen. Es ist derselbe Kanonisierungskonflikt wie oben beschrieben, nur ausgelöst durch den Gerätetyp statt durch URL-Parameter.
Die praktische Lösung ist Responsive Design: Es gibt dann pro Seite ein HTML-Dokument und eine URL, und die Abweichung zwischen mobil und Desktop entfällt als Quelle von Indexierungsproblemen. Für Websites, die nicht schnell von einem separaten mobilen Template wegkommen, ist der nächstbeste Schritt, die mobile Version auf jedes Element zu prüfen, das indexiert werden soll: Text, Bilder mit Alt-Text und strukturierte Daten.
Wie groß ist der Index? Zahlen von Google und Bing
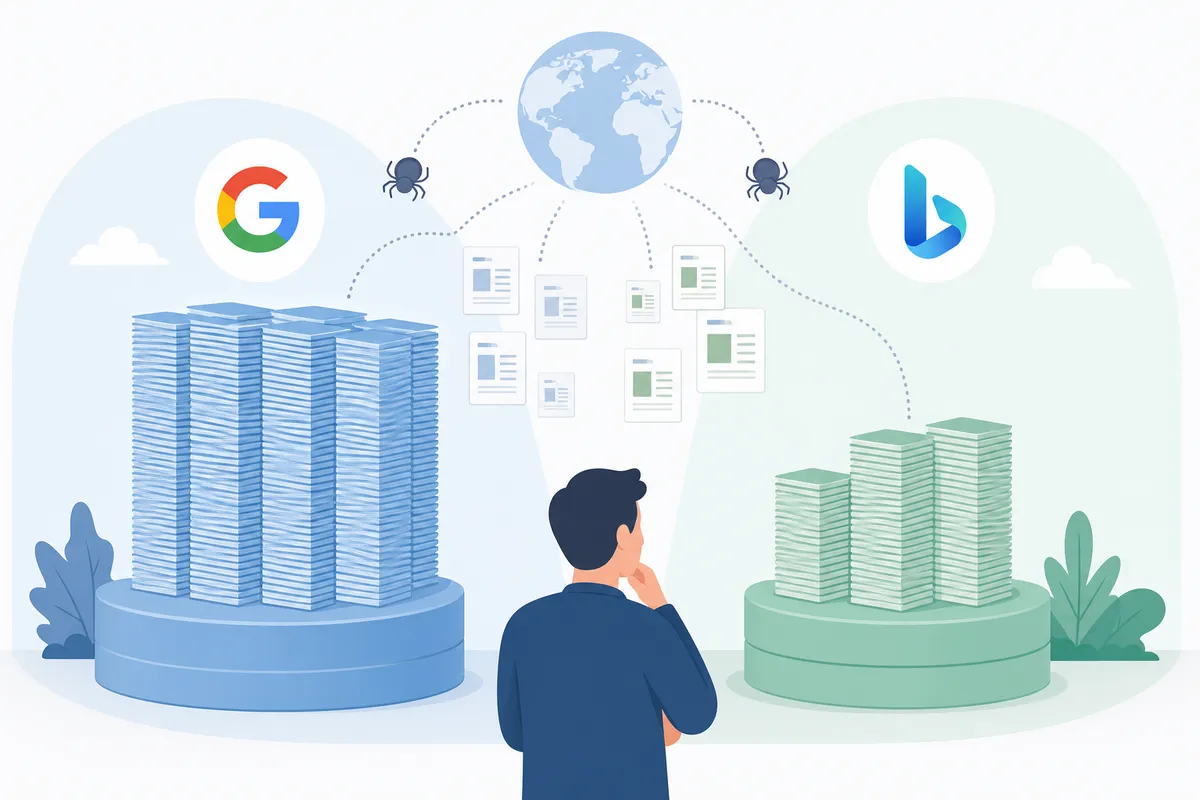
Googles eigene Erläuterung „How Search Works“ besagt, dass der Index Hunderte Milliarden Webseiten enthält und insgesamt weit über 100.000.000 Gigabyte groß ist, aufgebaut aus Systemen, die in Rechenzentren auf der ganzen Welt laufen. Die Zahl verändert sich, denn Google hat erklärt, dass der Index laufend neu aufgebaut wird, während Seiten hinzukommen, aktualisiert oder entfernt werden. Das ist auch ein Grund dafür, dass eine Seite ohne Zutun des Website-Betreibers aus dem Index fallen kann, wie die FAQ unten erläutert.
Microsoft veröffentlicht für Bing keine so detaillierte Zahl. Der Webmaster Blog von Bing hat den Index als einen beschrieben, der zig Milliarden Seiten enthält, aufgebaut aus dem eigenen Crawler Bingbot und aus Daten, die über Partnerschaften geteilt werden. Zu diesen Partnerschaften gehören die Suchdaten hinter den Web-Ergebnissen von Yahoo und hinter den Ergebnissen von DuckDuckGo bei Suchanfragen, für die DuckDuckGo sich nicht auf den eigenen Crawl stützt.
Der Unterschied im Umfang ist ein Grund dafür, dass eine Seite bei Bing problemlos indexiert sein und bei Google trotzdem fehlen kann, oder umgekehrt. Jede Suchmaschine betreibt ihren eigenen Crawler, ihre eigenen Qualitätsfilter und ihren eigenen Index. Eine Diagnose, die nur die Google Search Console prüft, kann ein Bing-spezifisches Problem daher komplett übersehen.
Warum Suchmaschinen-Indexierung für SEO wichtig ist
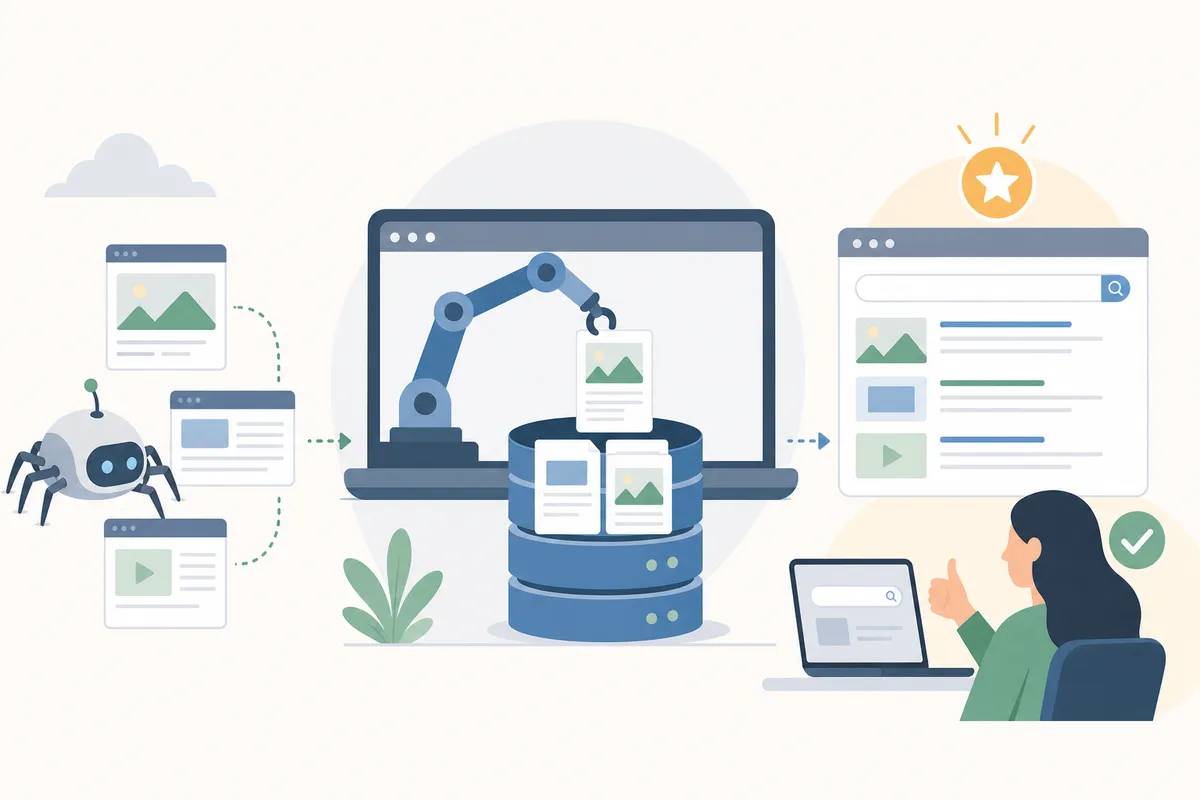
Ist eine Seite nicht indexiert, hat sie keinerlei Chance zu ranken, in einer AI Overview aufzutauchen oder organischen Traffic zu gewinnen. Backlinks, Keyword-Ausrichtung und Inhaltsqualität zahlen sich erst aus, wenn die Indexierung stattgefunden hat.
Damit gehören Indexierungsprobleme zu den teuersten Fehlern auf einer Website. Ein Unternehmen kann wochenlang Inhalte produzieren und nie bemerken, dass sie für Suchmaschinen unsichtbar sind, bis jemand nachsieht. Die Überwachung des Indexstatus gehört neben die Inhaltsproduktion, nicht dahinter. Deshalb enthält ein strukturierter 90-Tage-SEO-Aktionsplan in der Regel eine Indexierungsprüfung als frühen Meilenstein.
Die Indexierung wirkt außerdem als Qualitätsfilter. Google hat klar gesagt, dass es nur Seiten mit echtem Wert in den Index aufnimmt. Seiten mit Keyword-Stuffing, minderwertigen Linkschemata oder dünnen, duplizierten Inhalten werden daher tendenziell markiert oder übersprungen. Core Updates bewerten in regelmäßigen Abständen neu, welche Seiten einer Website überhaupt im Index bleiben sollen. Wenn ein großer Teil der Seiten einer Website die Hürde nicht nimmt, kann Google auch das Crawlen und Indexieren des Rests der Website zurückfahren. Das ist ein Grund dafür, dass eine Handvoll schwacher Seiten die Sichtbarkeit einer ganzen Domain nach unten ziehen kann.
Warum Seiten übersprungen werden: häufige Gründe für gescheiterte Indexierung
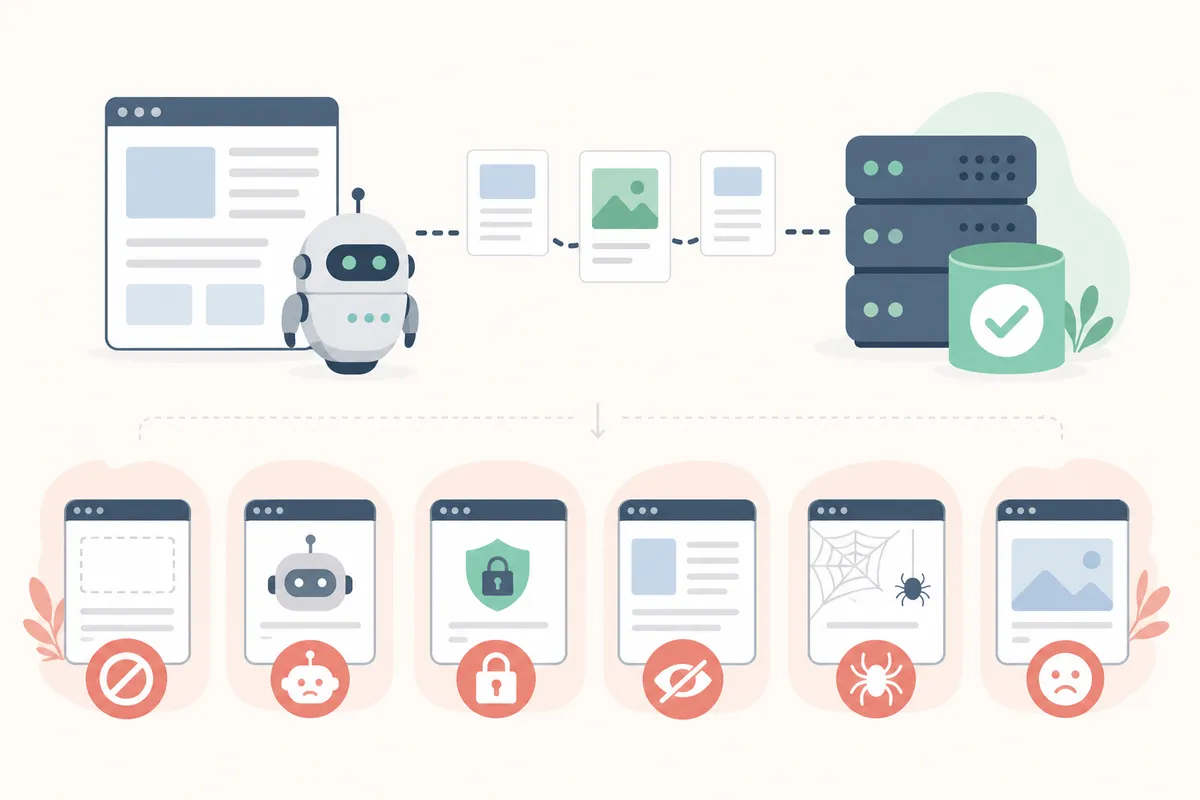
Seiten werden nicht zufällig übersprungen. Es gibt fast immer einen konkreten, diagnostizierbaren Grund, und die meisten fallen unter eine kurze Liste von Dauerverdächtigen.
Dünne oder doppelte Inhalte
Seiten mit wenig eigenständigem Wert sind der häufigste Einzelgrund dafür, dass Google eine Seite nicht indexiert. Typische Beispiele sind kurze Produktseiten mit Herstellertexten, nahezu identische Standortseiten und automatisch erzeugte Filter. Der Crawler hat den Inhalt gesehen, aber die Suchmaschine hat entschieden, dass er es nicht wert ist, separat gespeichert zu werden.
Noindex-Tags und robots.txt-Sperren
Ein noindex-Meta-Tag oder -Header weist eine Suchmaschine direkt an, die Seite nicht zu indexieren. Diese bleiben ständig versehentlich auf Seiten stehen, sei es ein Tag der Staging-Website, der vor dem Launch nie entfernt wurde, oder eine CMS-Voreinstellung, die bestimmte Seitentypen unbemerkt auf noindex setzt. Eine Disallow-Regel in der robots.txt hat eine verwandte, aber andere Wirkung: Sie kann das Crawling ganz blockieren, was die Indexierung mittelbar verhindert. Das Robots-Exclusion-Protokoll ist mehr als eine informelle Konvention, denn die IETF hat es 2022 als RFC 9309 formell standardisiert, und konforme Crawler verschiedener Suchmaschinen beachten alle dieselbe Disallow-Syntax.
Crawl-Budget und Größe der Website
Suchmaschinen teilen jeder Website ein begrenztes Maß an Crawling-Aufmerksamkeit zu, grob bemessen nach Größe, Aktualisierungshäufigkeit und Zustand der Serverantworten. Auf sehr großen Websites können Seiten mit geringem Wert Crawl-Budget verbrauchen, das den Seiten zustehen sollte, die Sie tatsächlich indexiert haben möchten. Manche Seiten werden dann selten oder gar nicht gecrawlt.
JavaScript-lastige Seiten und Single-Page-Apps
Suchmaschinen können JavaScript rendern, aber das ist ein langsamerer, ressourcenintensiverer Schritt als das Lesen von reinem HTML, und er gelingt nicht immer sauber. Inhalte, die erst erscheinen, nachdem clientseitiges JavaScript gelaufen ist, was bei Single-Page-Anwendungen üblich ist, können übersehen oder erst spät indexiert werden. Das ist ein gut dokumentierter Fehlerfall, und warum Single-Page-Apps aus Google verschwinden erklärt die Mechanik ausführlich.
Kanonisierungskonflikte
Wenn ein Canonical-Tag einer Seite auf eine andere URL zeigt, ob absichtlich oder versehentlich, indexiert Google in der Regel die kanonische Version statt der gecrawlten. Ein falsch konfiguriertes Canonical-Tag kann eine ansonsten gute Seite unbemerkt aus dem Index heraushalten, zugunsten der falschen URL.
| Grund für das Überspringen | So sieht es in der Search Console aus | Typische Lösung |
|---|---|---|
| Dünne oder doppelte Inhalte | „Duplicate, Google chose different canonical“ oder „Crawled – currently not indexed“ | Zusammenführen oder mit eigenständigem, substanziellem Inhalt neu schreiben |
| Noindex-Tag oder robots.txt-Sperre | „Excluded by 'noindex' tag“ oder „Blocked by robots.txt“ | Das Tag entfernen oder die Disallow-Regel anpassen |
| Crawl-Budget-Grenzen (große Websites) | „Discovered – currently not indexed“ | Seiten mit geringem Wert entfernen; interne Verlinkung zu Prioritätsseiten verbessern |
| Fehler beim JavaScript-Rendering | Inhalt fehlt in der Cache-/gerenderten Version | Wichtige Inhalte serverseitig rendern oder vorab rendern |
| Kanonisierungskonflikte | „Alternate page with proper canonical tag“ | Falsche Canonical-Tags korrigieren oder entfernen |
Die meisten dieser Fälle gehen auf technische SEO-Grundlagen zurück und nicht allein auf die Inhaltsqualität. Wenn Sie bei vielen Seiten ein Muster von Ausschlüssen sehen, arbeiten Sie die technischen SEO-Korrekturen, die Rankings wirklich bewegen durch, bevor Sie annehmen, dass der Inhalt das Problem ist.
Ein Praxisbeispiel: Eine Seite von der Veröffentlichung bis zum Index verfolgt
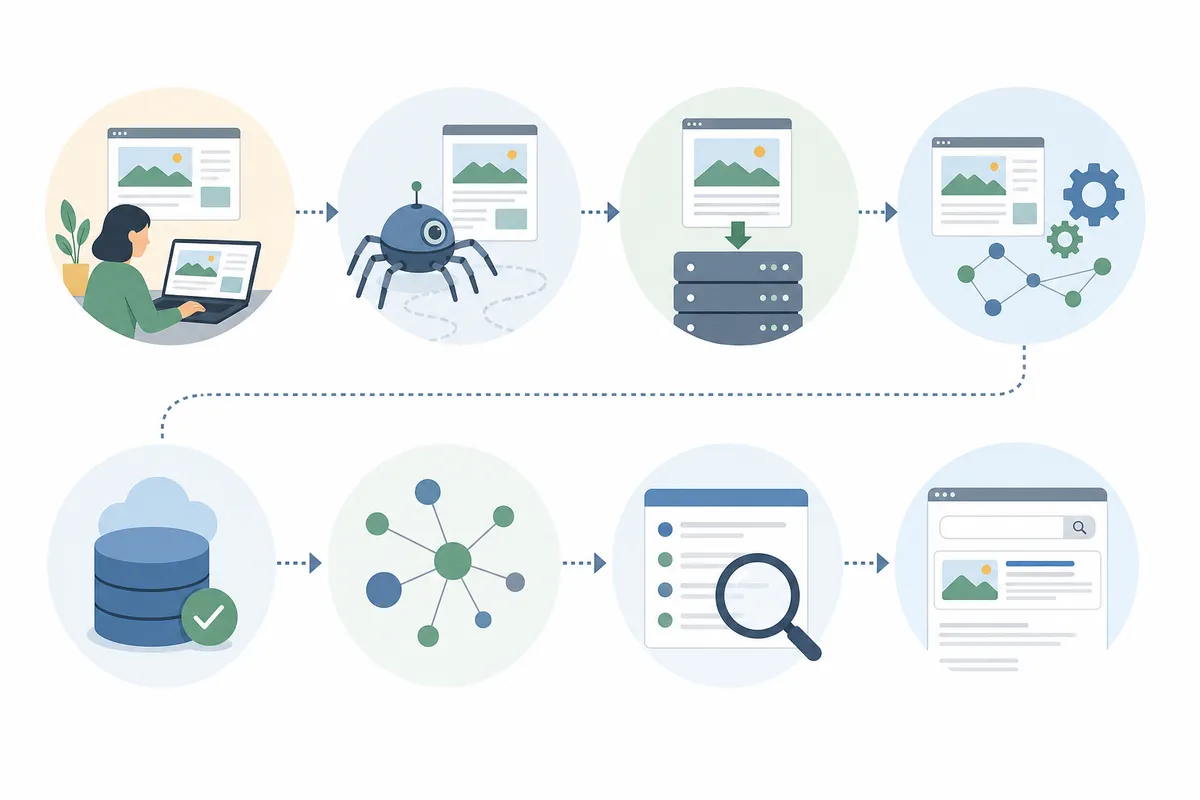
Hier ein realistischer Ablauf für einen neuen Blogbeitrag auf einer etablierten Website mit gesunder Crawl-Historie, dargestellt anhand konkreter Maßnahmen, statt die Indexierung als Black Box zu behandeln.
- Tag 0: Die Seite wird veröffentlicht. Die XML-Sitemap der Website wird automatisch neu erzeugt, sodass die neue URL innerhalb weniger Minuten in die Sitemap-Datei aufgenommen wird.
- Tag 0-1: Andere Seiten verlinken bereits intern auf den neuen Beitrag und die Sitemap ist aktualisiert, sodass der Googlebot die URL beim nächsten geplanten Crawl der Sitemap entdeckt, bei einer etablierten Domain typischerweise innerhalb eines Tages.
- Tag 1-3: Der Googlebot crawlt und rendert die Seite. Das URL-Prüftool der Search Console, an Tag 2 manuell geprüft, zeigt noch nicht „URL is on Google“, aber ein Crawl wurde protokolliert.
- Tag 3-7: Die Seite wird im Vergleich zu den übrigen Inhalten der Website auf Einzigartigkeit und Qualität bewertet. Besteht sie, wird sie in den Index aufgenommen, und der Coverage-Bericht würde etwa an Tag 5-7 typischerweise zeigen, dass die URL von „Discovered – currently not indexed“ (falls sie dort überhaupt erschien) zu „Indexed“ wechselt.
- Ab Tag 7: Die Seite kann in den Suchergebnissen erscheinen und beginnt zu konkurrieren. Aussagekräftige Rankings für einen umkämpften Begriff zu erreichen, kann erheblich länger dauern, aber das gehört zur Ranking-Stufe, die unabhängig von der Indexierung abläuft.
Nehmen wir nun eine brandneue Domain ohne Backlinks und ohne Crawl-Historie. Dieselbe Seite wird möglicherweise gar nicht entdeckt, bis manuell eine Sitemap über die Search Console eingereicht wird, da der Googlebot kein etabliertes Crawl-Muster hat, dem er folgen könnte, und keine interne Link-Power sie heranzieht. Nach der Entdeckung kann sich das Zeitfenster vom Crawl bis zum Index von Tagen auf mehrere Wochen dehnen, und Googles eigene Hinweise räumen ein, dass neue Websites in der Regel länger brauchen, bis sie durchgängig gecrawlt und indexiert werden, als Websites mit etablierter Historie.
Der Unterschied zwischen den beiden Szenarien liegt nicht im Inhalt, sondern in allem, was ihn umgibt: Aktualität der Sitemap, interne Verlinkung und Crawl-Historie der Domain. Deshalb bringt dieselbe Maßnahme, etwa eine Indexierungsanfrage über das URL-Prüftool, auf der einen Website ein Ergebnis noch am selben Tag und auf einer anderen fast nichts. Das Tool schubst nur die Warteschlange an; es setzt die Signale, auf denen die Indexierungsentscheidung beruht, nicht außer Kraft.
Können Sie Indexierungsprobleme selbst beheben?
Ja, in den meisten gängigen Fällen. Ein versehentliches noindex-Tag entfernen, eine robots.txt-Regel korrigieren, eine Sitemap einreichen oder über die Google Search Console die Indexierung einer einzelnen URL beantragen: Das alles kann ein Website-Betreiber ohne Spezialhilfe erledigen, meist in weniger als einer Stunde.
Die Diagnose ist schwerer als die Umsetzung. Die Lösung für „Crawled – currently not indexed“ kann ein überarbeiteter Inhalt sein, eine Canonical-Korrektur, eine Änderung der internen Verlinkung oder ein Crawl-Budget-Problem, und die Search Console sagt nicht immer, was zutrifft. Den Coverage-Bericht richtig zu lesen und zu wissen, welche Ausschlussgründe dringend und welche zu erwarten sind, erfordert etwas Vertrautheit damit, wie Indexierungsentscheidungen getroffen werden.
Ein vernünftiges Vorgehen ist, zuerst die mechanischen Korrekturen zu erledigen: noindex-Tags, robots.txt und Sitemap-Einreichung. Sind Seiten nach einigen Wochen ohne erkennbare Ursache weiterhin nicht indexiert, lohnt sich ein tiefergehendes technisches SEO-Audit.
So werden Ihre Seiten schneller indexiert
Keine dieser Methoden zwingt eine Suchmaschine, eine minderwertige Seite zu indexieren, denn diese Entscheidung hängt weiterhin von Inhalts- und technischen Signalen ab. Sie verkürzen aber die Zeit zwischen Veröffentlichung und Entdeckung, was bei zeitkritischen Inhalten viel ausmacht.
XML-Sitemaps
Eine XML-Sitemap ist eine Datei, die jede URL Ihrer Website auflistet, von der Suchmaschinen wissen sollen. Sie dient Crawlern als Landkarte und weist sie auf Seiten hin, die sie sonst vielleicht übersehen würden, besonders bei großen oder tief verschachtelten Websites. Eine Einreichung garantiert keine Indexierung, beseitigt aber das Problem „der Crawler hat diese Seite nie gefunden“.
Um eine Sitemap in der Google Search Console einzureichen, öffnen Sie den Bericht „Sitemaps“, klicken auf „Add a new sitemap“, geben die Sitemap-URL ein (üblicherweise yoursite.com/sitemap.xml) und senden sie ab. Die Bing Webmaster Tools haben einen entsprechenden Bereich „Sitemaps“ mit im Wesentlichen demselben Ablauf.
Das URL-Prüftool der Google Search Console
Für eine einzelne Seite, die jetzt Aufmerksamkeit braucht, können Sie mit dem URL-Prüftool den Indexierungsstatus einer bestimmten URL prüfen und direkt einen Crawl anfordern. Fügen Sie die URL ein, sehen Sie sich die gemeldeten Probleme an, und wenn nichts die Seite blockiert, beantragen Sie die Indexierung sofort.
Nutzen Sie es für Fälle wie „Ich habe gerade ein noindex-Tag entfernt und möchte, dass Google es schnell bemerkt“. Es ist nicht dafür gedacht, Hunderte von URLs gesammelt einzureichen.
Die Indexing API von Google
Mit der Indexing API von Google können Sie Google programmatisch über neue oder aktualisierte URLs informieren, ohne auf einen Sitemap-Crawl oder eine manuelle Anfrage im URL-Prüftool zu warten. Google sieht sie vor allem für Websites mit kurzlebigen Inhalten wie Stellenanzeigen, Livestream-Seiten und Veranstaltungslisten als nützlich an, wo Geschwindigkeit wichtiger ist als Abdeckung.
Für die Einrichtung müssen Sie ein Google-Cloud-Projekt und ein Dienstkonto anlegen, die Inhaberschaft in der Search Console bestätigen und ein Zugriffstoken erzeugen, was deutlich technischer ist als eine Sitemap. Google empfiehlt weiterhin, zusätzlich eine vollständige Sitemap einzureichen, denn die API ist eine Ergänzung und kein Ersatz.
Bing Webmaster Tools und IndexNow
Die Bing Webmaster Tools bieten eine eigene Funktion zur URL-Einreichung, mit der bis zu 10.000 URLs pro Tag zum nahezu sofortigen Crawlen und Bewerten eingereicht werden können. Seiten, die Bings Qualitätsanforderungen erfüllen, können kurz nach der Einreichung in den Ergebnissen erscheinen.
Bing unterstützt außerdem IndexNow, ein Protokoll, mit dem eine Website Suchmaschinen im Moment der Veröffentlichung, Aktualisierung oder Löschung einer Seite benachrichtigen kann, statt auf den nächsten geplanten Crawl zu warten. Weil teilnehmende Suchmaschinen es gemeinsam nutzen, kann eine einzige Einreichung mehr als eine von ihnen benachrichtigen. Microsoft hat IndexNow als gemeinsame Initiative beschrieben, die es zusammen mit Yandex entwickelt hat, um das wiederholte, spekulative Crawlen zu verringern, auf das sich beide Suchmaschinen sonst stützen, um zu bemerken, dass sich eine Seite geändert hat.
Interne Verlinkung und Backlinks
Eine Seite, auf die andere Seiten Ihrer Website verlinken, besonders Seiten, die Crawler ohnehin oft besuchen, ist leichter zu finden und signalisiert, dass sich ein erneuter Besuch lohnt. Verwaiste Seiten ohne interne Links, die auf sie zeigen, werden mit am langsamsten indexiert. Lücken in der internen Verlinkung zu schließen, ist oft der größere Hebel als jedes Einreichungs-Tool, weil es ein dauerhaftes Signal ist und kein einmaliger Anstoß.
Auch externe Backlinks helfen, denn ein Crawler, der einem Link von einer anderen Website folgt, entdeckt neue Seiten auf einem der ursprünglichen Wege. Soziale Signale können die Entdeckung gelegentlich indirekt beschleunigen, wenn ein geteilter Link angeklickt, gecrawlt oder weiterverlinkt wird, sind aber kein direkter Indexierungsmechanismus wie eine Sitemap oder die Indexing API.
| Methode | Suchmaschine(n) | Am besten geeignet für | Praktische Grenze | Typische Geschwindigkeit |
|---|---|---|---|---|
| XML-Sitemap | Google, Bing | Abdeckung der gesamten Website, fortlaufende Entdeckung | Eine Einreichung deckt die gesamte Website ab | Tage, erneuter Besuch nach Crawl-Zeitplan |
| URL-Prüftool | Eine einzelne dringende Seite | Eine URL zur Zeit | Stunden bis wenige Tage | |
| Indexing API | Google (offiziell Job-/Livestream-Inhalte) | Sich häufig ändernde, kurzlebige Seiten | Tägliches Kontingent pro Projekt | Nahezu sofort nach der Einrichtung |
| URL-Einreichung bei Bing | Bing | Gesammelte Einreichung neuer/aktualisierter Seiten | Bis zu 10.000 URLs pro Tag | Nahezu sofortige Bewertung |
| IndexNow | Bing und teilnehmende Suchmaschinen | Sofortige Benachrichtigung bei Veröffentlichung/Aktualisierung/Löschung | Kein festes Tageslimit angegeben | Nahezu sofortiger Ping |
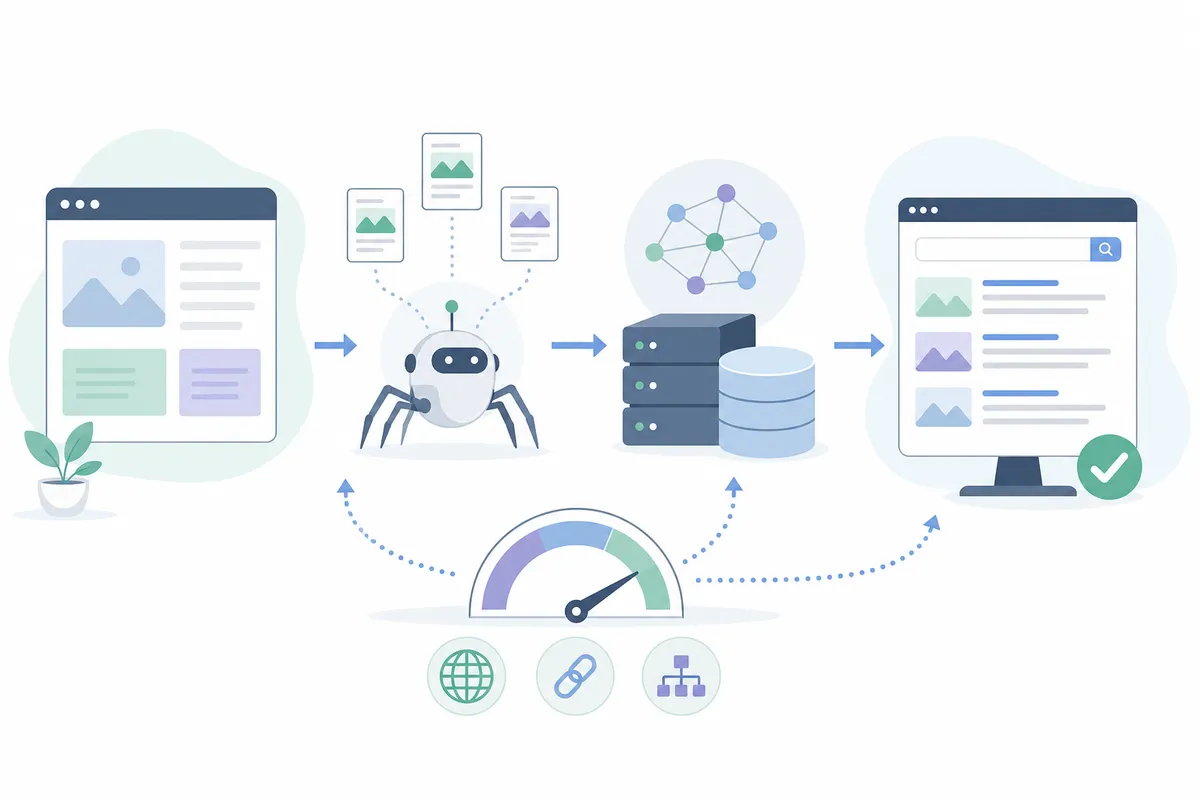
So prüfen Sie, ob Ihre Seiten indexiert sind
Bevor Sie ein Indexierungsproblem beheben, vergewissern Sie sich, dass es besteht. Einige Methoden sind zuverlässig.
- Der Coverage-/Indexierungsbericht der Google Search Console zeigt, welche URLs indexiert und welche ausgeschlossen sind, und nennt den konkreten Grund für jeden Ausschluss. Er ist für Google die genaueste Quelle der Wahrheit.
- Der Suchoperator
site:(die Eingabe vonsite:yourdomain.com/page-urlbei Google) liefert eine schnelle, grobe Prüfung, ist aber bekanntermaßen ungenau, wenn es um exakte Zahlen geht. - Die Bing Webmaster Tools haben eine eigene Berichterstattung zur Indexabdeckung, parallel zu der von Google, für den Bing-spezifischen Status.
- Das URL-Prüftool liefert für Google eine verbindliche Antwort pro Seite, einschließlich des Datums des letzten Crawls und aller erkannten Probleme.
Führen Sie die Prüfung regelmäßig durch und nicht nur einmal nach dem Launch. Seiten können später aus dem Index fallen, etwa wegen eines Website-Relaunchs, eines versehentlich bei einem Template-Update eingeführten noindex-Tags oder eines Core Updates, das die Inhaltsqualität websiteweit neu bewertet.
Google, Bing und DuckDuckGo im Vergleich: wie sich die Indexierung je Suchmaschine unterscheidet
Nicht jede Suchmaschine indexiert das Web auf die gleiche Weise, und die Unterschiede wirken sich darauf aus, wie Sie eine fehlende Seite diagnostizieren.
| Suchmaschine | Eigener Crawler | Eigener Index | Typische Entdeckungsgeschwindigkeit | Wichtigstes Einreichungs-Tool |
|---|---|---|---|---|
| Googlebot | Ja, Hunderte Milliarden Seiten laut Googles eigenen Angaben | Stunden bis Wochen, je nach Autorität der Website | Search Console (Sitemaps, URL-Prüftool, Indexing API) | |
| Bing | Bingbot | Ja, zig Milliarden Seiten laut Bings eigenen Angaben | Ähnlicher Bereich wie bei Google, bei kleinen Websites über IndexNow oft schneller | Bing Webmaster Tools, IndexNow |
| DuckDuckGo | Begrenzt (DuckDuckBot) | Teilweise; kombiniert den eigenen Crawl mit lizenzierten Ergebnissen von Bing | Abhängig davon, welche zugrunde liegende Quelle die Seite liefert | Für die meisten Ergebnisse kein eigenes Einreichungs-Tool |
Google und Bing betreiben beide von Grund auf große Crawler-und-Index-Systeme, deshalb gelten die Lösungen in diesem Leitfaden, etwa Sitemaps, noindex-Prüfungen und IndexNow, für beide, mit nur geringen Unterschieden bei den Tools. DuckDuckGo ist ein anderer Fall. Es hat öffentlich erklärt, dass es einen großen Teil seiner Web-Ergebnisse aus dem Index von Bing bezieht, statt das gesamte Web unabhängig zu crawlen, neben dem eigenen Crawler und Hunderten anderer Quellen. Eine Seite, die bei Bing indexiert ist und rankt, taucht daher weit eher bei DuckDuckGo auf als eine Seite, die nur bei Google indexiert ist, und es gibt kein DuckDuckGo-Pendant zur Search Console, um den Status direkt zu prüfen.
Wenn ein Unternehmen auf Sichtbarkeit über mehrere Suchmaschinen hinweg angewiesen ist, deckt die Bestätigung, dass eine Seite bei Bing indexiert ist, mehr ab, als es scheint, denn dieser eine Index speist mehr als eine Ergebnisseite. Nur site:yourdomain.com bei Google zu prüfen und anzunehmen, dass das Bild überall gleich ist, ist ein verbreiteter blinder Fleck.
Wann Sie bei der Indexierung professionelle Hilfe holen sollten
Die meisten einmaligen Indexierungsprobleme lassen sich ohne fremde Hilfe beheben. Holen Sie sich professionelle Unterstützung, wenn das Muster breiter ist als eine einzelne Seite: große Teile einer Website, die bei „Discovered – currently not indexed“ festhängen, eine Migration, die die Indexierung websiteweit einbrechen ließ, oder ein JavaScript-Framework, das Crawler nie richtig gerendert haben.
Solche Situationen erfordern in der Regel jemanden, der Server-Logs lesen, das tatsächlich gerenderte HTML mit dem vergleichen kann, was ein Crawler sieht, und das Problem durch einen Stapel möglicher Ursachen zurückverfolgt, statt nur eine naheliegende zu prüfen. Wenn Sie regelmäßig neue Inhalte veröffentlichen und möchten, dass sie von Anfang an gut strukturiert und indexierbar sind, sehen Sie sich an, wie Ihr Prozess mit dem Schreiben von SEO-Inhalten, die ranken umgeht, bevor sich das Problem über Dutzende Seiten hinweg verstärkt.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Crawling und Indexierung?
Crawling heißt, dass ein Bot eine Seite entdeckt und besucht. Indexierung heißt, dass die Suchmaschine entscheidet, den Inhalt dieser Seite in ihrer Datenbank zu speichern. Eine Seite kann gecrawlt werden, ohne je indexiert zu werden.
Wie lange dauert die Suchmaschinen-Indexierung?
Das schwankt stark: von Minuten bei einer gut etablierten, häufig gecrawlten Website, die die Indexing API oder IndexNow nutzt, bis zu mehreren Wochen bei einer neuen Website, auf deren Seiten nur wenige interne oder externe Links verweisen.
Warum sollte Google meine Seite crawlen, aber nicht indexieren?
Das bedeutet meist, dass Google den Inhalt für zu dünn hielt, für zu ähnlich zu einer Seite, die es bereits hat, oder für am besten durch eine andere kanonische URL vertreten. Auch technische Sperren wie noindex-Tags können die Ursache sein.
Garantiert das Einreichen einer Sitemap die Indexierung?
Nein. Eine Sitemap hilft Suchmaschinen nur, eine URL schneller zu entdecken. Ob sie indexiert wird, hängt weiterhin von der Inhaltsqualität und von technischen Signalen wie noindex-Tags oder der Kanonisierung ab.
Kann eine Seite ihren Indexstatus verlieren, nachdem sie einmal indexiert war?
Ja. Seiten können später aus dem Index entfernt werden, etwa wegen Inhaltsänderungen, versehentlicher noindex-Tags, Website-Migrationen oder einer Neubewertung bei einem Core-Algorithmus-Update.
Indexiert Google PDFs, Bilder und Videos auf die gleiche Weise wie Webseiten?
Ja, mit Unterschieden. Google kann PDFs indexieren und ihren Text extrahieren. Sowohl Google als auch Bing indexieren Bilder und Videos anhand von Signalen wie Alt-Text, Dateinamen und umgebendem Seiteninhalt, wie Googles eigene Dokumentation zur Indexierung von Bildern und Videos beschreibt, und nicht dadurch, dass sie die Datei visuell verstehen, so wie sie HTML-Text auswerten.
Wie viele Seiten enthält der Index von Google tatsächlich?
Die Seite „How Search Works“ von Google gibt an, dass der Index Hunderte Milliarden Webseiten enthält. Google veröffentlicht keine exakte, laufend aktualisierte Zahl, weil sich der Wert ändert, wenn Seiten hinzukommen und entfernt werden.
Kann ich die Gesamtzahl meiner indexierten Seiten sehen?
Der Bericht „Pages“ im Bereich „Indexing“ der Google Search Console ist die zuverlässigste Zählung für Ihre eigene Website, aufgeschlüsselt in indexierte und nicht indexierte URLs mit einem Grund für jeden Ausschluss. Der Operator site: liefert eine grobe, öffentlich sichtbare Schätzung, aber Google hat davor gewarnt, dass er bei exakten Zahlen nicht genau ist.
Lassen Sie Ihre Indexierungsprobleme diagnostizieren
Die Suchmaschinen-Indexierung ist das Tor, das jede Seite passieren muss, bevor sie ranken kann, und bei den meisten Websites hängen mindestens ein paar Seiten unbemerkt dahinter fest. Am schnellsten finden Sie auf Ihrer eigenen Website heraus, wo das passiert, wenn Sie Ihre tatsächlichen Indexierungs- und Ranking-Daten an einem Ort sehen. Sprechen Sie mit dem Team und holen Sie sich einen Beispielbericht, der zeigt, welche Ihrer Seiten indexiert sind, welche gefährdet sind und was sich zuerst zu beheben lohnt.
Weiterführende Lektüre: Discourage Search Engines From Indexing This Site: A Setup Guide.
Weiterführende Lektüre: "Discovered – Currently Not Indexed": What It Means and How to Fix It.
Quellen
Über den Autor
SearchBlueprint hat diesen Artikel mit der Content-Pipeline recherchiert, geschrieben und bewertet, die unsere Kunden auf ihren eigenen Websites einsetzen. Die Bewertung in der Autorenzeile ist die, die unsere Content-Engine dieser Seite vor der Veröffentlichung gegeben hat. Nichts davon wird von Hand geprüft, und genau das ist der Punkt: Es ist das Ergebnis des Produkts, veröffentlicht dort, wo jeder es nachprüfen kann.