Gecrawlt – zurzeit nicht indexiert? So lösen Sie das Problem wirklich
Von Toy Wen Da, Mitgründer · · 12 Min. Lesezeit
Übersetzt aus dem englischen Original. Auf Englisch lesen
„Gecrawlt – zurzeit nicht indexiert“ (Crawled – currently not indexed) bedeutet: Der Googlebot hat Ihre Seite aufgerufen, sie aber noch nicht in die Suchergebnisse aufgenommen. Meist liegt es an dünnen oder doppelten Inhalten, schwacher interner Verlinkung oder Signalen, die die Seite als unwichtig erscheinen lassen. Dieser Leitfaden behandelt alle drei Ursachen und ihre Lösungen.
Was „Gecrawlt – zurzeit nicht indexiert“ wirklich bedeutet
Wenn der Bericht „Seitenindexierung“ (Page Indexing) in der Google Search Console eine URL mit „Gecrawlt – zurzeit nicht indexiert“ kennzeichnet, ist die Aussage ziemlich konkret. Der Googlebot hat die Seite entdeckt, abgerufen und gerendert. Er hat aber entschieden, sie nicht in dem Index zu speichern, aus dem die Suchergebnisse stammen. Die Seite existiert auf Ihrem Server, und Google hat sie gelesen. Sie kommt bei einer Suchanfrage nur nicht infrage.
Das ist etwas anderes als eine Seite, die Google noch nicht erreicht hat, und auch etwas anderes als eine Seite, die Sie Google ausdrücklich zum Überspringen gemeldet haben. „Gecrawlt – zurzeit nicht indexiert“ liegt dazwischen: Google hat hingeschaut und „noch nicht“ oder „diese nicht“ gesagt.
Wie sich der Status von anderen Nicht-Indexiert-Status unterscheidet
Der Bericht „Seitenindexierung“ fasst ausgeschlossene URLs in mehrere Kategorien zusammen. Sie bedeuten nicht alle dasselbe und erfordern nicht dieselbe Reaktion.
| Status | Bedeutung | Typische Ursache | Nötige Maßnahme |
|---|---|---|---|
| Gecrawlt – zurzeit nicht indexiert | Google hat die Seite gecrawlt, sich aber gegen die Indexierung entschieden | Dünner Inhalt, schwache Links, geringer wahrgenommener Wert | Inhalte/Links verbessern, dann abwarten |
| Gefunden – zurzeit nicht indexiert (Discovered – currently not indexed) | Google kennt die URL, hat sie aber noch nicht gecrawlt | Crawl-Budget-Grenzen, niedrige Priorität in der Warteschlange | Interne Verlinkung verbessern, Geduld haben |
| Ausgeschlossen durch „noindex“-Tag (Excluded by "noindex" tag) | Ein Meta-Tag oder Header hat Google angewiesen, nicht zu indexieren | Absichtliche oder versehentliche noindex-Anweisung | Tag entfernen, wenn die Seite indexiert werden soll |
| Duplicate, Google chose different canonical | Google hat anderswo nahezu identischen Inhalt gefunden und eine andere URL gewählt | Doppelter oder syndizierter Inhalt, fehlender Canonical | Einen klaren Canonical-Tag setzen |
| Soft 404 | Die Seite wirkt leer oder fehlerhaft, obwohl der Statuscode 200 lautet | Fehlende Inhalte, defekte Templates | Seite reparieren oder einen echten 404 zurückgeben |
„Gecrawlt – zurzeit nicht indexiert“ ärgert die Leute am meisten, weil keine offensichtliche Regel verletzt wird. In den meisten Fällen blockiert Google die Seite nicht absichtlich. Es entscheidet nach eigenem Ermessen, ob die Seite einen Platz im Index verdient.
Ist es wirklich ein Problem? Prüfen Sie, bevor Sie reparieren
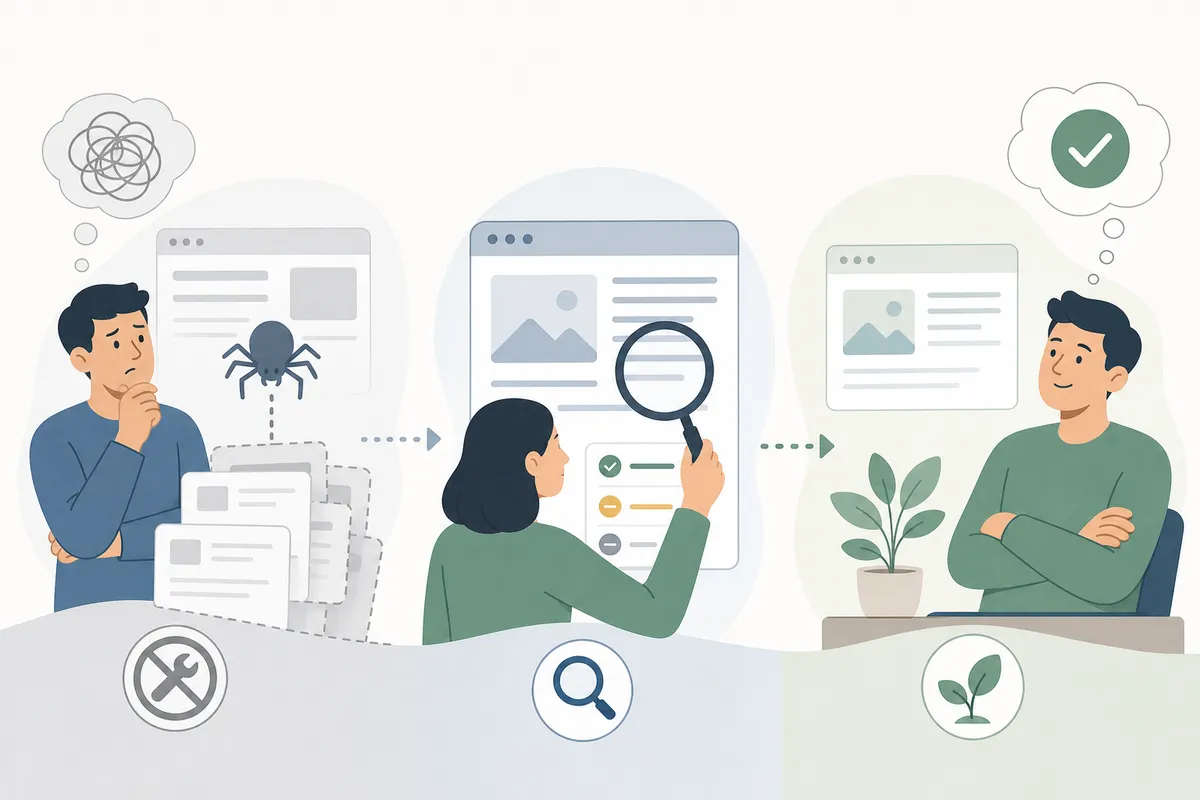
Bevor Sie Stunden in Korrekturen stecken, vergewissern Sie sich, dass das Problem real ist. Der Bericht „Seitenindexierung“ kann der Wirklichkeit hinterherhinken, besonders bei größeren Websites. Eine URL, die als nicht indexiert markiert ist, kann bereits in der Suche live sein.
So prüfen Sie es schnell:
- Öffnen Sie in der Search Console die URL-Prüfung (URL Inspection tool) und sehen Sie sich das Datum des letzten Crawls („last crawled“) an. Ein altes Datum kann bedeuten, dass der Status noch nicht aktualisiert wurde.
- Suchen Sie direkt in Google nach
site:yourdomain.com/the-page-url. Erscheint die Seite, ist sie indexiert, und der Bericht ist nur noch nicht auf dem neuesten Stand. - Bei Dutzenden oder Hunderten betroffener URLs ziehen Sie diese über die Search-Console-API oder einen Crawler wie Screaming Frog heraus. Gleichen Sie sie dann gesammelt mit den Live-Suchergebnissen ab, statt eine nach der anderen zu prüfen.
Wenn die Seite nach dieser Prüfung tatsächlich nicht indexiert ist, klären Sie als Nächstes, ob sie es überhaupt sein sollte.
Seiten, die ruhig gecrawlt, aber nicht indexiert bleiben dürfen
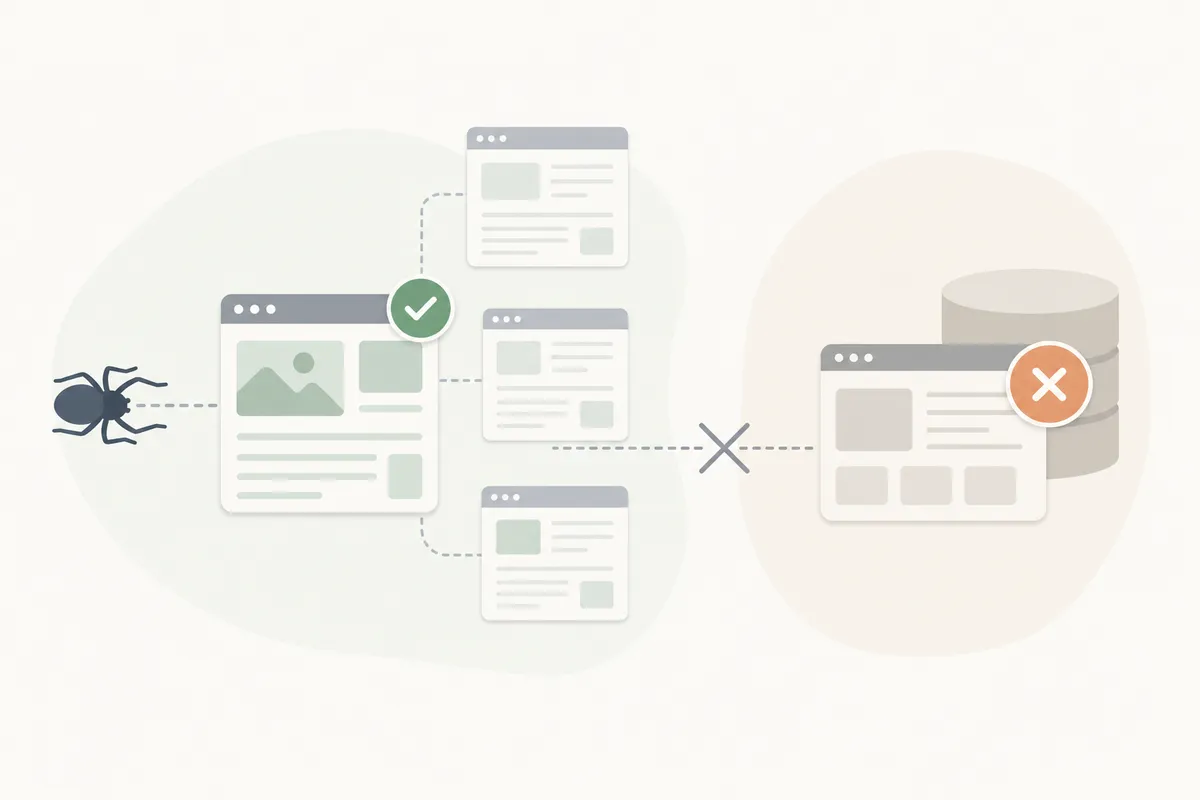
Ein beträchtlicher Teil der Seiten mit dem Status „Gecrawlt – zurzeit nicht indexiert“ muss gar nicht repariert werden. Google lässt sie zu Recht aus. Gehen Sie Ihre Liste durch und trennen Sie die unwichtigen Seiten von den wichtigen.
| Seitentyp | Beispiel | Warum Nicht-Indexierung in Ordnung ist |
|---|---|---|
| Interne Suchergebnisse | /search?q=blue-shoes |
Nahezu doppelter Inhalt, kein eigener Nutzen für Suchende |
| Facettierte/gefilterte URLs | /products?color=red&size=m |
Varianten derselben Katalogseite, verschwenden bei Indexierung Crawl-Budget |
| Dünne Tag- oder Kategorie-Archive | /tag/summer2022 |
Duplizieren Inhalte, die anderswo schon verfügbar sind |
| Abgelaufene Saisonseiten | /temp/new-year-sale-2023 |
Nicht mehr relevant, sobald das Ereignis oder die Aktion vorbei ist |
| RSS-Feeds und Sitemaps | /feed/latest-news, /sitemap.xml |
Für Syndizierung und Auffindbarkeit gedacht, nicht für Suchergebnisse |
Wenn eine Seite aus dieser Kategorie Ihre Berichte unübersichtlich macht, fügen Sie ein noindex-Tag hinzu. Dann taucht sie gar nicht mehr als „Problem“ auf. Das ist eine Aufräumaufgabe, kein Kampf um die Indexierung.
Häufige Ursachen für Seiten, die gecrawlt, aber nicht indexiert sind
Bei Seiten, die tatsächlich ranken sollten, es aber nicht tun, fällt die Ursache fast immer in eine von wenigen Kategorien. Arbeiten Sie sie in der Reihenfolge ab, in der sie in echten Audits am häufigsten auftreten.
Dünne oder wertlose Inhalte
Das ist der mit Abstand häufigste Grund, warum echte Seiten als „gecrawlt, aber nicht indexiert“ hängen bleiben. Manche Audits stufen alles unter etwa 600 Wörtern als Risiko für dünnen Inhalt ein. Die Wortzahl allein ist aber nicht der eigentliche Maßstab. Google fragt sich, ob die Seite etwas bietet, das Suchende nicht schon in einem Dutzend anderer Ergebnisse finden.
Automatisch generierte Texte und Standard-Produktbeschreibungen aus dem Hersteller-Feed gehören in diese Kategorie. Dasselbe gilt für Seiten, die einen Titel in drei Sätzen wiederholen. Wenn Sie in großer Menge Seiten veröffentlichen, um „mehr Keywords abzudecken“, löst genau diese Masse ohne mehr Substanz den Status aus. Ausführlicher behandelt das diese Analyse zu einer Content-Strategie, die auf Feedback statt auf reine Veröffentlichungsmenge setzt.
Doppelte oder nahezu doppelte Inhalte
Wenn dieselben Absätze auf mehreren URLs auftauchen, etwa bei Standortseiten, Druckversionen oder syndizierten Artikeln, indexiert Google eine Version. Die übrigen bleiben gecrawlt, aber nicht indexiert. Das ist erwartetes Verhalten, keine Strafe. Es funktioniert aber nur richtig, wenn Ihre Canonical-Tags auf die Version zeigen, die Sie tatsächlich ranken lassen wollen.
Wer Inhalte anderswo syndiziert, geht ein verwandtes Risiko ein. Wenn die wiederveröffentlichte Kopie besser rankt oder vor dem Original indexiert wird, kann das Original ausgeschlossen werden. Dieser Leitfaden zur Content-Syndizierung ohne selbstverschuldete Duplikatprobleme zeigt, wie Sie Inhalte wiederveröffentlichen, ohne die Indexierung der Quellseite zu beeinträchtigen.
Schwache oder fehlende interne Links
Seiten, auf die keine internen Links zeigen, sogenannte verwaiste Seiten (Orphan Pages), senden ein schwaches Prioritätssignal. Google kann eine URL crawlen, die es in einer Sitemap gefunden hat. Wenn aber nichts auf Ihrer Website auf sie verlinkt, gibt es wenig Grund, sie für wichtig zu halten. Eine dichte, logische interne Verlinkung gehört zu den zuverlässigeren Hebeln, um eine hängende Seite neu bewerten zu lassen.
Crawl-Budget und websiteweite Qualitätssignale
Auf großen Websites ist das Crawl-Budget begrenzt. Der Googlebot kann Seiten bis zu etwa 15 MB rendern, verbringt aber nicht unbegrenzt Zeit auf einer Website voller minderwertiger URLs. Hat Ihre Domain Tausende dünner oder nahezu doppelter Seiten, stuft Google das Crawlen und Indexieren neuer Seiten möglicherweise herab, bis sich die Qualität verbessert. Keyword-Kannibalisierung, bei der mehrere Seiten um dieselbe Suchanfrage konkurrieren, verstärkt das. Google schließt oft alle konkurrierenden Versionen aus, statt zu raten, welche ranken soll.
Veraltete Inhalte
Eine Seite kann inhaltlich stark sein und trotzdem veraltet wirken, wenn sich seit Jahren nichts an ihr geändert hat. Inhalte, die einmal nützlich waren, aber nie überarbeitet werden, rutschen tendenziell in diesen Status. Aktuellere Mitbewerber nehmen ihren Platz im Index ein. Wichtige Seiten aktuell zu halten, ohne sie neu zu schreiben, ist eine der dauerhafteren Methoden, um dem „zurzeit nicht indexiert“-Fegefeuer zu entgehen. Vertieft wird das in Warum Evergreen-Content weiter wächst, statt nach einer Traffic-Spitze zu verblassen.
So beheben Sie Seiten mit dem Status „Gecrawlt – zurzeit nicht indexiert“
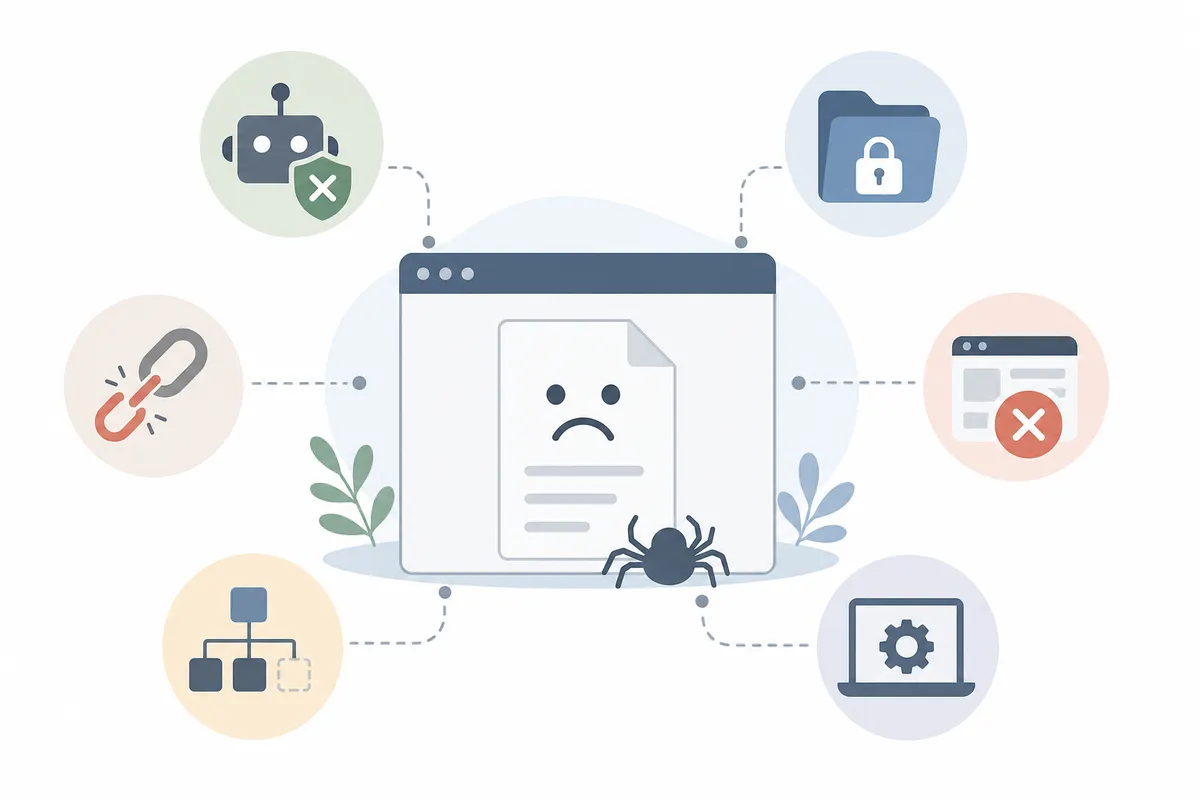
Wenn Sie bestätigt haben, dass eine Seite tatsächlich in den Index gehört, und die wahrscheinliche Ursache eingegrenzt haben, arbeiten Sie die Korrekturen nach Priorität ab. Nicht jede Korrektur wiegt gleich schwer. Verbringen Sie also keine Woche mit internen Links, wenn das eigentliche Problem dünner Inhalt ist.
| Korrektur | Was sie behebt | Typischer Aufwand | Priorität |
|---|---|---|---|
| Inhalte erweitern und stärken | Dünne oder wertlose Seiten | Mittel bis hoch | Hoch |
| Korrekte Canonical-Tags setzen | Doppelte/nahezu doppelte Inhalte | Gering | Hoch |
| Interne Links von relevanten Seiten ergänzen | Verwaiste Seiten, schwache Signale | Gering bis mittel | Hoch |
| robots.txt und Meta-Robots-Tags korrigieren | Versehentliche Blockierung oder noindex | Gering | Hoch |
| Seitengeschwindigkeit und Render-Zuverlässigkeit verbessern | Seiten, die Zeitüberschreitungen verursachen oder unvollständig rendern | Mittel | Mittel |
| Nahezu doppelte Seiten zusammenführen | Keyword-Kannibalisierung | Mittel | Mittel |
| Externe Links auf die Seite aufbauen oder verdienen | Geringe wahrgenommene Autorität | Hoch | Mittel |
| Indexierung über die URL-Prüfung beantragen (Request Indexing) | Google nach einer echten Korrektur anstoßen | Gering | Niedrig |
Prüfen Sie zuerst auf technische Blockaden
Öffnen Sie den Quelltext der Seite und vergewissern Sie sich, dass kein noindex-Meta-Tag und kein X-Robots-Tag-Header vorhanden ist, den Sie nicht beabsichtigt haben. Prüfen Sie die URL dann mit dem robots.txt Tester in der Search Console, um sicherzugehen, dass nichts in dieser Datei den Pfad blockiert. Diese Prüfungen dauern nur Minuten und schließen die einfachste Erklärung aus, bevor Sie annehmen, dass der Inhalt schuld ist.
Inhalte überarbeiten oder erweitern
Ist die Seite dünn, polstern Sie sie nicht mit Füllmaterial auf. Ergänzen Sie die konkreten Informationen, wegen derer Suchende gekommen sind: Preisangaben, einen Vergleich, ein durchgerechnetes Beispiel oder eine echte Antwort auf die Frage. Seiten, die gezielt die Suchintention erfüllen, verlieren diesen Status tendenziell schneller als Seiten, die auf eine Wortzahl getrimmt sind. Für Produkt- und Kategorieseiten finden Sie diese E-Commerce-SEO-Praktiken, die sich daran orientieren, was tatsächlich Umsatz bringt statt nur Traffic. Sie behandeln die inhaltlichen Lücken, die Listing-Seiten hier am häufigsten festhalten.
Interne Verlinkung und Website-Struktur verbessern
Fügen Sie kontextbezogene Links von Seiten hinzu, die bereits gut ranken und dasselbe Thema behandeln. Eine Produktseite ohne einen einzigen internen Link ist zum Beispiel eine klassische verwaiste Seite. Nehmen Sie sie in eine Kategorieseite, einen Block mit verwandten Produkten oder einen passenden Blogbeitrag auf, dann hat Google einen Grund, sie zu indexieren.
Automatisches Monitoring statt manueller Neueinreichung einrichten
Wiederholtes Klicken auf „Indexierung beantragen“ in der Search Console beschleunigt nichts und kann bei übermäßiger Nutzung dazu führen, dass eine URL für eine manuelle Prüfung markiert wird. Besser ist ein Workflow, der den Indexierungsstatus regelmäßig prüft und Seiten meldet, die über ein vernünftiges Zeitfenster hinaus hängen. Dieser Blick auf Automatisierungs-Workflows, mit denen Korrekturen in Tagen statt Wochen live gehen zeigt, wie Sie ein solches dauerhaftes Monitoring aufbauen. Es ersetzt manuelle Einzelprüfungen.
Sehen Sie es auch als Problem der KI-Sichtbarkeit
Eine Seite, die Google nie indexiert, hat auch keine Chance, von KI-Antwortmaschinen zitiert zu werden. Die meisten dieser Tools stützen sich stark auf dasselbe gecrawlte, indexierte Web. Wenn Sie in Inhalte investieren, die in AI Overviews, Perplexity-Antworten oder ChatGPT-Antworten einfließen sollen, ist es wichtig, über „gecrawlt“ hinauszukommen. Der Index ist die erste Hürde, kein optionaler Schritt. Dieser Leitfaden dazu, wie Sie in Perplexity zitiert werden, statt nur gecrawlt zu werden, lohnt sich neben Ihren Indexierungskorrekturen. Das gilt besonders, wenn KI-Sichtbarkeit zu Ihren Zielen gehört. Dieselbe Logik gilt für Produktseiten, die in shoppingbezogene KI-Antworten einfließen. Lesen Sie dazu diesen Beitrag darüber, wie E-Commerce-Produkte von KI-Suche zitiert statt übersprungen werden.
Wie lange dauert die Indexierung nach einer Korrektur?
Es gibt keinen festen Zeitplan, aber realistisch sind Tage bis einige Wochen. So lange braucht Google, um eine Seite nach einer echten Qualitätskorrektur erneut zu crawlen und neu zu bewerten. Größere oder weniger autoritative Websites liegen tendenziell am längeren Ende. Google hat erklärt, dass das erneute Einreichen einer URL über die Search Console nicht erforderlich ist und die Indexierung nicht erzwingt. Die URL wird laut Googles eigener Dokumentation in der Search-Console-Hilfe lediglich etwas früher wieder in die Crawl-Warteschlange aufgenommen.
Bleibt eine Seite länger als einen Monat nach einer Inhalts- und Verlinkungskorrektur gecrawlt, aber nicht indexiert, ist das ein Signal. Das zugrunde liegende Problem wurde nicht vollständig gelöst, also reichen Sie nicht einfach immer wieder neu ein.
Das Wachstum durch behobene Indexierungsprobleme zeigt sich tendenziell allmählich über viele Seiten hinweg und nicht als ein dramatischer Sprung. Das passt zu der Art, wie organisches Wachstum aus einer gezielten Kampagne statt aus einer einzelnen Spitze entsteht. Zu erwarten, dass eine einzelne Neueinreichung den Schalter umlegt, setzt von Anfang an die falsche Erwartung.
So verhindern Sie, dass der Status wiederkehrt
Die heutige Ladung ausgeschlossener Seiten zu beheben, ist weniger wichtig, als das Muster zu stoppen, das sie erzeugt hat. Ein paar Gewohnheiten verhindern, dass die Zahl wieder steigt:
- Veröffentlichen Sie weniger, dafür stärkere Seiten, statt die Website mit dünnen Seiten zu überfluten, nur um Keyword-Volumen hinterherzujagen.
- Prüfen Sie die interne Verlinkung vierteljährlich, damit neue Seiten nie als verwaiste Seiten starten.
- Pflegen Sie einen festen Zeitplan für Content-Aktualisierungen, statt ältere Seiten veralten und mit der Zeit aus dem Index rutschen zu lassen.
- Werfen Sie monatlich einen Blick in den Bericht „Seitenindexierung“, nicht nur, wenn etwas auffällig aussieht.
- Betrachten Sie die Indexierungsgesundheit als ein System, nicht als eine Reihe unzusammenhängender Feuerwehreinsätze. Diese Denkweise behandelt dieses Framework, das SEO-Know-how als wiederholbares System aufbaut, statt einzelnen Tricks nachzujagen.
Man sollte auch bedenken, dass die Indexierung allein nicht das Ziel ist. Eine indexierte Seite, die niemand anklickt oder zitiert, bleibt hinter ihren Möglichkeiten zurück. Diese Roadmap dazu, in Zero-Click-Suchumgebungen Zitierungen zu gewinnen, statt nur Klicks zu jagen, ist eine nützliche nächste Lektüre. Sehen Sie sie sich an, sobald sich Ihre Indexierungszahlen stabilisiert haben.
Wann Sie externe Hilfe hinzuziehen sollten
Angenommen, Sie haben Inhaltsqualität, Canonical-Tags, robots.txt, Meta-Tags und interne Links geprüft. Seiten hängen nach mehreren Wochen trotzdem mit dem Status „Gecrawlt – zurzeit nicht indexiert“ fest. Dann kann die Ursache ein websiteweites Vertrauens- oder Crawl-Budget-Problem sein, das sich Seite für Seite schwerer diagnostizieren lässt. Häufige Verdächtige sind eine kürzlich durchgeführte Migration, ein starker Zustrom minderwertiger Seiten, der die Domain verwässert, oder widersprüchliche technische Signale über Templates hinweg. Dann lohnt sich in der Regel ein umfassenderes technisches Audit. Lassen Sie es von jemandem durchführen, der die ganze Website überblickt und nicht nur eine URL nach der anderen.
Häufig gestellte Fragen
Bedeutet „Gecrawlt – zurzeit nicht indexiert“, dass meine Seite einen Fehler hat?
Nein. Es bedeutet, dass Google die Seite erfolgreich gecrawlt und sich gegen die Indexierung entschieden hat. Das ist meist eine Entscheidung über Inhaltsqualität oder Priorität, kein technischer Fehler. Ein echter Fehler würde sich normalerweise als 4xx-, 5xx- oder Soft-404-Status zeigen.
Sollte ich die URL alle paar Tage in der Search Console neu einreichen?
Nein. Google hat erklärt, dass erneutes Einreichen die Indexierung weder beschleunigt noch erzwingt. Wiederholtes Einreichen derselben URL kann dazu führen, dass sie für eine manuelle Prüfung markiert wird, ohne dass es hilft. Beheben Sie zuerst die zugrunde liegende Ursache, beantragen Sie die Indexierung einmal und beobachten Sie dann.
Kann eine Seite von „gecrawlt, zurzeit nicht indexiert“ von selbst in „vollständig indexiert“ wechseln?
Ja, manchmal. Google überdenkt eine Seite gelegentlich im Lauf der Zeit, wenn sich andere Signale auf der Website verbessern, auch ohne direkte Änderung an dieser Seite. Man kann sich nicht darauf verlassen, aber es kommt vor.
Liegt dünner Inhalt immer unter einer bestimmten Wortzahl?
Nicht unbedingt. Die Wortzahl ist ein grober Anhaltspunkt, nicht die eigentliche Regel. Manche Audits markieren alles unter 600 Wörtern, aber eine kurze Seite, die eine enge Frage vollständig beantwortet, kann trotzdem indexiert werden. Eine lange Seite, die mit Füllmaterial aufgebläht ist, kann trotzdem ausgeschlossen werden.
Schadet es dem SEO meiner gesamten Website, wenn viele Seiten diesen Status haben?
Eine Handvoll absichtlich nicht indexierter Hilfsseiten schadet Ihnen nicht. Eine große Menge wirklich minderwertiger Seiten, die hier festhängen, kann dagegen beeinträchtigen, wie Google die Gesamtqualität und die Crawl-Priorität Ihrer Website bewertet. Aufräumen lohnt sich mehr, als es zu ignorieren.
Verschaffen Sie sich einen klaren Überblick über Ihre eigenen Indexierungsprobleme
Ihr Bericht „Seitenindexierung“ vermischt Seiten, die Sie getrost ignorieren können, mit solchen, die Sie tatsächlich Traffic kosten. Beides auseinanderzuhalten erfordert mehr als einen Blick auf die Liste. Man muss Inhaltsqualität, Links und technische Signale Seite für Seite prüfen. Wenn Sie diese Auswertung lieber für Ihre eigene Website aufbereitet sehen möchten: Sprechen Sie mit dem Team und fordern Sie einen Beispielbericht an. Er zeigt genau, was Seiten daran hindert, über „Gecrawlt – zurzeit nicht indexiert“ hinauszukommen.
## Ressourcen / Referenzen

1. [Googles eigene Dokumentation in der Search-Console-Hilfe](https://support.google.com/webmasters/answer/7440203)

## Quellen

- [How We Fix 'Crawled - currently not indexed' on Google ...](https://www.embarque.io/post/how-we-fix-crawled-currently-not-indexed-on-google-search-console)
- [Crawled – Currently Not Indexed in Google Search Console](https://seosly.com/blog/crawled-currently-not-indexed-in-google-search-console/)
- [Understanding and resolving 'Discovered - currently not ...](https://searchengineland.com/understanding-resolving-discovered-currently-not-indexed-392659)
- [Crawled - currently not indexed' mean and how do you fix it?](https://www.quora.com/In-Google-Search-Console-what-does-Excluded-Crawled-currently-not-indexed-mean-and-how-do-you-fix-it)
- [Crawled - Currently Not Indexed: Proven Ways to fix.](https://the7eagles.com/crawled-currently-not-indexed/)
Über den Autor
SearchBlueprint hat diesen Artikel mit der Content-Pipeline recherchiert, geschrieben und bewertet, die unsere Kunden auf ihren eigenen Websites einsetzen. Die Bewertung in der Autorenzeile ist die, die unsere Content-Engine dieser Seite vor der Veröffentlichung gegeben hat. Nichts davon wird von Hand geprüft, und genau das ist der Punkt: Es ist das Ergebnis des Produkts, veröffentlicht dort, wo jeder es nachprüfen kann.