A busca em cache do Google acabou: como ver páginas em cache agora
Por Toy Wen Da, Cofundador · Atualizado em · 7 min de leitura
Traduzido do original em inglês. Ler em inglês
A busca em cache do Google não existe mais como recurso nativo. O operador de busca cache: parou de funcionar, o link "Em cache" sumiu dos snippets dos resultados e o Google agora indica a Wayback Machine. Você ainda consegue ver um snapshot antigo de quase qualquer página; só precisa de outra ferramenta.
Este guia mostra o que mudou e quando, e depois explica as formas práticas de abrir hoje uma versão em cache ou arquivada de uma página, seja você alguém que pesquisa, dono de site ou alguém conferindo o que o Googlebot viu por último.
O que "cache do Google" significava
Durante anos, todo resultado do Google trazia uma pequena seta ou um menu de três pontos ao lado da URL. Ao clicar, abria-se uma cópia armazenada da página como o rastreador do Google a viu pela última vez, com o HTML e as imagens intactos. A cópia era mantida por velocidade e como backup, e o Google nunca a pensou como um arquivo permanente.
Ela era mais importante quando um site saía do ar, quando uma página era editada sem aviso ou quando você precisava ver como o conteúdo estava numa data específica de rastreamento. Investigadores, jornalistas e profissionais de SEO recorriam a ela justamente para essas tarefas.
O que aconteceu com o recurso de cache do Google
O Google retirou o link de cache dos snippets de busca no início de 2024 e depois desativou por completo o recurso por trás dele. No fim de outubro de 2024, o operador cache: já não retornava nada, e o Google o removeu de sua documentação de ajuda. A explicação do Google foi que a web moderna é mais confiável do que era no início dos anos 2000, então um cache criado principalmente como alternativa para quedas deixou de compensar o custo de manutenção.
No lugar dele, o Google fechou uma parceria com o Internet Archive. A partir de setembro de 2024, o painel "About this result" (Sobre este resultado) passou a levar ao snapshot correspondente da Wayback Machine, em vez de uma cópia hospedada pelo Google. Se você quer entender indexação e cache como sistemas separados, leia como a indexação realmente funciona e por que algumas páginas ficam de fora antes de presumir que a falta de cache significa a falta de uma entrada no índice.
Como ver páginas em cache agora
Você tem três opções realistas, e cada uma mostra algo um pouco diferente.
Opção 1: o painel "About this result"
Faça sua busca, clique nos três pontos ao lado de um resultado e abra "About this result" (Sobre este resultado). Role até "More about this page" (Mais sobre esta página) e você encontrará um link para o histórico dessa URL na Wayback Machine. Ao clicar, você chega à linha do tempo da página no Internet Archive, com os snapshots salvos listados por data.
Opção 2: ir direto à Wayback Machine
Se você já sabe a URL, pule o Google e pesquise diretamente na Wayback Machine. Ela guarda snapshots da web aberta desde 1996, então, para uma página mais antiga ou de maior tráfego, você muitas vezes encontra mais histórico do que o Google jamais mostrou. Escolha uma data no calendário e veja o que carregava naquele dia.
Opção 3: Inspeção de URL no Search Console
No Google Search Console, informe a URL, execute um Live Test (Testar URL ao vivo), clique em View Tested Page (Ver página testada) e depois em Screenshot (Captura de tela). Você obtém uma renderização nova da página ao vivo atual, gerada no momento em que você pede, então ela não diz o que o Googlebot viu meses atrás. Use-a para confirmar o que o Googlebot vê agora.
Cache do Google x Wayback Machine x Search Console
| Ferramenta | O que ela mostra | Profundidade histórica | Melhor uso |
|---|---|---|---|
| Cache do Google (aposentado) | Um snapshot HTML armazenado do último rastreamento do Google | Nenhuma, o recurso acabou em fevereiro de 2024 | Não se aplica mais |
| Wayback Machine | Um snapshot arquivado de uma data de salvamento específica | Desde 1996, quando a página foi capturada | Recuperar conteúdo perdido, conferir o histórico de uma página |
| Inspeção de URL do GSC | Uma renderização atual e ao vivo da página | Nenhuma, só em tempo real | Confirmar o que o Googlebot vê hoje |
| Cache do Bing (aposentado) | Um snapshot armazenado do rastreamento do Bing | Nenhuma, removido em 11 de dezembro de 2024 | Não se aplica mais |
Por que o Google aposentou os links de cache
As reportagens desde a mudança apontam várias causas.
- A confiabilidade melhorou. Menos sites saem totalmente do ar como na era da internet discada, então o caso de uso "a página está temporariamente fora do ar" diminuiu.
- As páginas modernas são renderizadas com JavaScript, fontes e scripts de rastreamento que um snapshot HTML estático trata mal, e um cache com aparência quebrada fazia mais mal do que bem para a experiência do usuário.
- A Wayback Machine já faz arquivamento em escala, então o Google enviou o tráfego para lá em vez de manter um sistema paralelo.
O Bing seguiu a mesma lógica em 11 de dezembro de 2024, aposentando o próprio link de cache porque, nas palavras da Microsoft, a internet tinha "evolved for better reliability" (evoluído para ter mais confiabilidade) e muitas páginas, de qualquer forma, não eram otimizadas para a visualização em cache. O cache do Yahoo, que dependia dos dados de rastreamento do Bing, deixou de funcionar discretamente mais ou menos na mesma época, sem anúncio formal.
O que isso significa para o seu trabalho de SEO
Perder o link de cache não muda como a indexação ou o ranqueamento funcionam. Muda a forma de verificá-los, e alguns hábitos precisam de atualização:
- Pare de dizer aos clientes para "conferir o cache" para confirmar que o Google tem uma página; use a Inspeção de URL no Search Console.
- Se você usava snapshots em cache para acompanhar mudanças de concorrentes, passe para a Wayback Machine, que tem um histórico mais profundo do que o cache do Google jamais ofereceu.
- Os aplicativos de página única são os que mais perdem aqui, já que a visualização do cache era uma das poucas maneiras de checar o que uma página repleta de JavaScript renderizava. Nosso guia sobre por que aplicativos de página única somem da busca do Google trata dos problemas de renderização mais profundos que isso expõe.
Motivos comuns para uma página não mostrar uma cópia arquivada
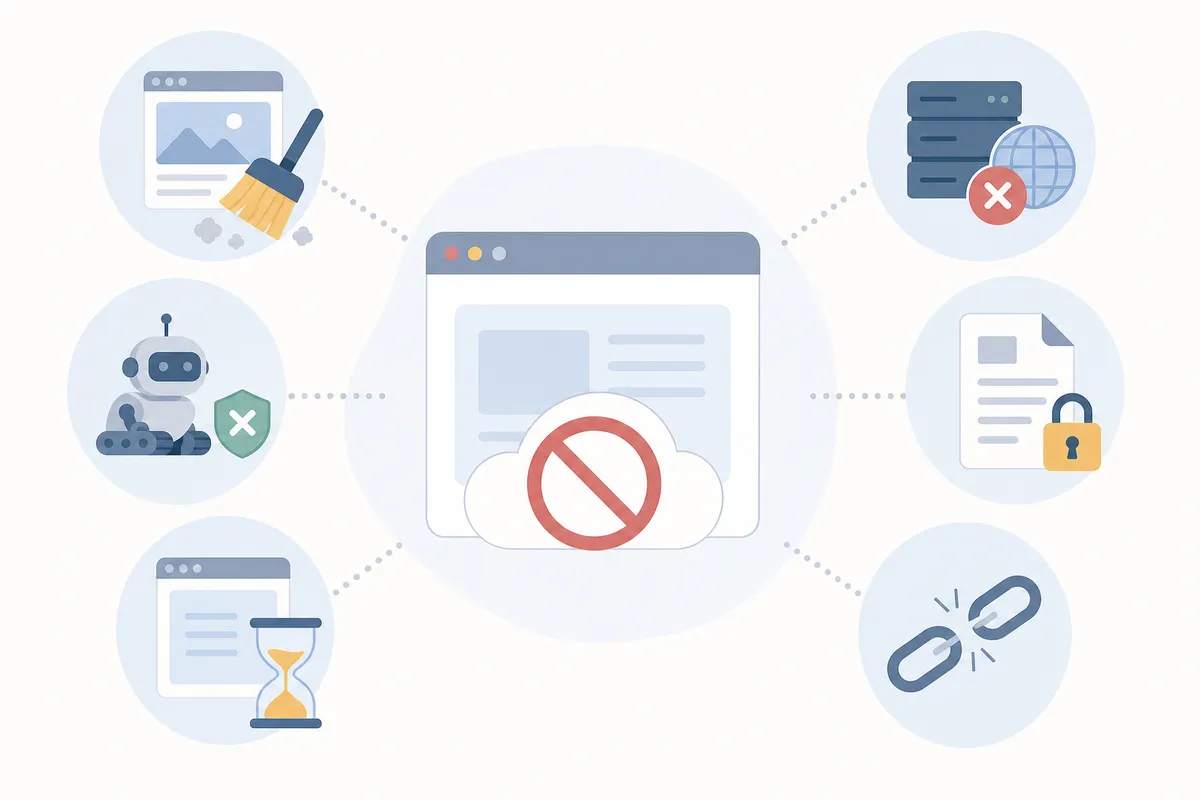
Mesmo com a Wayback Machine como alternativa, algumas páginas não têm snapshot.
| Motivo | O que está acontecendo | Solução, se houver |
|---|---|---|
Meta tag ou cabeçalho noarchive |
O site bloqueou explicitamente cópias em cache/arquivadas | Remova a tag se quiser que os snapshots sejam preservados |
| Bloqueada pelo robots.txt | Os rastreadores, inclusive o do Internet Archive, nunca tiveram permissão para entrar | Atualize o robots.txt e aguarde um novo rastreamento |
| A página é novíssima | Nenhum rastreador a visitou ainda para salvar uma cópia | Envie a URL e dê tempo; nossas ferramentas de SEO gratuitas podem confirmar o status de indexação |
| Página de pouco tráfego, raramente rastreada | Os bots de arquivamento priorizam páginas visitadas com frequência | Crie links internos e tráfego para aumentar a prioridade de rastreamento |
Vale entender a diretiva noarchive mesmo agora. Ela é uma das várias instruções que o Google lê na marcação da sua página, conforme documentado na referência da meta tag robots do Google Search Central. Se você está auditando o que realmente é respeitado, o resumo sobre as meta tags de SEO que o Google usa, e seis que ele ignora, é uma leitura mais rápida do que a documentação para desenvolvedores.
Fazer você mesmo ou chamar ajuda?
Conferir o histórico de uma única página é um trabalho de cinco minutos que não exige conhecimento técnico. Identificar padrões é mais difícil: perceber que uma categoria inteira de conteúdo deixou de ser rastreada, ou que uma migração deixou dezenas de URLs órfãs sem ninguém notar. Esse tipo de diagnóstico exige monitoramento contínuo, e não consultas pontuais, e é um bom momento para rever os fundamentos de SEO para você não ficar tratando sintomas isoladamente.
Perguntas frequentes
O cache do Google acabou de vez ou está só escondido?
Acabou. O Google aposentou o serviço em 2 de fevereiro de 2024 e removeu o operador de busca cache: da documentação. Nenhuma configuração o traz de volta, e o link da Wayback Machine é um substituto, não uma versão disfarçada do recurso antigo.
Ainda posso usar o operador cache: na Busca do Google?
Não. Digitar cache:yoursite.com agora retorna resultados de busca normais, em vez de um snapshot armazenado. O operador foi descontinuado junto com o restante do recurso de cache em 2024.
A Wayback Machine captura todas as páginas automaticamente?
Não. Ela salva páginas enviadas manualmente, com links vindos de outros lugares ou rastreadas pelos próprios bots, o que está longe de ser toda URL da web. Páginas de pouco tráfego ou recém-publicadas podem não ter nenhum snapshot.
A captura de tela do Search Console é o mesmo que uma página em cache?
Não, e isso confunde muita gente. A captura de tela da Inspeção de URL é uma renderização ao vivo gerada quando você a solicita, enquanto o cache era uma cópia armazenada de uma data de rastreamento passada. Uma mostra o "agora" e o outro mostrava o "antes".
O Bing e o Yahoo também removeram os links de cache?
Sim. O Bing removeu seu link de cache em 11 de dezembro de 2024 e deu o mesmo argumento de confiabilidade do Google. O cache do Yahoo, que dependia dos dados de rastreamento do Bing, deixou de funcionar mais ou menos no mesmo período, sem anúncio formal.
Veja o que o Google realmente enxerga no seu site
Os links de cache acabaram de vez, mas as perguntas que eles respondiam continuam valendo: esta página está indexada, ela mudou e o que o Google renderiza? Se você quer uma visão clara de como seu próprio site é indexado e rastreado, e de como ele aparece nas ferramentas que substituíram a busca em cache do google, fale com a equipe e vamos mostrar um exemplo de relatório de SEO feito com as suas próprias páginas.
Fontes
Sobre o autor
O SearchBlueprint pesquisou, escreveu e avaliou este artigo com o mesmo pipeline de conteúdo que nossos clientes usam nos próprios sites. A nota que aparece na assinatura é a que nosso mecanismo de conteúdo deu a esta página antes de ela ser publicada. Nada aqui passa por revisão manual, e esse é justamente o ponto: é o resultado do produto, publicado onde qualquer pessoa pode conferir.