Errores de SEO en la paginación que hunden tu posicionamiento sin hacer ruido
Por Toy Wen Da, Cofundador · Actualizado · 33 min de lectura
Traducido del original en inglés. Léelo en inglés
Los errores de SEO en la paginación rara vez se manifiestan como una caída repentina. Se manifiestan como una fuga lenta. Cada mes se indexan menos páginas, el posicionamiento de las páginas de categoría se estanca y los informes de rastreo se llenan de URL que nunca reciben del todo la atención que merecen. La paginación en sí no es el problema. El problema es cómo la implementan la mayoría de los sitios.
Esta guía repasa exactamente dónde falla la paginación y por qué perjudica tu posicionamiento. Después te muestra cómo reconstruirla para que los buscadores puedan rastrear, indexar y posicionar todas las páginas de la secuencia, no solo la primera.
¿Qué es la paginación en SEO?
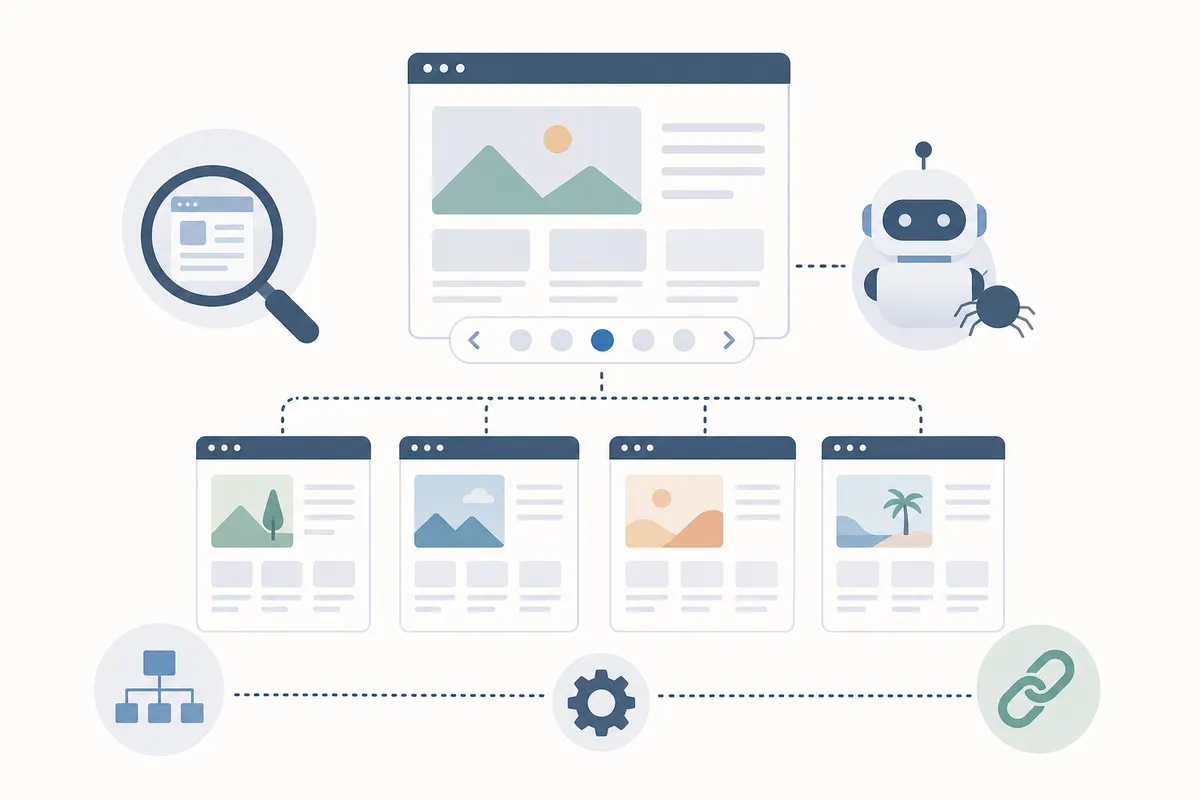
La paginación en SEO consiste en repartir un conjunto grande de contenido entre varias URL en lugar de meterlo todo en una sola página. Los listados de productos, los artículos, los hilos de foro y los resultados de búsqueda funcionan así. Cada página de la serie tiene su propia dirección, normalmente algo como /category/widgets?page=2, y los buscadores la rastrean y la indexan como una página independiente.
La paginación no es una idea nueva. La palabra misma es anterior a los ordenadores en siglos. La paginación de los libros solo se volvió práctica habitual hacia 1550, y sustituyó al sistema anterior, que numeraba únicamente el anverso de cada hoja. En la web, la paginación cumple la misma función básica: da un orden navegable a una secuencia larga de contenido. Pero además tiene que satisfacer a un rastreador, no solo a un lector.
Por qué existe
Sin paginación, un sitio con 10.000 productos tendría que mostrar los 10.000 en una sola página, o esconder la mayoría detrás de JavaScript. Ambas opciones son malas para el rendimiento y para la rastreabilidad. La documentación de Google Search Central sobre paginación y carga incremental de páginas señala que dividir los conjuntos grandes de resultados en páginas mejora la velocidad de carga inicial y reduce el tráfico de red. Eso importa sobre todo en conexiones móviles. También reduce la carga del backend y evita los límites de recursos del navegador o del servidor que aparecen al renderizar listas larguísimas de una sola vez.
Cómo tratan los buscadores las páginas paginadas
Aquí es donde mucha gente se confunde. Durante años, los especialistas en SEO trataron una serie paginada como una unidad conectada, en buena parte porque Google se lo indicaba con el marcado rel="next" y rel="prev". Ya no funciona así.
Google introdujo rel="next" y rel="prev" en 2011 precisamente para entender la relación entre las páginas de una secuencia. Después, el 21 de marzo de 2019, Google confirmó que había dejado de admitir esas etiquetas y que ya llevaba tiempo ignorándolas. Su postura actual: las páginas paginadas son páginas normales y punto. La indexación depende de señales ordinarias, como los enlaces internos, las etiquetas canónicas y la calidad del contenido, no de una directiva especial de paginación. Puede que otros buscadores aún lean rel="next"/"prev", pero Google no.
Ese único cambio es la razón por la que tantas configuraciones construidas en torno a rel=next/prev en la época de 2012 a 2018 están hoy rotas sin que nadie lo note. Si tu estrategia de canónicas, tus enlaces y tus reglas de indexación se diseñaron pensando en rel=next/prev, conviene revisarlos de nuevo. Una auditoría de SEO técnico es la forma más rápida de comprobar si tus páginas paginadas siguen enviando las señales que crees.
¿Qué ejemplos de paginación hay en SEO?
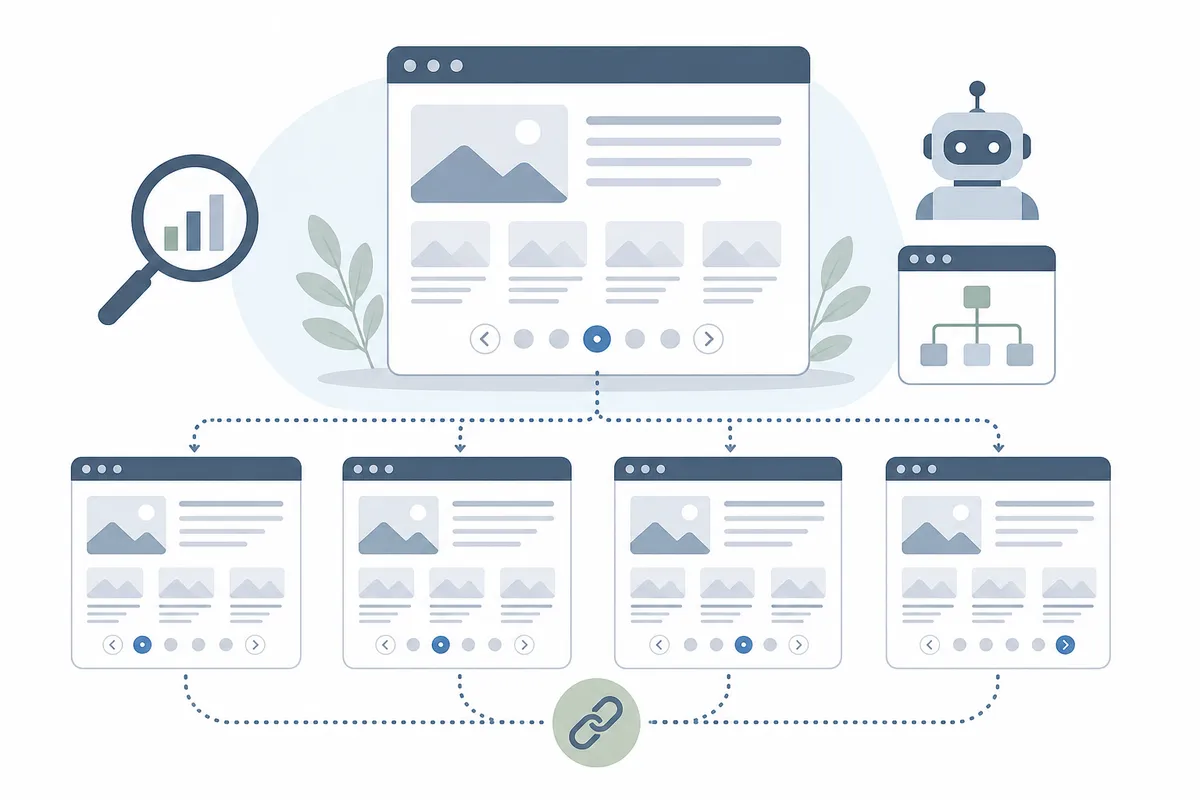
La paginación aparece en cualquier sitio que tenga más contenido del que cabe cómodamente en una pantalla. Los detalles de implementación cambian según el caso, pero el objetivo de fondo es el mismo: que cada segmento siga siendo rastreable e indexable.
| Caso de uso | Patrón de URL habitual | Qué protege la paginación |
|---|---|---|
| Páginas de categoría de comercio electrónico | /shoes?page=3 |
La visibilidad de los productos en un catálogo grande |
| Archivos de blog o de noticias | /blog/page/4 |
Que los artículos antiguos sigan siendo descubribles |
| Hilos de foro | /thread/128?p=5 |
Que las conversaciones largas sigan siendo legibles e indexables |
| Galerías de imágenes | /gallery/42?page=2 |
El tiempo de carga en páginas con muchas fotos |
| Páginas de resultados de búsqueda | /search?q=widgets&page=2 |
Que los resultados más profundos sigan siendo accesibles |
| Artículos largos en varias páginas | /guide/part-3 |
La longitud del scroll y la concentración del lector en guías muy extensas |
Cada uno de estos casos tiene un perfil de riesgo distinto. Un hilo de foro repartido en 40 páginas es de bajo riesgo si los enlaces están bien hechos. Un catálogo de productos repartido en 200 páginas con canónicas incorrectas puede borrar sin ruido la mayor parte de tu inventario de los resultados de búsqueda. Esa es la versión que merece más atención y en la que más se centra esta guía.
¿Cómo afecta la paginación al SEO?
La paginación afecta a la rastreabilidad, a la indexación, a la velocidad de la página y a cómo circula la autoridad de los enlaces por tu sitio. Bien hecha, ayuda en los cuatro frentes. Mal hecha, puede suprimir sin ruido páginas que sí quieres posicionar.
La ventaja
La paginación mejora la velocidad de la página al limitar la cantidad de contenido que se carga en cada solicitud, y la velocidad de la página es un factor de posicionamiento confirmado. También crea un rastro de enlaces internos rastreables que Google puede seguir para llegar al contenido enterrado en lo más profundo de un catálogo o un archivo. Sin ese rastro, las páginas que quedan más allá de la primera pantalla pueden volverse prácticamente huérfanas: técnicamente activas, pero nunca descubiertas porque nada enlaza a ellas. Nuestra guía sobre enlazado interno explica con más detalle cómo detectar páginas huérfanas, por si sospechas que ya te está pasando.
La desventaja
El mismo mecanismo que ayuda también crea riesgo. Cada URL paginada es casi un duplicado de las vecinas: misma plantilla, misma barra lateral, misma estructura general, y solo cambian los diez o veinte elementos del centro. Los buscadores necesitan una forma de distinguirlas sin tratarlas como contenido duplicado. Ahí entran las etiquetas canónicas, las URL únicas y los enlaces coherentes. Si fallas en cualquiera de ellos, creas justo la confusión que los buscadores intentan evitar. Google rastrea las URL que encuentra en el atributo href de las etiquetas de enlace (anchor), y nada más. No ejecuta los controladores de clic de "Cargar más" y, por lo general, tampoco activa funciones de JavaScript que actualizan el contenido sin un cambio real de URL. Si tu paginación depende por completo de una interacción en JavaScript sin un href rastreable, es posible que el contenido posterior a la página 1 no se indexe nunca. Lo explicamos con más detalle en nuestro artículo sobre por qué las aplicaciones de una sola página desaparecen de Google. La navegación que depende de JavaScript es uno de los mayores riesgos que comparten los sitios SPA y los catálogos muy paginados.
Las cifras detrás del impacto de la paginación en el posicionamiento
La mayoría de los consejos sobre paginación se quedan en lo abstracto: "afecta a la rastreabilidad", "afecta a la velocidad de la página". Las cifras reales son más concretas y proceden del propio Google, no del folclore del SEO.
Empecemos por la velocidad. El programa Core Web Vitals de Google fija tres umbrales concretos para una buena experiencia de página. Largest Contentful Paint, el tiempo hasta que se renderiza el contenido principal, debería mantenerse por debajo de 2,5 segundos. Interaction to Next Paint debería mantenerse por debajo de 200 milisegundos. Y Cumulative Layout Shift debería mantenerse por debajo de 0,1. Estas cifras proceden directamente de la documentación de web.dev, de Google, el mismo equipo que mantiene Core Web Vitals como una entrada del posicionamiento. Una página de categoría paginada que muestra 24 productos tiene una ventaja evidente en las tres métricas frente al mismo catálogo renderizado como una sola página ininterrumpida de 400 productos. Hay menos HTML que procesar, menos imágenes compitiendo por el ancho de banda en la primera carga y menos diseño que se desplace a medida que llega el contenido. Además, ninguno de estos umbrales es un objetivo abstracto. Search Console informa del rendimiento de Core Web Vitals agrupado por patrones de URL similares. Eso significa que un sitio puede ver cómo una serie paginada pasa de "necesita mejorar" a "buena" a medida que se aplican las correcciones, página por página, en el mismo informe que se usa para diagnosticar problemas de indexación.
El presupuesto de rastreo es la otra cifra que conviene conocer, y aquí Google es inusualmente directo sobre a quién le debe importar. Su propia documentación sobre el presupuesto de rastreo afirma claramente que la mayoría de los sitios no necesitan pensar en esto en absoluto. Es una preocupación específica de los sitios muy grandes con URL que cambian con frecuencia. Eso no describe un blog con unos cientos de entradas ni una tienda con unos pocos miles de SKU. El umbral práctico que usa la mayoría de los especialistas en SEO como regla general, deducido de cómo Google plantea la guía, se sitúa en algún punto de las decenas de miles de URL en adelante. Por debajo de eso, el presupuesto de rastreo rara vez es el cuello de botella; una respuesta lenta del servidor o un enlace roto son mucho más probablemente el verdadero problema. Por encima, la proliferación de páginas paginadas es uno de los primeros sitios que conviene auditar. Eso es especialmente cierto en sitios donde los parámetros de filtro y de orden multiplican unos pocos miles de URL base hasta cientos de miles de combinaciones rastreables.
Las dos cifras están relacionadas. Una serie que carga rápido mantiene Core Web Vitals dentro de rango en todas las páginas, no solo en la primera. Una serie que se mantiene ligera, sin combinaciones de filtros descontroladas ni variantes duplicadas infinitas, mantiene el presupuesto de rastreo dirigido a las páginas que realmente pueden posicionarse. Si aciertas con ambas, la paginación deja de ser un lastre para el rendimiento y la indexación y pasa a ser lo que protege ambos.
Paginación en móvil: áreas táctiles y alcance del pulgar
La guía de usabilidad móvil de Google recomienda áreas táctiles de al menos 48x48 píxeles CSS, con unos 8 px de separación entre ellas, cifras que proceden directamente de la documentación de accesibilidad y de experiencia de usuario móvil de Google. Los controles de paginación apretados en una fila diminuta de números de página suelen no superar esta prueba, sobre todo pasada la página 10, cuando un número de dos cifras tiene que caber en la misma caja que antes ocupaba una sola cifra. La solución no es complicada: mantén los controles "Anterior" y "Siguiente" grandes y bien separados, y reduce el tramo numerado del medio a algo como 1, 2, 3 … 9, 10, 11 en lugar de imprimir todos los números de página pegados de un extremo a otro. Una barra de paginación difícil de tocar con precisión en un teléfono no solo frustra a los usuarios. Hace que la rastreabilidad pierda sentido si nadie puede llegar a la página 4 sin fallar tres toques. Como la mayor parte del tráfico comercial es mobile first, conviene probarlo en un teléfono real, y no solo en una ventana de navegador de escritorio redimensionada, antes de dar por hecho que una serie paginada funciona como sugería la maqueta del diseño.
Paginación vs. scroll infinito vs. "Cargar más"
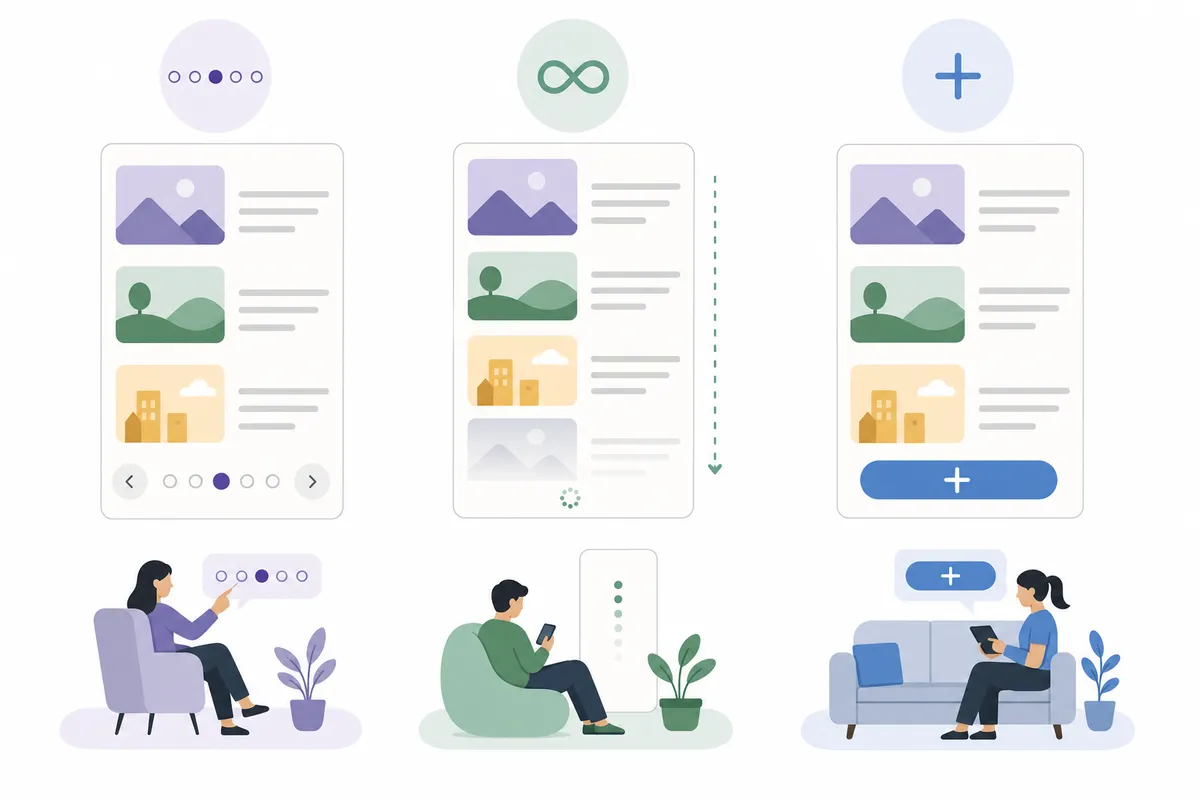
La paginación, el scroll infinito y los botones de "cargar más" resuelven el mismo problema de experiencia de usuario: demasiado contenido para una sola pantalla. Pero lo resuelven de formas distintas, con consecuencias distintas para el SEO.
La paginación reparte el contenido entre URL independientes y direccionables. El scroll infinito carga más contenido automáticamente a medida que el usuario baja por una sola URL. Los botones de "cargar más" están a medio camino: un clic manual que amplía la página actual sin cambiar necesariamente la URL. La diferencia no es cosmética. Determina si un rastreador puede llegar siquiera a tu contenido.
Comparación de los tres patrones
| Patrón | Rastreabilidad SEO | Experiencia de usuario | Más adecuado para |
|---|---|---|---|
| Paginación | Sólida: cada página tiene una URL única y rastreable | Sensación clara de progreso y de tamaño total; es fácil retomar en una página concreta | Catálogos de productos, archivos y todo lo que los usuarios necesiten comparar o revisitar |
| Scroll infinito | Débil, salvo que se combine con URL rastreables por detrás | Se siente continuo e inmersivo; puede provocar "fatiga de scroll" en listas enormes | Redes sociales, descubrimiento de imágenes, navegación centrada en la interacción |
| Cargar más | Débil: el contenido suele cargarse en la misma URL mediante JavaScript | Da a los usuarios sensación de control sin recargar la página completa | Listas de longitud moderada en las que el scroll infinito completo resulta excesivo |
La documentación de Google es contundente sobre este equilibrio. La paginación permite a los usuarios ver la longitud total de una lista y saber en qué punto están, a costa de un clic adicional entre páginas. El scroll infinito resulta cómodo, pero oculta el tamaño total de la lista y puede dificultar volver a encontrar contenido más antiguo.
Cómo hacer que el scroll infinito funcione para la búsqueda
El scroll infinito no tiene por qué ser un callejón sin salida para el SEO, pero necesita ayuda. La solución es combinar el comportamiento de scroll con URL paginadas reales por debajo. Un rastreador que acceda directamente a /products?page=2 debería obtener el mismo contenido que acabaría viendo un usuario que hace scroll. Y history.pushState() debería actualizar la barra de direcciones mientras los usuarios se desplazan, de modo que cada segmento siga siendo enlazable y compartible. Si omites esa capa, el scroll infinito se convierte en una sola URL con contenido al que un rastreador sencillamente nunca llega. La accesibilidad también se resiente: el scroll infinito puede desorientar a los usuarios de lectores de pantalla y enterrar el pie de página, algo que la paginación tradicional no hace.
Estándares de accesibilidad y scroll infinito
La preocupación por la accesibilidad no es solo una regla general. Las Web Content Accessibility Guidelines, mantenidas por la W3C Web Accessibility Initiative, establecen dos requisitos relevantes. Los usuarios deben poder percibir dónde se encuentran dentro de un conjunto de contenido. Y deben poder navegar por él solo con el teclado, sin ratón. El scroll infinito puede incumplir ambos sin que se note. Los usuarios de lectores de pantalla que recorren una página con el tabulador dependen de llegar al pie de página para saber que la página ha terminado. Si sigue cargándose contenido nuevo debajo de ellos, el pie de página nunca llega y la página, en la práctica, no tiene final. Los usuarios que solo usan el teclado se enfrentan a un problema parecido: el foco puede saltar de forma impredecible a medida que se montan secciones nuevas y dejarlos en un punto de la página que no han elegido.
Las soluciones prácticas están bien documentadas. Combina el scroll con un control visible de "cargar más" que los usuarios de teclado y de lector de pantalla puedan activar de forma deliberada, sin depender de la posición del scroll. Usa una región ARIA live, configurada en "polite", para anunciar el contenido nuevo a medida que se carga. Así, los usuarios de lectores de pantalla saben que algo ha cambiado sin que les muevan bruscamente del lugar que ocupaban en el documento. Y mantén un enlace de pie de página real y accesible, o un control de "volver arriba", para que la página siga teniendo un final navegable. Nada de esto es exótico. Es el mismo nivel de exigencia que WCAG establece para cualquier página que se actualiza dinámicamente. Lo que ocurre es que el scroll infinito lo incumple más a menudo que la mayoría de los patrones, porque el sentido mismo del patrón es un contenido que nunca deja de llegar.
Cuándo la paginación no es la solución
La paginación se gana su lugar cuando una lista es realmente larga, pero muchas listas no lo son. Una categoría con 18 productos no necesita cinco páginas de cuatro elementos cada una; una sola página carga igual de rápido y le da a Google una página sólida que posicionar en lugar de cinco endebles. El umbral práctico al que llegan la mayoría de los sitios, de 40 a 60 elementos en la página uno antes de dividir, mantiene una sola página bien dentro de los umbrales de Core Web Vitals y a la vez evita una duplicación inútil. La misma lógica vale para el contenido largo: dividir un artículo de 1.200 palabras en tres "partes" escuetas, sobre todo para inflar las páginas vistas, suele perjudicarlo, porque cada parte queda demasiado corta para posicionarse bien por sí sola y la división añade fricción para los lectores. Una única página completa, bien estructurada con encabezados claros, también es más fácil de resumir o de citar para un sistema de IA que una secuencia de fragmentos cortos. Antes de añadir paginación a cualquier cosa, conviene preguntarse si la lista es de verdad demasiado larga para renderizarse bien en una sola página, o si simplemente se dividió para que pareciera más movida.
Los errores de paginación que hunden tu posicionamiento sin hacer ruido
Aquí es donde se produce la mayor parte del daño. Ninguno de estos errores parece dramático en un navegador: las páginas siguen cargando y el botón de "siguiente" sigue funcionando. El daño se ve en Google Search Console y en los registros de rastreo, semanas después.
Error 1: Canonicalizar todas las páginas a la página 1
Este es el error de paginación más común. Un desarrollador bienintencionado configura la etiqueta canónica de todas las URL paginadas para que apunte a la página 1, pensando que así "consolidará" las señales de posicionamiento. En cambio, le dice a Google que las páginas de la 2 a la 50 no están pensadas para indexarse por sí solas, que son duplicados de la página 1. Google suele respetar esa instrucción y elimina esas páginas del índice. Si tu catálogo tiene productos únicos que solo viven en la página 4 o en la 12, esos productos desaparecen en la práctica de la búsqueda. Cada página de una serie paginada debería llevar una canónica autorreferente, una etiqueta que apunte a sí misma, no a la página 1. Si no estás seguro de que tus etiquetas canónicas hagan lo que crees, te conviene leer nuestro análisis de los errores de etiquetas canónicas que causan contenido duplicado. Este mismo error aparece constantemente también fuera de la paginación.
Error 2: Aplicar noindex a las páginas paginadas "para limpiar el índice"
Algunos equipos hacen justo lo contrario: añaden noindex a todas las páginas posteriores a la página 1. La idea es que así se ordenarán los resultados de búsqueda y se canalizará la autoridad hacia la página de categoría principal. Suele ser contraproducente. Noindex le dice a Google que elimine la página del índice por completo. Si esa página es el único lugar donde vive un producto, un artículo o una publicación de foro concretos, ese contenido deja de aparecer en la búsqueda, sin más. Peor aún, combinar una etiqueta noindex con una etiqueta canónica en la misma página envía señales contradictorias: una dice "no me indexes" y la otra, "soy la versión autorizada de esta URL". Google tiene que adivinar en cuál confiar, y la apuesta no siempre sale a tu favor.
Error 3: Controles de navegación que dependen solo de JavaScript
Si tu control de "página siguiente" es un <button> con un controlador onclick y sin un href real, estás apostando tus páginas profundas a que Googlebot ejecute tu JavaScript a la perfección. Eso tiene que ocurrir siempre, en cada rastreo, sin excepciones. Es una mala apuesta. Google rastrea las URL que encuentra dentro de los atributos href de las etiquetas de enlace. No hace clic en botones y, por lo general, tampoco activa el tipo de scripts que dependen de la interacción del usuario y que muchos frameworks de front-end usan para cambiar el contenido. Cada control de "siguiente" y "anterior" debería ser una etiqueta de enlace real que apunte a una URL real y rastreable. JavaScript puede seguir mejorando la experiencia del clic, pero el enlace subyacente tiene que existir en el marcado.
Error 4: Dejar que los parámetros de filtro y de orden multipliquen tus URL
Una página de categoría paginada ya es una URL multiplicada por docenas de páginas. Añade filtros (talla, color, precio, marca) y opciones de orden (precio ascendente, más reciente, más vendido) y podrás generar miles de combinaciones de URL casi idénticas a partir de una sola categoría. Los buscadores no quieren que se indexen todas; la mayoría no aporta valor único y solo diluye la atención del rastreo entre contenido casi duplicado. La solución es una metaetiqueta noindex en las variantes de URL filtradas u ordenadas, o una regla disallow en robots.txt para los patrones de parámetros concretos. En cualquier caso, los rastreadores dejan de gastar su limitada atención en combinaciones que nunca se van a posicionar. La sintaxis disallow de robots.txt no es solo una convención. Ahora es un estándar formal del IETF, el RFC 9309, algo que conviene saber si alguna vez un desarrollador duda de que los principales rastreadores vayan a respetar de forma fiable una regla disallow.
Error 5: Usar fragmentos de URL en lugar de rutas reales
Algunas implementaciones de paginación usan un identificador de fragmento, la parte de una URL que va después de un #, para representar el número de página, como en /products#page2. Google ignora todo lo que va después de un # al evaluar una URL. Si la única diferencia entre dos URL es el texto posterior al #, Googlebot puede tratarlas como la misma página que ya obtuvo. Puede que simplemente no se moleste en rastrear lo que cree que es un duplicado. Los números de página pertenecen a la ruta o a un parámetro de consulta real, nunca a un fragmento.
Error 6: Sobreoptimizar cada página de la serie
Resulta tentador escribir un título y una metadescripción únicos y llenos de palabras clave para cada página paginada, igual que harías con páginas realmente distintas. No lo hagas. La página 2 de una categoría de "zapatillas para correr" que compite con la página 1 de la misma categoría por la misma palabra clave es canibalización de palabras clave contra ti mismo. La solución habitual es desoptimizar las páginas paginadas posteriores a la página 1. Mantén los títulos y las descripciones parecidos o idénticos en toda la serie; Google ha confirmado que esto está bien en una secuencia paginada, porque reconoce la relación e indexa en consecuencia. Después concentra tu segmentación de la palabra clave principal, tus enlaces internos y la optimización on-page en la página raíz de la categoría.
Error 7: Romper la cadena de enlaces
Este patrón depende de que haya conexiones rastreables entre las páginas. Si la página 3 enlaza a la página 4 pero nada enlaza de vuelta a la página 1, o si la secuencia se rompe en algún punto intermedio, a Google le cuesta más entender la serie. También le cuesta más llegar a las páginas más alejadas del inicio. La mejor práctica es enlazar cada página con la siguiente de la secuencia y enlazar cada página de vuelta a la página 1. Eso le indica a Google que la página 1 es el punto de entrada natural de la serie. En el fondo, es un caso concreto de un problema mucho más amplio: páginas que existen pero no están bien conectadas con el resto del sitio. Nuestro análisis más a fondo sobre los errores de estructura del sitio que cuestan posicionamiento cubre el mismo patrón de fallo fuera de la paginación.
Error 8: Tratar el scroll infinito como un atajo de rastreabilidad
El scroll infinito parece moderno y realmente mejora las métricas de interacción en los feeds de contenido. Pero sustituir la navegación paginada por scroll infinito sin añadir URL rastreables por debajo es una de las historias más comunes del SEO del tipo "rediseñamos el sitio y el tráfico cayó". Si un rastreador solo ve el primer lote de elementos en la URL base, y todo lo demás se carga al hacer scroll sin una estructura de enlaces equivalente, todo lo que viene después de ese primer lote es en la práctica invisible para los buscadores. Los usuarios siguen pudiendo verlo todo; Google, simplemente, no.
Error 9: Ignorar el presupuesto de rastreo en catálogos muy grandes
Para un sitio con unos cientos de páginas, el presupuesto de rastreo apenas importa. Para un sitio con decenas de miles de páginas paginadas de productos o de archivo, importa mucho. Cada URL paginada endeble y casi duplicada que rastrea Google es atención que no dedica a tus páginas de mayor valor. Una proliferación excesiva y mal podada de páginas, sobre todo combinada con parámetros de filtro y de orden sin control, puede ralentizar de forma medible la rapidez con que se recoge el contenido nuevo o actualizado en otras partes del sitio. Si ves que hay páginas que pasan semanas sin indexarse, la proliferación de páginas paginadas es una causa raíz frecuente; nuestra guía sobre por qué se omiten páginas durante la indexación explica cómo diagnosticarlo. La documentación sobre el presupuesto de rastreo de Google es directa sobre a quién se aplica esto. Los sitios que no tienen una gran cantidad de URL que cambian con frecuencia, por lo general, no necesitan preocuparse en absoluto. Por eso un blog pequeño rara vez necesita esta guía, mientras que un catálogo de 200.000 SKU sí.
Cómo estructurar la paginación para que ayude de verdad al posicionamiento
Arreglar la paginación no es complicado cuando se conoce la lista de comprobación. Casi todo se reduce a deshacer uno de los nueve errores anteriores, de forma coherente, en toda la serie.
1. Autocanonicaliza cada página
Cada URL paginada debería llevar una etiqueta canónica que apunte a sí misma: la canónica de la página 2 apunta a la página 2, la de la página 3 a la página 3, y así sucesivamente. Nunca apuntes toda la serie a la página 1. Este único cambio resuelve el error más dañino de esta lista.
2. Usa URL claras, descriptivas y rastreables
Da a cada página de la serie su propia URL real, accesible mediante un enlace href estándar, algo como /category?page=2 o /category/page/2, y no un cambio de contenido activado por JavaScript en una sola dirección. Unos patrones de URL claros y coherentes también facilitan mucho auditar una serie paginada a gran escala más adelante.
3. No uses identificadores de fragmento para los números de página
Mantén el número de página en la ruta o como un parámetro de consulta real. Nunca dependas de un fragmento # para diferenciar una página de otra, porque Google ignora por completo esa parte de la URL.
4. Desoptimiza las páginas posteriores a la página 1
Deja que la página raíz lleve la segmentación de tu palabra clave principal, tus enlaces internos más fuertes y tu mejor texto on-page. Las páginas 2 en adelante pueden compartir títulos y metadescripciones parecidos; es un comportamiento esperado en una serie paginada, no una penalización por contenido duplicado a punto de ocurrir.
5. Mantén las páginas paginadas indexables
Resiste la tentación de aplicar noindex a las páginas posteriores a la página 1 "por si acaso". A menos que una página concreta tenga realmente poco valor (por ejemplo, una variante filtrada u ordenada), deja que siga siendo indexable para que se pueda encontrar cualquier contenido único que tenga.
6. Enlaza las páginas en secuencia y de vuelta a la página 1
Cada página debería enlazar hacia delante con la siguiente, y cada página debería enlazar de vuelta a la página 1. Esto le da a Google un camino limpio y coherente por toda la serie y refuerza qué página de la secuencia merece más autoridad.
7. Controla la proliferación de parámetros de filtro y de orden
Decide desde el principio qué combinaciones de parámetros merecen indexarse (normalmente: ninguna) y bloquea el resto con reglas noindex o robots.txt. Así el presupuesto de rastreo se mantiene centrado en las páginas que realmente pueden posicionarse.
8. Ayuda a los rastreadores y a los usuarios con preload y prefetch
La documentación de Google recomienda específicamente precargar (preload), preconectar (preconnect) o buscar previamente (prefetch) la página siguiente de una secuencia. Eso acelera la experiencia de los usuarios que avanzan por la serie, un detalle de rendimiento que además respalda la señal de velocidad de página que la paginación en parte está pensada para proteger.
9. Verifica toda la cadena con una auditoría técnica
La paginación afecta a las etiquetas canónicas, al enlazado interno, a las directivas de indexación y a las rutas de rastreo a la vez. Por eso es fácil acertar con una pieza y fallar con otra sin darse cuenta. Una auditoría de SEO técnico completa revisa los cuatro elementos juntos en lugar de uno por uno, y por lo general conviene hacer una antes y después de cualquier cambio importante en la paginación.
Hreflang y paginación en sitios multilingües
Los sitios que ofrecen varias versiones lingüísticas del mismo catálogo paginado añaden una capa que la mayoría de los consejos sobre paginación pasan por alto. Cada URL paginada necesita su propio conjunto de hreflang, no solo la página 1, lo que significa que la página 3 del catálogo en inglés debe apuntar a la página 3 de las versiones en francés y alemán, no a sus respectivas páginas 1. El error habitual es tratar hreflang como un ajuste exclusivo de la página 1 y dejar que desaparezca en silencio de todas las páginas siguientes. Eso deja a Google adivinando la correspondencia de idioma correcta para las páginas 2 a 40 en cada mercado. Perder hreflang en las páginas profundas de la paginación es tan dañino como una canónica ausente: le dice sin ruido a los buscadores que la relación entre versiones lingüísticas termina después de la primera página, aunque el catálogo evidentemente continúa. Cualquier sitio con paginación internacional debería comprobar esto específicamente durante una auditoría, en lugar de dar por hecho que el CMS lo arrastró automáticamente, ya que muchas plantillas tratan hreflang y la paginación como dos ajustes no relacionados que nunca se probaron juntos.
Un ejemplo práctico: reconstruir la paginación de una categoría de 40 páginas
Los consejos abstractos son fáciles de aceptar y difíciles de aplicar. Así es, paso a paso, arreglar una página de categoría paginada real, con una tienda hipotética que tiene una categoría "Running Shoes" repartida en 40 páginas de 20 productos cada una, 800 productos en total.
Paso 1: Averigua qué está roto de verdad
Antes de tocar nada de código, extrae la etiqueta canónica, la etiqueta meta robots y el href del enlace "siguiente" de una muestra de cinco páginas: la página 1, la 2, la 10, la 25 y la 40. En este ejemplo, las páginas de la 2 a la 40 llevan todas:
<link rel="canonical" href="https://example.com/running-shoes" />
Ese es el error más común de esta lista: todas las páginas posteriores a la página 1 apuntan su canónica a la categoría raíz. En la práctica, se le está diciendo a Google que las páginas de la 2 a la 40 no existen como entidades propias.
Paso 2: Corrige la dirección de la canónica
La solución es un cambio de una línea en la plantilla, aplicado en todo el sitio y no página por página. La canónica de la página 2 debería ser:
<link rel="canonical" href="https://example.com/running-shoes?page=2" />
Y así hasta la página 40, con cada página apuntando a sí misma. En la mayoría de las plataformas CMS esto es una sola condicional en la plantilla de categoría, no cuarenta ediciones manuales. Por eso precisamente el error es tan común: quien escribió la plantilla se equivocó una vez en la lógica, y esa lógica se aplicó en silencio a todas las páginas de todas las categorías de todo el sitio desde ese momento.
Paso 3: Revisa la cadena de enlaces
Con las canónicas corregidas, confirma que la página 2 enlaza a la 3, la 3 a la 4, y así hasta la 40, y que además cada página enlaza de vuelta a la página 1. Un rastreo con una herramienta como Screaming Frog, filtrado por este patrón de URL, debería mostrar una cadena continua sin huecos. En este ejemplo, la cadena se rompe en la página 23: un error en el componente de paginación elimina por completo el enlace "siguiente" cuando el número de página llega a dos cifras pasada la 20. Conviene detectarlo antes de dar la corrección por terminada; una canónica corregida no sirve de nada si el rastreador nunca puede llegar a la página cuya canónica acabas de arreglar.
Paso 4: Desoptimiza todo lo posterior a la página 1
El título de la página 1, "Running Shoes | 800+ Styles, Free Shipping | Example Shop", se queda intacto; es la página que lleva la palabra clave principal. Las páginas de la 2 a la 40 reciben un título casi idéntico con el número de página añadido, como "Running Shoes | Page 3 | Example Shop". Eso es mejor que cuarenta títulos redactados de forma única que compiten con la página 1 por los mismos términos de búsqueda. Google ha confirmado que esta duplicación en una serie paginada es esperable y no supone un problema; lo que provoca autocompetencia son cuarenta títulos únicos que persiguen una misma palabra clave, no cuarenta títulos parecidos.
Paso 5: Vuelve a rastrear y a enviar
Una vez publicados los cambios de plantilla, envía la URL de la categoría actualizada mediante la herramienta URL Inspection de Search Console para provocar un nuevo rastreo más rápido de la página 1, y deja que el resto de la serie se recoja con el rastreo normal a través de los enlaces internos ya corregidos. No envíes las 40 URL manualmente; para eso está la cadena de enlaces del Paso 3.
Paso 6: Vigila el informe de indexación para confirmarlo
Dale de dos a cuatro semanas y luego vuelve al informe Page Indexing de Search Console y filtra por el patrón de URL de la categoría. Las páginas marcadas antes como "Duplicate without user-selected canonical" deberían empezar a pasar a "Indexed". Eso ocurre por lotes y no todo a la vez, porque Google vuelve a rastrear las páginas a ritmos distintos según la frecuencia con que cada una ha cambiado históricamente. Una página enterrada en la posición 35 de la serie, que se rastrea poco porque nada en ella cambia a menudo, puede tardar bastante más en cambiar que la página 2. Es lo esperable, no una señal de que la corrección haya fallado.
Qué cambió
Tres correcciones a nivel de plantilla (la dirección de la canónica, un enlace roto en la cadena y la duplicación de títulos) sustituyen lo que de otro modo serían cuarenta correcciones manuales distintas. Esa proporción es el verdadero argumento a favor de arreglar la paginación a nivel de plantilla: un único error de lógica creó el problema en todo un catálogo, y una única plantilla corregida lo elimina de la misma manera.
La paginación no es solo una decisión de front-end: la paginación de tipo API
La mayoría de las conversaciones de SEO sobre paginación se centran en la página que ves en un navegador. Pero si tu sitio funciona con un CMS headless, una tienda personalizada o cualquier cosa que obtenga datos de productos y contenido de una API, el método de paginación que usa tu backend puede condicionar lo que el front-end es siquiera capaz de exponer a los rastreadores.
Como dijo el desarrollador Phil Sturgeon en un artículo muy leído sobre paginación de API: "la paginación consiste básicamente en dividir un conjunto de datos grande en fragmentos más pequeños, que un cliente puede obtener de forma incremental". Cada uno de los tres enfoques habituales conlleva compromisos reales.
| Método | Cómo funciona | Más indicado para | Punto débil |
|---|---|---|---|
| Basado en páginas | El cliente solicita page=2&size=10; el servidor devuelve esa página más el número total de páginas |
Interfaces sencillas que muestran enlaces de páginas numeradas | Contar todo el conjunto de datos se vuelve más lento a medida que crece |
| Basado en desplazamiento (offset) | El cliente solicita offset=10&limit=10; el servidor se salta registros y devuelve el siguiente fragmento |
Backends sencillos, consultas SQL con LIMIT/OFFSET |
El rendimiento se degrada bruscamente con desplazamientos altos en tablas grandes |
| Basado en cursor | El cliente envía un cursor opaco (a menudo un ID de registro codificado) que marca dónde terminó la última página | Conjuntos de datos muy grandes y que cambian con frecuencia | Es más difícil construir directamente con él una interfaz del tipo "página 1, 2, 3… 10" |
La conclusión práctica para el SEO: si tu backend usa paginación basada en cursor por motivos de rendimiento, asegúrate de que el front-end siga generando URL estables, rastreables y que se puedan guardar como marcador para cada página. No te conformes con un cursor opaco de API que cambia cada vez que se actualizan los datos. Las URL inconsistentes entre rastreos hacen mucho más difícil que Google reconozca "la página 2 de hoy" como la misma página que indexó la semana pasada.
Esto importa más que antes, porque cada vez más las páginas no solo las leen navegadores y rastreadores, sino también sistemas de IA que resumen o citan contenido. Una serie paginada con URL inestables confunde a esos sistemas tanto como a Googlebot. Si eso es una prioridad para tu catálogo o tu archivo de contenido, nuestra página sobre optimización para motores generativos explica con más detalle cómo la coherencia estructural alimenta el descubrimiento impulsado por IA.
¿Deberían las series paginadas llevar datos estructurados?
Los datos estructurados no arreglan una canónica rota ni un enlace ausente, pero responden a una pregunta que el resto de esta guía no aborda: ¿debería una serie paginada decirles explícitamente a los buscadores cómo es toda la colección, y no solo lo que hay en la página actual?
Schema.org, el vocabulario de datos estructurados que mantienen conjuntamente Google, Microsoft, Yahoo y Yandex, define un tipo ItemList precisamente para esta situación: un conjunto de elementos con un orden definido. Describe una serie paginada como una única lista lógica en lugar de cuarenta páginas sin relación. Una implementación mínima en la página 3 de una categoría de 40 páginas podría verse así:
{
  "@context": "https://schema.org",
  "@type": "ItemList",
  "itemListElement": [
    { "@type": "ListItem", "position": 41, "url": "https://example.com/products/trail-runner-x1" },
    { "@type": "ListItem", "position": 42, "url": "https://example.com/products/trail-runner-x2" }
  ]
}
Los valores de position continúan a lo largo de toda la serie en lugar de reiniciarse en cada página. Los elementos 41 y 42, por ejemplo, están en la página 3 de una serie que muestra 20 por página. Eso permite a quien consuma este marcado entender en qué punto de la colección completa se sitúa una página determinada.
¿Es necesario? No. Google no necesita el marcado ItemList para entender o indexar correctamente una serie paginada. Las etiquetas canónicas y los enlaces internos que se explican antes en esta guía ya cumplen esa función por sí solos. Lo que aporta ItemList es una descripción de la colección más limpia y legible por máquinas para cualquier sistema que analice datos estructurados. Eso incluye a los motores de respuestas que leen cada vez más el marcado de una página y no solo su texto renderizado. Un catálogo de productos que marca su serie paginada con ItemList les da a esos sistemas una vista explícita y ordenada: "aquí están los elementos 41 a 60 de una lista de 800". Eso es mejor que obligarlos a deducir la estructura a partir de cuarenta documentos HTML separados. Para los sitios que invierten en visibilidad más allá de los resultados de búsqueda tradicionales, es una adición razonable y de bajo coste una vez que los fundamentos de canónicas y enlaces ya están sólidos, no un sustituto de ellos.
El orden de las operaciones importa. Arreglar una canónica invertida en una serie de 40 páginas merece hacerse esta semana. Añadir marcado ItemList a la misma serie merece hacerse más adelante, cuando los fundamentos aguanten, y no en lugar de ellos.
Herramientas para auditar la paginación a gran escala
Comprobar la paginación a mano sirve para un hilo de foro de cinco páginas; no escala a un catálogo de 40.000 SKU. Screaming Frog es el punto de partida más común: su versión gratuita rastrea hasta 500 URL, y una licencia de pago elimina ese límite y añade la extracción personalizada necesaria para obtener las etiquetas canónicas y los valores de href de todas las páginas paginadas de una sola pasada. Sitebulb parte de la misma idea con un mapa visual de rastreo que hace más fácil detectar una cadena de enlaces rota que recorrer una hoja de cálculo. JetOctopus y ContentKing monitorizan el comportamiento del rastreo de forma continua y no en una única instantánea, lo cual importa aquí en particular, ya que un error de plantilla puede reintroducir sin ruido una canónica rota meses después de publicada la corrección original. Ninguna de estas herramientas sustituye al informe Page Indexing de Google Search Console, que es la única herramienta que muestra cómo trata Google en este momento cada URL paginada. Pero un rastreador te da el "porqué" de lo que Search Console informa como síntoma. Usar ambos a la vez, un rastreo más Search Console, detecta problemas que ninguna de las dos herramientas muestra con claridad por sí sola.
Cómo auditar y corregir los problemas de paginación
Encontrar un problema de paginación suele costar menos esfuerzo del que la gente espera; las señales son coherentes una vez que sabes qué revisar.
Qué revisar primero
Empieza por el informe Page Indexing de Google Search Console. Busca URL paginadas marcadas como "Duplicate without user-selected canonical" o "Alternate page with proper canonical tag". Ambas son pistas claras de que tu estrategia de canónicas apunta en la dirección equivocada. Después rastrea el sitio directamente con una herramienta como Screaming Frog, filtrando por los patrones de URL paginadas. Comprueba qué dicen realmente la etiqueta canónica y la etiqueta meta robots de cada página, frente a lo que esperas que digan.
| Comprobación | Dónde mirar | Cómo se ve un problema |
|---|---|---|
| Dirección de la canónica | Código fuente de la página, <link rel="canonical"> |
Las páginas 2 en adelante apuntan su canónica a la página 1 en lugar de a sí mismas |
| Estado de indexación | Google Search Console → Page Indexing | URL paginadas marcadas como duplicadas o excluidas |
| Accesibilidad de los enlaces | Rastreo del sitio (Screaming Frog, JetOctopus, etc.) | Enlaces "Siguiente" sin href, o presentes solo en JS |
| Proliferación de parámetros | Informe de rastreo, recuento de parámetros de URL | Cientos de combinaciones de filtro y de orden que se están rastreando |
| Uso de fragmentos | Revisión de la estructura de URL | Números de página que aparecen después de un # |
Corregir lo que encuentres
Una vez que has identificado qué error está en juego, la solución es casi siempre una de las nueve correcciones anteriores. Cambia la dirección de la canónica, quita un noindex innecesario, sustituye un control solo de JS por un enlace real o ajusta las reglas de robots para las variantes de parámetros. Lo difícil suele ser priorizar. En un catálogo con miles de URL paginadas, corregir la dirección de la canónica en todo el sitio tiende a producir la recuperación mayor y más rápida, ya que afecta a todas las páginas de todas las series a la vez. Una guía más amplia de correcciones de SEO técnico es una buena siguiente lectura si la paginación resulta ser un síntoma de un problema mayor de presupuesto de rastreo o de indexación en tu sitio.
Cuánto tarda la recuperación tras corregir la paginación
Esta es la pregunta que la mayoría de las guías pasan por alto, y es la que la gente quiere que le respondan: tras corregir una canónica rota o una etiqueta noindex, ¿cuánto tardan las páginas en volver?
No hay una cifra fija, y la propia documentación de Google sobre rastreo e indexación no finge lo contrario. Describe el momento del nuevo rastreo como algo determinado por la demanda de rastreo, por la importancia que Google atribuye a una URL y por la frecuencia con que ha cambiado históricamente, y no por un calendario garantizado. Dicho esto, se observa un patrón aproximado en la mayoría de los sitios que hacen una corrección de paginación en todo el sitio.
La página 1 y las páginas de categoría de mucho tráfico suelen volver a rastrearse en cuestión de días, porque Google ya las visita con frecuencia. Si envías la URL mediante la herramienta URL Inspection de Search Console, ese plazo puede reducirse a uno o dos días.
Las páginas del tramo medio de la serie (aproximadamente de la 2 a la 10) suelen seguir en una a tres semanas, recogidas mediante el rastreo normal de la cadena de enlaces internos ya corregida y no mediante un envío manual.
Las páginas del tramo profundo de la serie (de la página 20 en adelante) pueden tardar un mes o más, sobre todo en sitios que Google rastrea con menos frecuencia en general. Estas páginas tenían la menor prioridad de rastreo antes de la corrección. Una canónica corregida no sube automáticamente esa prioridad, solo elimina la barrera activa que las mantenía fuera.
La recuperación completa del posicionamiento, a diferencia de la simple reindexación, suele ir por detrás de la reindexación unas semanas más. Una página puede volver al índice y aun así tardar en recuperar el posicionamiento que tenía antes. Eso se debe a que Google también está reevaluando cómo encaja esa página en la versión actual del sitio, y no se limita a restaurar un posicionamiento almacenado de antes del error.
Hay varias cosas que lo aceleran: una cadena de enlaces internos limpia e ininterrumpida, un sitemap que incluya las URL corregidas y la autoridad general del sitio. Un sitio consolidado con visitas frecuentes de Googlebot siempre se recuperará más rápido que uno más pequeño que Google rastrea semanalmente. También hay cosas que lo frenan: un catálogo grande en el que el patrón roto afectó a decenas de miles de URL a la vez, o un sitio en el que el presupuesto de rastreo ya estaba limitado antes de la corrección.
La advertencia honesta: si pasan de cuatro a seis semanas sin ningún movimiento en la página 1 ni en las páginas de categoría de más tráfico, lo más probable es que la corrección no haya llegado a funcionar del todo. Eso es distinto de que la recuperación sea simplemente lenta, y merece la pena volver a auditar en lugar de esperar más.
La paginación en distintas plataformas
Los valores predeterminados de paginación varían mucho según la plataforma, y un ajuste que está bien en un CMS puede ser un problema en otro.
Las plataformas de comercio electrónico son el caso de más riesgo, ya que las páginas de categoría suelen paginar cientos de productos y generan ingresos directamente. Si tu catálogo se rige por las mejores prácticas de SEO para comercio electrónico, la canonicalización de la paginación y el control de parámetros merecen estar cerca de la parte alta de la lista de comprobación. No deberían ser algo secundario que se atiende una vez al año.
Más allá del comercio electrónico, las plataformas CMS difieren en cuánto control sobre la paginación ofrecen de serie. Algunas generan por defecto páginas de archivo paginadas con autocanonicalización; otras requieren ediciones manuales de la plantilla para acertar con la canónica y la estructura de enlaces. Si trabajas dentro de las limitaciones de una plataforma concreta, nuestras guías de SEO por CMS explican los ajustes que importan para tu stack, incluidos los puntos en los que los valores predeterminados de paginación suelen necesitar cambios.
Unos cuantos ejemplos concretos muestran hasta qué punto difieren realmente los valores predeterminados. La paginación nativa de WordPress (/blog/page/2/, generada por su función integrada paginate_links()) se autocanonicaliza por defecto. Cada archivo paginado tiene su propia canónica que apunta a sí mismo, y los plugins de SEO populares, por lo general, conservan ese comportamiento en lugar de anularlo. El error habitual en WordPress no es el valor predeterminado de la plataforma; es un tema o un plugin de maquetación superpuesto que reescribe en silencio la canónica hacia la página 1.
Las páginas de colección de Shopify se paginan automáticamente a partir de un número determinado de productos, habitualmente 36 o 50, según el tema. Shopify genera etiquetas canónicas que apuntan cada página de colección paginada a sí misma y no a la primera página, un valor predeterminado correcto. Donde las tiendas Shopify suelen meterse en problemas es en los parámetros de filtro y de orden superpuestos a las colecciones, mediante aplicaciones o widgets de filtrado personalizados. Estos pueden generar grandes volúmenes de combinaciones de parámetros rastreables al margen de los valores predeterminados de la propia plataforma.
WooCommerce, que funciona sobre WordPress, hereda la mecánica de paginación de WordPress en sus archivos de tienda y de categoría, por lo que generalmente se aplica el mismo valor predeterminado de autocanonicalización. Pero las tiendas WooCommerce suelen añadir plugins de filtrado de terceros, por rango de precio, atributo o marca, que introducen el mismo problema de proliferación de parámetros que afecta a las tiendas Shopify, solo que a través de un conjunto distinto de plugins.
Las tiendas headless y las construidas a medida no tienen ningún valor predeterminado. Lo que implemente el equipo de front-end es el comportamiento que obtienes, y por eso mismo los sitios headless están desproporcionadamente representados entre los errores de dirección de la canónica. No hay una convención de plataforma que los proteja en silencio, como sí ocurre con WordPress o Shopify.
El patrón común a todas ellas: la plataforma base rara vez es donde se rompe la paginación. Casi siempre es un tema, un plugin, una aplicación o una plantilla personalizada superpuesta que anula un valor predeterminado correcto con uno incorrecto. Es lo primero que conviene comprobar en cualquier plataforma, antes de suponer que el problema es el propio CMS.
Mitos comunes sobre la paginación que conviene jubilar
Algunas creencias sobre la paginación siguen circulando mucho después de haber dejado de ser ciertas. La primera: que rel="next"/"prev" todavía ayuda a Google a entender una serie, cuando Google ignora ambas etiquetas desde antes de su anuncio de 2019. La segunda: que más páginas paginadas siempre significan más presupuesto de rastreo gastado, cuando en la práctica una serie ligera y bien enlazada de páginas autocanonicalizadas es barata de rastrear para Google. Lo que desperdicia presupuesto es la proliferación de parámetros y las canónicas rotas, no el número de páginas por sí solo. La tercera: que el scroll infinito es automáticamente peor para el SEO que la paginación numerada, cuando lo que realmente determina es si existen URL rastreables por debajo del scroll, y no qué patrón eligió un diseñador. Y la cuarta: que aplicar noindex a las páginas profundas es una opción predeterminada segura y conservadora, cuando suele ser lo contrario, una forma de eliminar en silencio contenido que Google habría indexado sin problema. Cada uno de estos mitos remite a la misma causa de fondo: tratar la paginación como un problema resuelto en 2015 en lugar de comprobar qué ocurre realmente en el rastreo de hoy.
Cómo decidir si la paginación necesita arreglarse ya
No todos los problemas de paginación son urgentes. Un foro con enlaces next/prev limpios y canónicas correctas no necesita atención solo porque exista esta guía. La paginación merece una revisión inmediata cuando se da cualquiera de las siguientes situaciones. Una gran parte de tu catálogo o archivo está a dos o más páginas de profundidad. Tus etiquetas canónicas se configuraron antes de 2019 y no se han revisado desde la desaparición de rel=next/prev. Tu sitio ha añadido hace poco scroll infinito o un botón de "cargar más" sin comprobar qué ocurre con las URL subyacentes. O Search Console muestra un número creciente de URL paginadas "duplicadas" o "excluidas". Si alguna de estas situaciones coincide con la tuya, trata la paginación como una corrección prioritaria y no como algo para "algún día". Cuanto antes se corrija una cadena de canónicas rota, más rápido volverán las páginas profundas al índice.
Una lista de comprobación rápida de paginación antes del lanzamiento
Antes de publicar cualquier cambio en una plantilla paginada, repasa una breve lista de verificación de sí o no en lugar de fiarte de la memoria. ¿Lleva cada página una canónica autorreferente, confirmada viendo realmente el código fuente de tres páginas, y no solo de la página 1? ¿Tiene el control de "siguiente" un href real, visible en el código fuente de la página con JavaScript desactivado? ¿Enlaza la página 2 de vuelta a la página 1 y se mantiene la cadena hasta la última página? ¿Están las variantes de URL filtradas y ordenadas bloqueadas para la indexación en lugar de quedar abiertas por defecto? ¿Está el número de página en la ruta o en un parámetro de consulta, y nunca después de un #? Responder que sí a las cinco preguntas detecta la gran mayoría de los errores de paginación antes de que se publiquen, en lugar de descubrirlos tres semanas después en un informe de Search Console cuando el daño ya está hecho.
Preguntas frecuentes
¿Sigue usando Google rel="next" y rel="prev" para la paginación?
No. Google confirmó el 21 de marzo de 2019 que había dejado de usar estas etiquetas y que ya llevaba un tiempo ignorándolas antes de ese anuncio. Ahora trata cada página paginada como una página normal y se apoya en el enlazado interno y en las etiquetas canónicas. Es posible que algunos otros buscadores aún lean las etiquetas, pero ya no son necesarias para Google.
¿Deben las páginas paginadas llevar noindex?
Por lo general, no. Aplicar noindex a una página paginada la elimina por completo del índice, lo que puede ocultar contenido único (productos, artículos, publicaciones) que solo existe en esa página concreta. Mantén las páginas paginadas indexables con etiquetas canónicas autorreferentes y reserva noindex para variantes realmente de poco valor, como las URL filtradas u ordenadas.
¿Es malo el scroll infinito para el SEO?
El scroll infinito no es malo para el SEO por naturaleza, pero es arriesgado si no se hace un trabajo extra. Si el contenido se carga dinámicamente en una sola URL sin enlaces rastreables por debajo, es posible que los buscadores no descubran nunca la mayor parte. Combinar el scroll infinito con URL reales y direccionables para cada segmento (y actualizar la barra de direcciones mientras el usuario se desplaza) cierra esa brecha.
¿Cuál es la diferencia entre la paginación y una página "ver todo"?
La paginación reparte el contenido entre varias URL; una página "ver todo" lo pone todo en una sola URL, a menudo con las páginas paginadas canonicalizadas hacia ella. Las páginas de "ver todo" pueden consolidar las señales de posicionamiento, pero necesitan una optimización de rendimiento sólida. Una página de carga lenta con cientos de elementos puede perjudicar la experiencia de usuario y las señales de velocidad de página más de lo que lo habría hecho la paginación.
¿Cuántas páginas paginadas son demasiadas para el SEO?
No hay un límite fijo, pero una paginación muy profunda (cientos de páginas en una misma serie) aumenta el presupuesto de rastreo gastado en contenido casi duplicado. Técnicas como la paginación de punto medio muestran enlaces de página como 1, 2, 3 … 9, 10, 11 en lugar de cada número. Eso reduce la profundidad de rastreo hasta las páginas lejanas y mantiene manejable la estructura de enlaces sin sacrificar la accesibilidad.
Arreglar la paginación empieza por ver toda la cadena
Los problemas de paginación rara vez se anuncian. Simplemente aparecen como páginas que dejaron de indexarse, categorías que dejaron de posicionarse e informes de rastreo que nadie llegó a leer con atención. La solución rara vez es una reconstrucción. Suele ser una etiqueta canónica que apunta en la dirección equivocada, una etiqueta noindex que no debería estar ahí o un botón de "página siguiente" sin ningún enlace real detrás.
Si quieres ver exactamente cuáles de estos errores de paginación comete tu propio sitio, habla con el equipo y recibe un informe SEO de muestra elaborado a partir de tu sitio real.
Recursos / Referencias
Fuentes
- Pagination Best Practices for Google | Google Search Central
- Pagination
- API Design Basics: Pagination
- Pagination.com - The fastest path from data to documents
Aviso legal: Este artículo es información general sobre normas y cifras vigentes en el momento en que se escribió; no constituye asesoramiento financiero, fiscal ni de inversión personalizado. No tiene en cuenta tus ingresos, tus obligaciones, tu tolerancia al riesgo ni tus objetivos, y los tipos y los umbrales cambian. Verifica la situación actual con la autoridad competente y consulta a un asesor autorizado o a un contador cualificado antes de actuar.
Sobre el autor
SearchBlueprint investigó, escribió y puntuó este artículo con el mismo flujo de contenido que nuestros clientes usan en sus propios sitios. La puntuación que aparece junto al autor es la que nuestro motor de contenido dio a esta página antes de publicarla. Nada de esto se revisa a mano, y ese es el punto: es el resultado del producto, publicado donde cualquiera puede comprobarlo.