Erros de SEO em paginação que derrubam seus rankings em silêncio
Por Toy Wen Da, Cofundador · Atualizado em · 33 min de leitura
Traduzido do original em inglês. Ler em inglês
Os erros de SEO em paginação raramente aparecem como uma queda repentina. Eles surgem como um vazamento lento: menos páginas são indexadas a cada mês, os rankings das categorias estagnam e os relatórios de rastreamento se enchem de URLs que ninguém olha com atenção. A causa costuma estar na forma como o site implementa a paginação, e não na paginação em si.
Este guia mostra onde a paginação dá errado e por que isso prejudica os rankings. Depois, mostra como reconstruí-la para que os mecanismos de busca consigam rastrear, indexar e ranquear todas as páginas da sequência, inclusive as que vêm depois da página um.
O que é paginação em SEO?
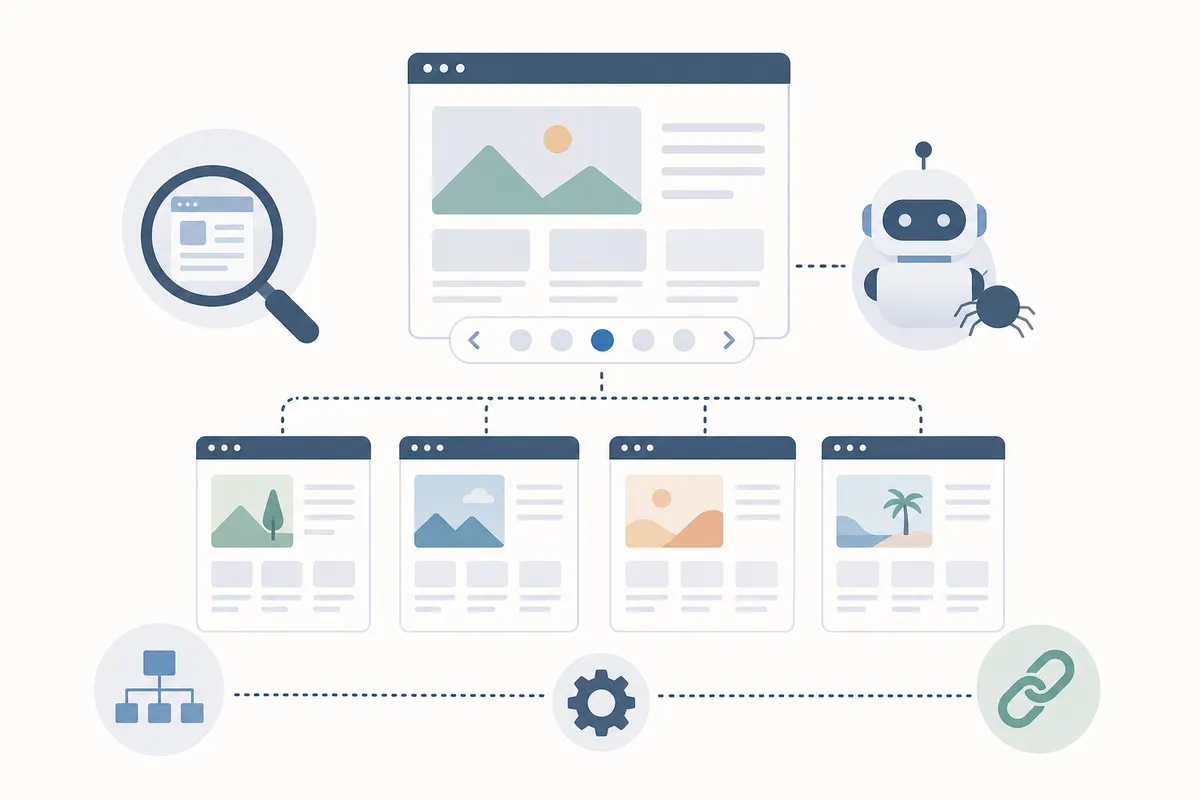
Paginação em SEO é a prática de dividir um grande conjunto de conteúdo em várias URLs, em vez de espremê-lo em uma só página. Listagens de produtos, artigos, tópicos de fórum e resultados de busca funcionam assim. Cada página da série recebe o próprio endereço, geralmente algo como /category/widgets?page=2, e os mecanismos de busca a rastreiam e a indexam como uma página independente.
A ideia é antiga, e a própria palavra é anterior aos computadores em séculos. A paginação dos livros só virou prática padrão por volta de 1550, quando substituiu o sistema anterior, que numerava apenas a frente de cada folha. Na web, ela cumpre basicamente a mesma função de dar a uma longa sequência de conteúdo uma ordem que se pode seguir, com a exigência extra de que um rastreador também precisa conseguir segui-la.
Por que ela existe
Sem paginação, um site com 10.000 produtos precisaria renderizar os 10.000 em uma única página ou esconder a maioria deles atrás de JavaScript. As duas opções são ruins para o desempenho e para a rastreabilidade. A documentação do Google Search Central sobre paginação e carregamento incremental de páginas destaca que dividir grandes conjuntos de resultados em páginas melhora a velocidade de carregamento inicial e reduz o tráfego de rede, o que pesa mais em conexões móveis. Isso também diminui a carga no back-end e evita os limites de recursos do navegador e do servidor que surgem ao renderizar listas enormes de uma só vez.
Como os mecanismos de busca tratam as páginas paginadas
Esta é a parte que confunde muita gente. Durante anos, os profissionais de SEO trataram uma série paginada como uma unidade conectada, em grande parte porque o Google introduziu rel="next" e rel="prev" em 2011 para ajudar a entender a relação entre as páginas de uma sequência. Em 21 de março de 2019, o Google confirmou que havia abandonado o suporte a essas tags e que já as ignorava havia algum tempo.
A posição atual é que as páginas paginadas são páginas comuns. A indexação depende de sinais normais, como links internos, tags canonical e qualidade do conteúdo, sem nenhuma diretiva especial de paginação. Outros mecanismos de busca ainda podem ler rel="next"/"prev", mas o Google não lê.
Essa mudança é a razão de tantas configurações montadas em torno de rel=next/prev na era 2012–2018 estarem hoje silenciosamente quebradas. Se a sua estratégia de canonical, de links e de indexação foi desenhada em torno dessas tags, vale olhar de novo. Uma auditoria de SEO técnico é a forma mais rápida de descobrir se as suas páginas paginadas ainda enviam os sinais que você acha que enviam.
Quais são exemplos de paginação em SEO?
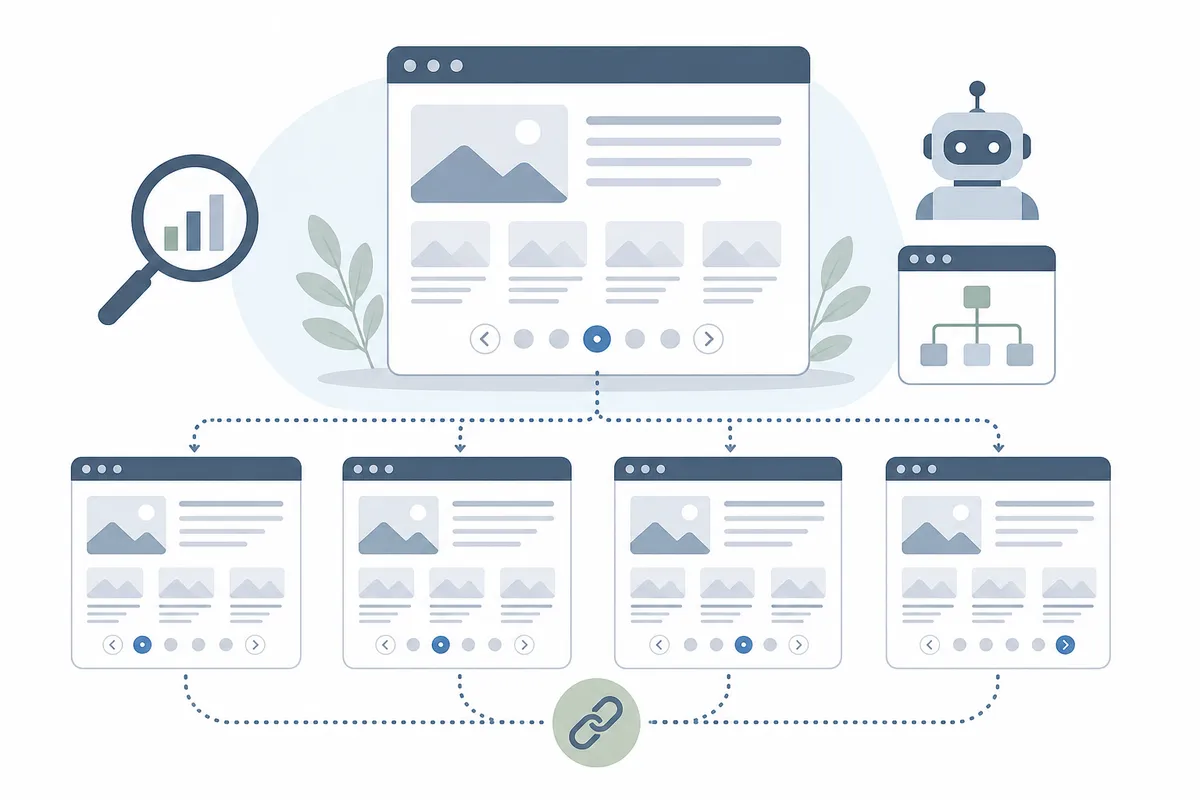
A paginação aparece sempre que um site tem mais conteúdo do que cabe confortavelmente em uma tela. Os detalhes mudam conforme o caso de uso, mas o objetivo é sempre manter cada segmento rastreável e indexável.
| Caso de uso | Padrão típico de URL | O que a paginação protege |
|---|---|---|
| Páginas de categoria de e-commerce | /shoes?page=3 |
A visibilidade dos produtos em um catálogo grande |
| Arquivos de blog ou de notícias | /blog/page/4 |
Artigos mais antigos continuarem sendo encontrados |
| Tópicos de fórum | /thread/128?p=5 |
Conversas longas continuarem legíveis e indexáveis |
| Galerias de imagens | /gallery/42?page=2 |
O tempo de carregamento de páginas cheias de fotos |
| Páginas de resultados de busca | /search?q=widgets&page=2 |
Resultados mais profundos continuarem acessíveis |
| Artigos longos em várias páginas | /guide/part-3 |
O tamanho da rolagem e o foco do leitor em guias muito longos |
Cada um desses casos traz um nível diferente de risco. Um tópico de fórum dividido em 40 páginas é de baixo risco se os links forem sólidos, enquanto um catálogo de produtos dividido em 200 páginas com canonicals erradas pode apagar silenciosamente a maior parte do seu estoque dos resultados de busca. O caso do catálogo merece o maior escrutínio, e é nele que este guia se concentra.
Como a paginação afeta o SEO?
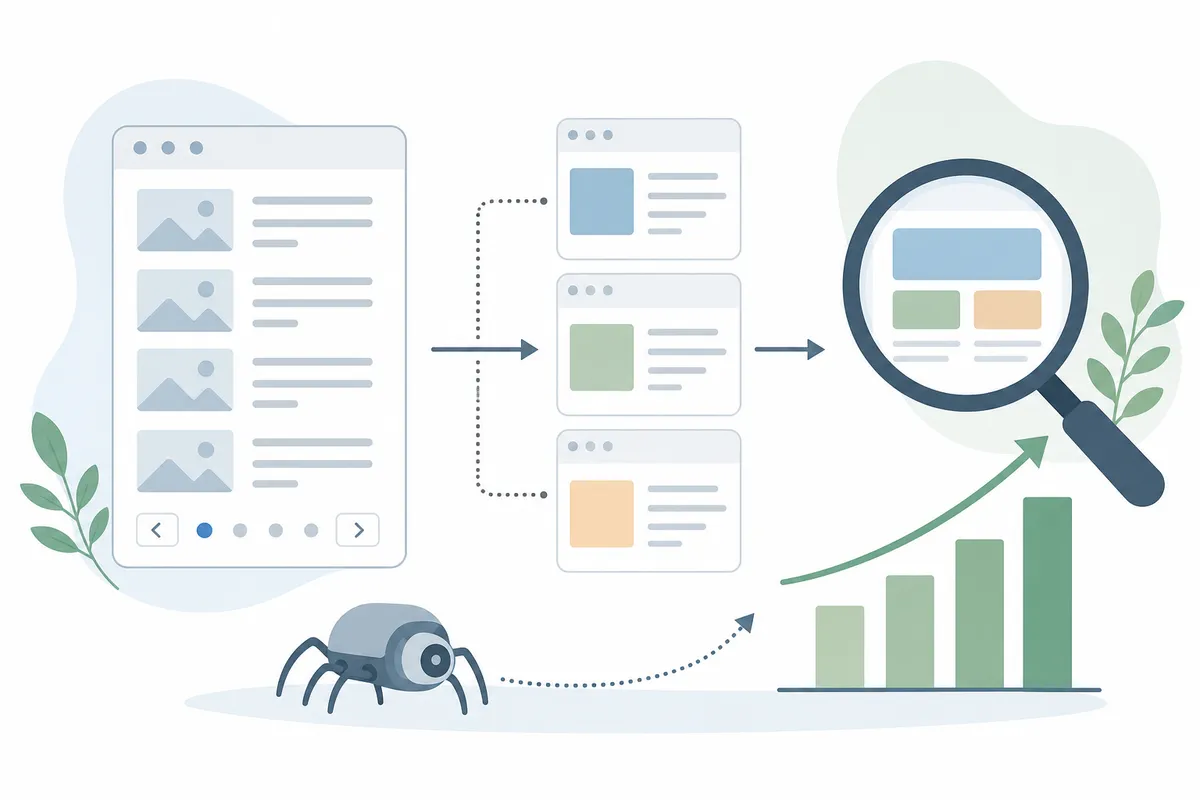
A paginação afeta a rastreabilidade, a indexação, a velocidade da página e a forma como a link equity (autoridade transmitida pelos links) circula pelo seu site. Bem feita, ela ajuda nos quatro pontos; mal feita, pode suprimir páginas que você quer ver ranqueando.
O lado positivo
A paginação melhora a velocidade da página ao limitar a quantidade de conteúdo carregada por requisição, e a velocidade da página é um fator de ranqueamento confirmado. Ela também cria uma trilha de links internos rastreáveis que o Google pode seguir para chegar a conteúdos enterrados fundo em um catálogo ou arquivo. Sem essa trilha, as páginas além da primeira tela podem ficar, na prática, órfãs: tecnicamente no ar, mas nunca descobertas porque nada aponta para elas. Nosso guia sobre links internos trata da detecção de páginas órfãs com mais profundidade, caso você suspeite que isso já esteja acontecendo no seu site.
O lado negativo
O mesmo mecanismo cria risco. Cada URL paginada é uma quase duplicata das vizinhas, com o mesmo template, a mesma barra lateral e a mesma estrutura em torno de outros dez ou vinte itens. Os mecanismos de busca precisam de uma forma de distinguir essas páginas sem tratá-las como conteúdo duplicado, e é aí que entram as tags canonical, as URLs únicas e os links consistentes. Se qualquer um desses pontos falhar, você cria exatamente a confusão que os mecanismos de busca tentam evitar.
Há um segundo risco, do lado técnico. O Google rastreia URLs que encontra no atributo href das tags de âncora, e só nele. Ele não executa manipuladores de clique de "Carregar mais" e, em geral, não aciona funções JavaScript que atualizam o conteúdo sem uma mudança real de URL. Se a sua paginação depende inteiramente de interação em JavaScript, sem um href rastreável, o conteúdo depois da página 1 pode nunca ser indexado. Nosso texto sobre por que aplicativos de página única somem do Google aborda isso com mais profundidade, já que a navegação dependente de JavaScript é um dos maiores riscos que sites SPA e catálogos muito paginados têm em comum.
Os números por trás do impacto da paginação nos rankings
A maioria dos conselhos sobre paginação fica no abstrato, com frases como "afeta a rastreabilidade" e "afeta a velocidade da página". Os números reais são mais concretos, e vêm do próprio Google.
Comece pela velocidade. O programa Core Web Vitals do Google define três limites específicos para uma boa experiência de página. O Largest Contentful Paint, o tempo até o conteúdo principal ser renderizado, deve ficar abaixo de 2,5 segundos. O Interaction to Next Paint deve ficar abaixo de 200 milissegundos, e o Cumulative Layout Shift deve ficar abaixo de 0,1. Esses números vêm diretamente da documentação do próprio Google no web.dev, da mesma equipe que mantém as Core Web Vitals como um insumo de ranqueamento.
Uma página de categoria paginada com 24 produtos tem uma vantagem óbvia nas três métricas em comparação com o mesmo catálogo renderizado como uma única página contínua de 400 produtos. Há menos HTML para processar, menos imagens competindo por banda no primeiro carregamento e menos layout para se deslocar conforme o conteúdo chega. O Search Console informa o desempenho das Core Web Vitals agrupado por padrões de URL semelhantes, então um site pode acompanhar uma série paginada passar de "needs improvement" para "good" conforme as correções entram, no mesmo relatório usado para diagnosticar problemas de indexação.
O orçamento de rastreamento (crawl budget) é o outro número que vale conhecer, e o Google é incomumente direto sobre quem deve se preocupar com ele. A documentação sobre crawl budget afirma claramente que a maioria dos sites não precisa pensar nisso, e que é uma preocupação para sites muito grandes, com URLs que mudam com frequência. Um blog com algumas centenas de posts ou uma loja com alguns milhares de SKUs não se encaixa nessa descrição. A regra prática que a maioria dos profissionais de SEO tira da forma como o Google apresenta o guia coloca o limite em algum ponto na casa das dezenas de milhares de URLs, ou mais. Abaixo dele, uma resposta lenta do servidor ou um link quebrado é muito mais provável de ser o verdadeiro gargalo. Acima dele, o excesso de paginação passa a ser um dos primeiros lugares que vale auditar, especialmente onde parâmetros de filtro e de ordenação multiplicam alguns milhares de URLs base em centenas de milhares de combinações rastreáveis.
Os dois números se conectam. Uma série que carrega rápido mantém as Core Web Vitals dentro do limite em todas as páginas, e uma série mantida enxuta, sem combinações de filtro descontroladas e sem variantes duplicadas sem fim, mantém o orçamento de rastreamento apontado para páginas que realmente podem ranquear. Acerte os dois e a paginação deixa de ser um custo para o desempenho e a indexação e passa a proteger ambos.
Paginação no celular: áreas de toque e alcance do polegar
A orientação de usabilidade móvel do Google recomenda áreas de toque de pelo menos 48x48 pixels CSS, com cerca de 8px de espaçamento entre elas, números que vêm da própria documentação de acessibilidade e de UX móvel do Google. Controles de paginação amontoados em uma fileirinha minúscula de números de página muitas vezes reprovam nesse teste, principalmente depois da página 10, quando um número de dois dígitos precisa se espremer em uma caixa dimensionada para um dígito. A solução é manter os controles "Anterior" e "Próxima" grandes e bem espaçados, e reduzir o miolo numerado a algo como 1, 2, 3 … 9, 10, 11, em vez de imprimir todos os números de página colados uns nos outros.
Uma barra de paginação difícil de tocar com precisão no celular frustra os usuários e torna a rastreabilidade irrelevante se ninguém consegue chegar à página 4 sem errar o toque três vezes. Como a maior parte do tráfego comercial é mobile first, teste em um celular de verdade, e não em uma janela de navegador de desktop redimensionada, antes de supor que uma série paginada funciona como o layout do projeto sugeria.
Paginação x rolagem infinita x "carregar mais"
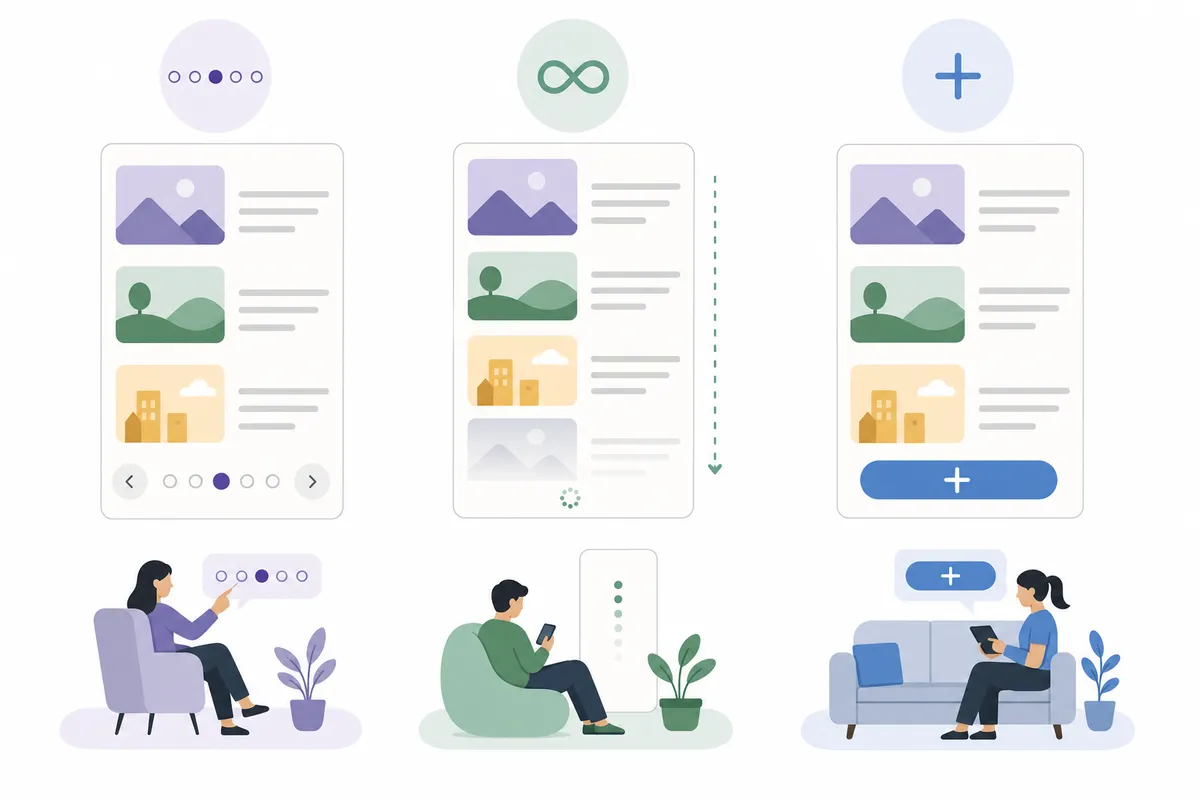
Paginação, rolagem infinita e botões de "carregar mais" resolvem o mesmo problema de UX, o excesso de conteúdo para uma tela, mas têm consequências diferentes para o SEO.
A paginação divide o conteúdo em URLs separadas e endereçáveis. A rolagem infinita carrega mais conteúdo automaticamente conforme o usuário rola uma única URL, e o botão de carregar mais fica no meio do caminho, como um clique manual que expande a página atual sem necessariamente mudar a URL. Essa diferença decide se um rastreador consegue ou não chegar ao seu conteúdo.
Comparando os três padrões
| Padrão | Rastreabilidade para SEO | Experiência do usuário | Mais indicado para |
|---|---|---|---|
| Paginação | Forte: cada página tem uma URL única e rastreável | Noção clara de progresso e do tamanho total; fácil retomar em uma página específica | Catálogos de produtos, arquivos, qualquer coisa que o usuário precise comparar ou revisitar |
| Rolagem infinita | Fraca, a menos que seja combinada com URLs rastreáveis nos bastidores | Sensação contínua e imersiva; pode causar "fadiga de rolagem" em listas enormes | Feeds sociais, descoberta de imagens, navegação voltada ao engajamento |
| Carregar mais | Fraca: o conteúdo normalmente carrega na mesma URL via JavaScript | Dá ao usuário sensação de controle sem recarregar a página inteira | Listas de tamanho moderado em que a rolagem infinita completa parece exagerada |
A própria documentação do Google é direta sobre essa troca. A paginação permite que os usuários vejam o tamanho total de uma lista e saibam onde estão nela, ao custo de um clique extra entre as páginas, enquanto a rolagem infinita parece fluida, mas esconde o tamanho total da lista e pode dificultar reencontrar conteúdo mais antigo.
Como fazer a rolagem infinita funcionar para a busca
A rolagem infinita não precisa ser um beco sem saída para o SEO, mas precisa de ajuda. A solução é combinar o comportamento de rolagem com URLs paginadas reais por baixo, de modo que um rastreador que acesse /products?page=2 diretamente receba o mesmo conteúdo que um usuário rolando acabaria vendo. history.pushState() também deve atualizar a barra de endereços conforme o usuário rola, para que cada segmento continue podendo ser linkado e compartilhado. Sem essa camada, a rolagem infinita vira uma única URL com conteúdo que o rastreador nunca alcança. A acessibilidade também sofre, porque a rolagem infinita pode desorientar usuários de leitores de tela e enterrar o rodapé da página de um jeito que a paginação tradicional não faz.
Padrões de acessibilidade e rolagem infinita
A preocupação com acessibilidade tem base formal. As Web Content Accessibility Guidelines (Diretrizes de Acessibilidade para Conteúdo Web), mantidas pela W3C Web Accessibility Initiative, estabelecem dois requisitos relevantes: os usuários precisam conseguir perceber onde estão em um conjunto de conteúdo e precisam conseguir navegar por ele só com o teclado, sem mouse. A rolagem infinita pode falhar nos dois. Usuários de leitor de tela que navegam pela página com a tecla Tab dependem de chegar ao rodapé para saber que a página terminou, e, se novo conteúdo continua carregando por baixo deles, o rodapé nunca chega. Usuários que só usam o teclado enfrentam um problema parecido, porque o foco pode saltar de forma imprevisível quando novas seções são montadas, deixando-os em um ponto da página que não escolheram.
As correções práticas são bem documentadas. Combine a rolagem com um controle visível de "carregar mais", que usuários de teclado e de leitor de tela possam acionar de propósito, em vez de depender da posição de rolagem. Use uma região ARIA live configurada como "polite" para anunciar o novo conteúdo conforme ele carrega, para que os usuários de leitor de tela saibam que algo mudou sem perder o lugar no documento. Mantenha um link de rodapé real e alcançável, ou um controle de "voltar ao topo", para que a página tenha um fim claro. Esse é o mesmo padrão que as WCAG exigem de qualquer página atualizada dinamicamente, e a rolagem infinita o descumpre com mais frequência do que a maioria dos padrões, porque conteúdo que nunca para de chegar é justamente a sua razão de ser.
Quando a paginação não é a solução certa
A paginação se justifica quando uma lista é realmente longa, mas muitas listas não são. Uma categoria com 18 produtos não precisa de cinco páginas de quatro itens cada, porque uma única página carrega tão rápido quanto e dá ao Google uma página forte para ranquear, em vez de cinco fracas. O limite em que a maioria dos sites chega é de 40 a 60 itens na página um antes de dividir, o que mantém uma única página dentro dos limites das Core Web Vitals e evita duplicação sem sentido.
A mesma lógica vale para conteúdo longo. Dividir um artigo de 1.200 palavras em três "partes" fracas para inflar as visualizações de página tende a prejudicá-lo, já que cada parte fica curta demais para ranquear bem sozinha e a divisão acrescenta atrito para os leitores. Uma única página completa, com títulos claros, também é mais fácil para um sistema de IA resumir ou citar do que uma sequência de fragmentos curtos. Antes de adicionar paginação a qualquer coisa, pergunte-se se a lista é de fato longa demais para renderizar bem em uma página ou se foi dividida só para parecer mais movimentada.
Os erros de paginação que derrubam seus rankings em silêncio
É aqui que acontece a maior parte do estrago. Nenhum desses erros parece dramático em um navegador, já que as páginas continuam carregando e o botão "próxima" continua funcionando. O dano aparece no Google Search Console e nos logs de rastreamento, semanas depois.
Erro 1: Canonicalizar todas as páginas de volta para a página 1
Este é o erro de paginação mais comum. Um desenvolvedor bem-intencionado define a tag canonical de todas as URLs paginadas para apontar de volta para a página 1, acreditando que isso vai "consolidar" os sinais de ranqueamento. O que isso realmente diz ao Google é que as páginas 2 a 50 não devem ser indexadas por conta própria porque são duplicatas da página 1, e o Google muitas vezes respeita essa instrução e tira essas páginas do índice. Se o seu catálogo tem produtos exclusivos que existem só na página 4 ou na página 12, esses produtos desaparecem da busca na prática.
Cada página de uma série paginada deve ter uma canonical autorreferente, uma tag que aponta para ela mesma. Se você não tem certeza de que suas tags canonical estão fazendo o que você pensa, leia nossa análise sobre erros de tag canonical que causam conteúdo duplicado, já que esse mesmo erro aparece o tempo todo também fora da paginação.
Erro 2: Aplicar noindex em páginas paginadas "para limpar o índice"
Algumas equipes seguem o caminho oposto e adicionam noindex a todas as páginas além da página 1, supondo que isso vai arrumar os resultados de busca e canalizar autoridade para a página principal da categoria. Isso costuma sair pela culatra. O noindex diz ao Google para tirar a página do índice por completo, então, se essa página é o único lugar onde um determinado produto, artigo ou post de fórum existe, o conteúdo deixa de aparecer na busca.
Combinar uma tag noindex com uma tag canonical na mesma página piora a situação. Uma diz "não me indexe" e a outra diz "sou a versão oficial desta URL", e o Google precisa adivinhar em qual confiar, o que nem sempre joga a seu favor.
Erro 3: Controles de navegação apenas em JavaScript
Se o seu controle de "próxima página" é um <button> com um manipulador onclick e sem um href real, você está apostando as suas páginas profundas em que o Googlebot execute seu JavaScript perfeitamente toda vez, em cada rastreamento. É uma aposta ruim. O Google rastreia as URLs que encontra dentro de atributos href em tags de âncora, não clica em botões e, em geral, não aciona os scripts dependentes de interação do usuário que muitos frameworks de front-end usam para trocar o conteúdo. Todo controle de "próxima" e "anterior" deve ser uma tag de âncora real apontando para uma URL real e rastreável. O JavaScript ainda pode melhorar a experiência do clique, desde que o link subjacente exista no código.
Erro 4: Deixar parâmetros de filtro e de ordenação multiplicarem suas URLs
Uma página de categoria paginada já é uma URL multiplicada por dezenas de páginas. Acrescente filtros como tamanho, cor, preço e marca, mais opções de ordenação como preço crescente ou mais recentes primeiro, e uma única categoria pode gerar milhares de combinações de URL quase idênticas. Os mecanismos de busca não querem todas elas indexadas, porque a maioria não agrega valor único e só dilui a atenção do rastreamento entre conteúdos quase duplicados.
A solução é uma meta tag noindex nas variantes de URL filtradas e ordenadas, ou uma regra disallow no robots.txt para os padrões de parâmetro específicos. Em qualquer dos casos, os rastreadores param de gastar atenção limitada em combinações que nunca vão ranquear. A sintaxe do disallow no robots.txt agora é um padrão formal da IETF, a RFC 9309, o que vale saber caso algum desenvolvedor questione se os principais rastreadores respeitam uma regra disallow.
Erro 5: Usar fragmentos de URL em vez de caminhos reais
Algumas implementações de paginação usam um identificador de fragmento, a parte da URL depois de um #, para representar o número da página, como em /products#page2. O Google ignora tudo o que vem depois de um # ao avaliar uma URL, então, se a única diferença entre duas URLs é o texto depois dele, o Googlebot pode tratá-las como a mesma página que já buscou e nem se dar ao trabalho de rastrear o que ele acha que é uma duplicata. Os números de página pertencem ao caminho ou a um parâmetro de consulta real.
Erro 6: Otimizar demais cada página da série
É tentador escrever um título e uma meta description únicos e cheios de palavras-chave para cada página paginada, como você faria com páginas realmente distintas. Aí a página 2 de uma categoria "tênis de corrida" passa a competir com a página 1 da mesma categoria pela mesma palavra-chave, o que é canibalização de palavra-chave contra você mesmo. A solução padrão é desotimizar as páginas paginadas depois da página 1. O Google confirmou que títulos e descrições parecidos ou idênticos ao longo de uma sequência paginada não são problema, já que ele reconhece a relação e indexa de acordo. Concentre a segmentação da sua palavra-chave principal, os links internos e a otimização on-page na página raiz da categoria.
Erro 7: Quebrar a cadeia de links
A paginação depende de conexões rastreáveis entre as páginas. Se a página 3 linka para a página 4, mas nada linka de volta para a página 1, ou se a sequência se rompe em algum ponto do meio, o Google tem mais dificuldade para entender a série e mais dificuldade para chegar às páginas mais distantes do início. A boa prática é linkar cada página para a seguinte na sequência e linkar todas as páginas de volta para a página 1, o que sinaliza que a página 1 é o ponto de entrada natural.
Este é um caso específico de um problema mais amplo: páginas que existem, mas não estão bem conectadas ao restante do site. Nosso aprofundamento sobre erros de estrutura de site que custam rankings trata do mesmo padrão de falha fora da paginação.
Erro 8: Tratar a rolagem infinita como um atalho de rastreabilidade
A rolagem infinita parece moderna e realmente melhora as métricas de engajamento em feeds de conteúdo. Mas trocar a navegação paginada por rolagem infinita sem adicionar URLs rastreáveis por baixo é uma das histórias mais comuns do tipo "refizemos o site e o tráfego caiu" no SEO. Se um rastreador só vê o primeiro lote de itens na URL base e todo o resto carrega na rolagem, sem uma estrutura de links correspondente, tudo o que vem depois desse primeiro lote fica invisível para os mecanismos de busca, mesmo que os usuários consigam ver tudo.
Erro 9: Ignorar o orçamento de rastreamento em catálogos muito grandes
Para um site com algumas centenas de páginas, o orçamento de rastreamento quase não importa. Para um site com dezenas de milhares de páginas paginadas de produtos ou de arquivo, importa muito, porque cada URL paginada fraca e quase duplicada que o Google rastreia é atenção que ele não está dedicando às suas páginas de maior valor. Um excesso de páginas mal podado, principalmente combinado com parâmetros de filtro e de ordenação sem controle, pode reduzir de forma mensurável a velocidade com que conteúdo novo ou atualizado em outras partes do site é captado. Se páginas ficam semanas sem ser indexadas, o excesso de paginação é uma causa raiz comum, e nosso guia sobre por que páginas são ignoradas na indexação mostra como diagnosticar isso.
A própria documentação de crawl budget do Google é direta sobre quem se enquadra: sites sem um grande número de URLs que mudam com frequência, em geral, não precisam se preocupar com isso. Um blog pequeno raramente precisa deste guia, enquanto um catálogo de 200.000 SKUs precisa.
Como estruturar a paginação para que ela ajude de fato nos rankings
Corrigir a paginação não é complicado quando você conhece o checklist. Quase tudo se resume a desfazer um dos nove erros acima, de forma consistente, em toda a série.
1. Use canonical autorreferente em todas as páginas
Cada URL paginada deve ter uma tag canonical apontando para ela mesma: a canonical da página 2 aponta para a página 2, a da página 3 para a página 3, e assim por diante. Essa única mudança resolve o erro mais danoso da lista.
2. Use URLs claras, descritivas e rastreáveis
Dê a cada página da série a sua própria URL real, acessível por um link href padrão, como /category?page=2 ou /category/page/2. Uma troca de conteúdo acionada por JavaScript em um único endereço não conta. Padrões de URL consistentes também facilitam muito auditar uma série paginada em escala depois.
3. Não use identificadores de fragmento para números de página
Mantenha o número da página no caminho ou como um parâmetro de consulta real. O Google ignora por completo a parte da URL depois de um #, então um fragmento não consegue distinguir uma página da outra.
4. Desotimize as páginas além da página 1
Deixe a página raiz carregar a sua segmentação de palavra-chave principal, seus links internos mais fortes e o seu melhor texto on-page. As páginas 2 em diante podem compartilhar títulos e meta descriptions parecidos, o que é um comportamento esperado em uma série paginada e não é sinal de penalização por conteúdo duplicado.
5. Mantenha as páginas paginadas indexáveis
Resista à tentação de aplicar noindex nas páginas depois da página 1 "só por precaução". A menos que uma página específica tenha realmente pouco valor, como uma variante filtrada ou ordenada, deixe-a indexável para que qualquer conteúdo único nela ainda possa ser encontrado.
6. Linke as páginas em sequência e de volta para a página 1
Toda página deve linkar para a próxima e de volta para a página 1. Isso dá ao Google um caminho limpo e consistente pela série e reforça qual página merece mais autoridade.
7. Controle o excesso de parâmetros de filtro e de ordenação
Decida de antemão quais combinações de parâmetros merecem ser indexadas (em geral, nenhuma) e bloqueie o restante com noindex ou regras de robots.txt. Isso mantém o orçamento de rastreamento focado em páginas que realmente podem ranquear.
8. Ajude rastreadores e usuários com preload e prefetch
A documentação do Google recomenda especificamente fazer preload, preconnect ou prefetch da próxima página da sequência. Isso acelera a experiência de quem avança pela série e reforça o sinal de velocidade de página que a paginação foi em parte criada para proteger.
9. Verifique a cadeia inteira com uma auditoria técnica
A paginação toca tags canonical, links internos, diretivas de indexação e caminhos de rastreamento ao mesmo tempo, então é fácil acertar uma peça e errar outra sem perceber. Uma auditoria de SEO técnico completa verifica os quatro itens juntos, e vale rodar uma antes e depois de qualquer mudança grande na paginação.
Hreflang e paginação em sites multilíngues
Sites que mantêm várias versões de idioma do mesmo catálogo paginado acrescentam uma camada que a maioria dos conselhos sobre paginação ignora. Cada URL paginada precisa do seu próprio conjunto de hreflang, o que significa que a página 3 do catálogo em inglês deve apontar para a página 3 das versões em francês e em alemão, e não para as páginas 1 delas. O erro comum é tratar o hreflang como uma configuração só da página 1 e deixá-lo sumir em silêncio de todas as páginas seguintes, o que deixa o Google adivinhando a correspondência de idioma certa para as páginas 2 a 40 em cada mercado.
Perder o hreflang nas páginas profundas causa tanto dano quanto uma canonical ausente, porque diz aos mecanismos de busca que a relação entre as versões de idioma termina depois da primeira página, mesmo que o catálogo obviamente continue. Verifique isso especificamente durante uma auditoria, em vez de presumir que o CMS levou a configuração adiante, já que muitos templates tratam hreflang e paginação como duas configurações sem relação que nunca foram testadas juntas.
Um exemplo prático: reconstruindo a paginação de uma categoria de 40 páginas
Conselhos abstratos são fáceis de aceitar e difíceis de aplicar. Veja como é corrigir uma categoria paginada passo a passo, usando uma loja hipotética com uma categoria "Running Shoes" distribuída em 40 páginas de 20 produtos cada, 800 produtos no total.
Passo 1: Descubra o que está realmente quebrado
Antes de mexer em qualquer código, puxe a tag canonical, a meta tag robots e o href do link "próxima" de uma amostra de cinco páginas: página 1, página 2, página 10, página 25 e página 40. Neste exemplo, as páginas 2 a 40 trazem todas:
<link rel="canonical" href="https://example.com/running-shoes" />
Este é o erro mais comum da lista. Toda página depois da página 1 aponta sua canonical de volta para a categoria raiz, o que diz ao Google que as páginas 2 a 40 não existem como entidades próprias.
Passo 2: Corrija a direção da canonical
A correção é uma mudança de uma linha no template, aplicada no site inteiro em vez de página por página. A canonical da página 2 deve ser:
<link rel="canonical" href="https://example.com/running-shoes?page=2" />
O mesmo padrão vale até a página 40, cada página apontando para si mesma. Na maioria das plataformas de CMS, isso é uma única condicional no template da categoria, e não quarenta edições manuais. Isso também explica por que o erro é tão comum: quem escreveu o template inverteu a lógica uma vez, e isso se aplicou em silêncio a todas as páginas de todas as categorias dali em diante.
Passo 3: Verifique a cadeia de links
Com as canonicals corrigidas, confirme que a página 2 linka para a página 3, a página 3 para a 4, e assim por diante até a página 40, e que toda página também linka de volta para a página 1. Um rastreamento com uma ferramenta como o Screaming Frog, filtrado por esse padrão de URL, deve mostrar uma cadeia contínua, sem lacunas. Neste exemplo, a cadeia se rompe na página 23, onde um bug no componente de paginação derruba o link "próxima" quando o número da página passa dos dois dígitos depois de 20. Vale pegar isso antes de dar a correção por concluída, porque uma canonical corrigida é inútil se o rastreador nunca consegue chegar à página cuja canonical você acabou de consertar.
Passo 4: Desotimize tudo depois da página 1
O título da página 1, "Running Shoes | 800+ Styles, Free Shipping | Example Shop", fica intocado porque carrega a palavra-chave principal. As páginas 2 a 40 recebem um título quase idêntico com o número da página acrescentado, como "Running Shoes | Page 3 | Example Shop". Isso é melhor do que quarenta títulos escritos de forma única competindo com a página 1 pelos mesmos termos de busca. O Google confirmou que essa duplicação ao longo de uma série paginada é esperada e não é problema; o que causa autocompetição são quarenta títulos únicos disputando uma só palavra-chave.
Passo 5: Rastreie de novo e reenvie
Depois que as mudanças no template forem ao ar, envie a URL atualizada da categoria pela ferramenta Inspeção de URL (URL Inspection) do Search Console para pedir um novo rastreamento mais rápido da página 1, e deixe o restante da série ser captado pelo rastreamento normal, por meio dos links internos agora corrigidos. Não envie as 40 URLs manualmente, já que a cadeia de links do Passo 3 existe justamente para cuidar delas.
Passo 6: Acompanhe o relatório de indexação para confirmar
Espere de duas a quatro semanas e volte ao relatório Page Indexing do Search Console, filtrando pelo padrão de URL da categoria. As páginas antes rotuladas como "Duplicate without user-selected canonical" devem começar a passar para "Indexed". A mudança acontece um lote por vez, já que o Google rastreia as páginas de novo em ritmos diferentes, conforme a frequência com que cada uma mudou historicamente. Uma página enterrada na posição 35, raramente rastreada porque nada nela muda com frequência, pode levar bem mais tempo para virar do que a página 2, o que é esperado e não é sinal de que a correção falhou.
O que mudou
Três correções no nível do template (direção da canonical, um link quebrado na cadeia e a duplicação de títulos) substituem o que de outra forma seriam quarenta correções manuais separadas. Essa proporção é o verdadeiro argumento para corrigir a paginação no nível do template: um erro de lógica criou o problema em um catálogo inteiro, e um template corrigido o remove do mesmo jeito.
Paginação não é só uma escolha de front-end: paginação no estilo de API
A maioria das conversas de SEO sobre paginação se concentra na página que você vê no navegador. Mas, se o seu site roda em um CMS headless, em uma loja personalizada ou em qualquer coisa que busque dados de produtos e de conteúdo em uma API, o método de paginação que o seu back-end usa pode determinar o que o front-end sequer é capaz de expor aos rastreadores.
Como disse o desenvolvedor Phil Sturgeon em um texto muito lido sobre paginação de APIs, "pagination is basically breaking down a large dataset into smaller chunks, which can be fetched incrementally by a client." As três abordagens comuns trazem, cada uma, compensações reais.
| Método | Como funciona | Mais forte para | Ponto fraco |
|---|---|---|---|
| Baseado em página | O cliente solicita page=2&size=10; o servidor devolve essa página mais a contagem total de páginas |
Interfaces simples que mostram links numerados de página | Contar o conjunto de dados inteiro fica mais lento conforme ele cresce |
| Baseado em offset | O cliente solicita offset=10&limit=10; o servidor pula adiante e devolve o próximo bloco |
Back-ends simples, consultas SQL com LIMIT/OFFSET |
O desempenho cai bruscamente em offsets altos em tabelas grandes |
| Baseado em cursor | O cliente envia um cursor opaco (muitas vezes um ID de registro codificado) indicando onde a última página terminou | Conjuntos de dados muito grandes e que mudam com frequência | Mais difícil montar diretamente a partir dele uma interface do tipo "página 1, 2, 3… 10" |
A lição prática para o SEO é que, se o seu back-end usa paginação baseada em cursor por motivos de desempenho, o front-end ainda precisa gerar URLs estáveis, rastreáveis e que possam ser salvas como favoritos para cada página. Um cursor de API opaco que muda toda vez que o conjunto de dados é atualizado não serve, porque URLs inconsistentes entre rastreamentos tornam muito mais difícil para o Google reconhecer a "página 2 de hoje" como a página que ele indexou na semana passada.
Isso importa mais do que antes, já que as páginas são cada vez mais lidas por sistemas de IA que resumem ou citam conteúdo, além de navegadores e rastreadores. Uma série paginada com URLs instáveis confunde esses sistemas tanto quanto confunde o Googlebot. Se isso é uma prioridade para o seu catálogo ou arquivo de conteúdo, nossa página sobre generative engine optimization mostra como a consistência estrutural alimenta a descoberta por IA de forma mais ampla.
Séries paginadas devem ter dados estruturados?
Dados estruturados não consertam uma canonical invertida nem um link ausente, mas respondem a uma pergunta que o restante deste guia deixa em aberto: uma série paginada deve dizer explicitamente aos mecanismos de busca como é a coleção inteira, além do que está na página atual?
O Schema.org, o vocabulário de dados estruturados mantido em conjunto por Google, Microsoft, Yahoo e Yandex, define um tipo ItemList para exatamente essa situação: um conjunto de itens com uma ordem definida. Ele descreve uma série paginada como uma única lista lógica, em vez de quarenta páginas sem relação. Uma implementação mínima na página 3 de uma categoria de 40 páginas poderia ser assim:
{
  "@context": "https://schema.org",
  "@type": "ItemList",
  "itemListElement": [
    { "@type": "ListItem", "position": 41, "url": "https://example.com/products/trail-runner-x1" },
    { "@type": "ListItem", "position": 42, "url": "https://example.com/products/trail-runner-x2" }
  ]
}
Os valores de position seguem ao longo de toda a série, em vez de reiniciar a cada página. Os itens 41 e 42, por exemplo, ficam na página 3 de uma série com 20 itens por página, o que permite que qualquer coisa que leia a marcação veja onde uma determinada página se encaixa dentro da coleção completa.
O Google não exige a marcação ItemList para entender ou indexar corretamente uma série paginada, porque as tags canonical e os links internos vistos antes já fazem esse trabalho sozinhos. O que o ItemList acrescenta é uma descrição da coleção mais limpa e legível por máquina para qualquer sistema que processe dados estruturados, inclusive os mecanismos de resposta que leem cada vez mais a marcação de uma página, e não apenas o texto renderizado. Um catálogo de produtos que adiciona ItemList à sua série paginada dá a esses sistemas uma visão explícita e ordenada ("aqui estão os itens 41 a 60 de uma lista de 800"), em vez de forçá-los a inferir a estrutura a partir de quarenta documentos HTML separados. Para sites que investem em visibilidade além dos resultados de busca tradicionais, é um acréscimo razoável e de baixo custo, depois que os fundamentos de canonical e de links estiverem sólidos.
A ordem das operações importa. Corrigir uma canonical invertida em uma série de 40 páginas vale ser feito esta semana, enquanto adicionar a marcação ItemList à mesma série pode esperar até que os fundamentos estejam firmes.
Ferramentas para auditar a paginação em escala
Checar a paginação à mão funciona para um tópico de fórum de cinco páginas e desmorona em um catálogo de 40.000 SKUs. O Screaming Frog é o ponto de partida mais comum: sua versão gratuita rastreia até 500 URLs, e uma licença paga remove esse limite e acrescenta a extração personalizada necessária para puxar tags canonical e valores de href de todas as páginas paginadas de uma só vez. O Sitebulb se baseia na mesma ideia, com um mapa de rastreamento visual que facilita enxergar uma cadeia de links quebrada melhor do que rolar uma planilha.
O JetOctopus e o ContentKing monitoram o comportamento de rastreamento de forma contínua, em vez de uma única foto. Isso importa aqui porque um bug de template pode reintroduzir em silêncio uma canonical quebrada meses depois de a correção original ter ido ao ar. Nenhuma dessas ferramentas substitui o relatório Page Indexing do Google Search Console, o único lugar que mostra como o próprio Google está tratando cada URL paginada neste momento. Um rastreador fornece o "porquê" por trás do que o Search Console mostra como sintoma, então rodar um rastreamento e o Search Console juntos pega problemas que nenhum dos dois revela com clareza sozinho.
Como auditar e corrigir problemas de paginação
Encontrar um problema de paginação costuma dar menos trabalho do que as pessoas esperam, porque os sinais são consistentes quando você sabe o que verificar.
O que verificar primeiro
Comece pelo relatório Page Indexing do Google Search Console e procure URLs paginadas rotuladas como "Duplicate without user-selected canonical" ou "Alternate page with proper canonical tag". Ambos são fortes indícios de que a sua estratégia de canonical aponta na direção errada. Depois, rastreie o site diretamente com uma ferramenta como o Screaming Frog, filtrada por padrões de URL paginada, e compare o que a tag canonical e a meta tag robots de cada página dizem com o que você espera que digam.
| Verificação | Onde olhar | Como é um problema |
|---|---|---|
| Direção da canonical | Código-fonte da página, <link rel="canonical"> |
As páginas 2+ canonicalizam para a página 1 em vez de para si mesmas |
| Status de indexação | Google Search Console → Page Indexing | URLs paginadas rotuladas como duplicadas ou excluídas |
| Alcance dos links | Rastreamento do site (Screaming Frog, JetOctopus etc.) | Links "próxima" sem href, ou presentes apenas em JS |
| Excesso de parâmetros | Relatório de rastreamento, contagem de parâmetros de URL | Centenas de combinações de filtro/ordenação sendo rastreadas |
| Uso de fragmentos | Revisão da estrutura de URLs | Números de página aparecendo depois de um # |
Corrigindo o que você encontrar
Depois de identificar qual erro está em jogo, a correção quase sempre é uma das nove correções acima: inverter a direção da canonical, remover um noindex desnecessário, trocar um controle só em JS por um link real ou apertar as regras de robots nas variações de parâmetros. A parte mais difícil é a priorização. Em um catálogo com milhares de URLs paginadas, corrigir a direção da canonical em todo o site tende a produzir a maior e mais rápida recuperação, já que afeta todas as páginas de todas as séries de uma vez. Se a paginação for apenas um sintoma de um problema maior de orçamento de rastreamento ou de indexação, nosso guia mais amplo de correções de SEO técnico é uma boa próxima leitura.
Quanto tempo leva a recuperação depois de corrigir a paginação
Esta é a pergunta que a maioria dos guias pula, e é a que as pessoas realmente querem ver respondida: depois de corrigir uma canonical quebrada ou uma tag noindex, quanto tempo até as páginas voltarem?
Não há um número fixo, e a própria documentação de rastreamento e indexação do Google não finge o contrário. Ela descreve o momento do novo rastreamento como determinado pela demanda de rastreamento, ou seja, pela importância que o Google atribui a uma URL e pela frequência com que ela mudou historicamente, e não por um cronograma garantido. Ainda assim, um padrão aproximado se repete na maioria dos sites que fazem uma correção de paginação em todo o site.
A página 1 e as páginas de categoria de alto tráfego costumam ser rastreadas de novo em poucos dias, já que o Google já as visita com frequência, e enviar a URL pela ferramenta Inspeção de URL do Search Console pode encurtar isso para um ou dois dias.
As páginas do meio da série (aproximadamente as páginas 2 a 10) costumam vir em seguida, de uma a três semanas, captadas pelo rastreamento normal da cadeia de links internos corrigida, e não por envio manual.
As páginas do fundo da série (página 20 em diante) podem levar um mês ou mais, principalmente em sites que o Google rastreia com menos frequência. Essas páginas tinham a menor prioridade de rastreamento antes da correção, e uma canonical corrigida não a aumenta automaticamente; ela apenas remove a barreira ativa que as mantinha fora.
A recuperação completa do ranking, em oposição à simples reindexação, costuma ficar mais algumas semanas atrás da reindexação. Uma página pode voltar ao índice e ainda levar tempo para recuperar os rankings que tinha antes, porque o Google está reavaliando como essa página se encaixa na versão atual do site, em vez de restaurar um ranking em cache de antes do erro.
Uma cadeia de links internos limpa e sem quebras, um sitemap que lista as URLs corrigidas e uma forte autoridade do site aceleram tudo isso. Um site consolidado, com visitas frequentes do Googlebot, sempre se recuperará mais rápido do que um menor, que o Google rastreia semanalmente. Um catálogo grande em que o padrão quebrado atingiu dezenas de milhares de URLs, ou um site cujo orçamento de rastreamento já era limitado antes da correção, se recuperará mais devagar.
Se passarem de quatro a seis semanas sem nenhuma movimentação na página 1 e nas páginas de categoria de maior tráfego, é provável que a correção não tenha pegado por completo. Essa situação é diferente de uma recuperação lenta, e vale reauditar em vez de esperar mais.
Paginação em diferentes plataformas
Os padrões de paginação variam muito de plataforma para plataforma, e uma configuração que é aceitável em um CMS pode ser um problema em outro.
As plataformas de e-commerce são o caso de maior risco, já que as páginas de categoria muitas vezes paginam centenas de produtos e impulsionam diretamente a receita. Se o seu catálogo segue as boas práticas de SEO para e-commerce, a canonicalização da paginação e o controle de parâmetros devem estar perto do topo do checklist, e não ser tratados uma vez por ano como um detalhe de última hora.
Além do e-commerce, as plataformas de CMS diferem no quanto de controle de paginação expõem de fábrica. Algumas geram por padrão páginas de arquivo paginadas com canonical autorreferente, enquanto outras exigem edições manuais no template para acertar a estrutura de canonical e de links. Se você trabalha dentro das restrições de uma plataforma específica, nossos guias de SEO por CMS mostram as configurações que importam para a sua stack, inclusive onde os padrões de paginação costumam precisar de ajuste.
Alguns exemplos concretos mostram o quanto os padrões diferem. A paginação nativa do WordPress (/blog/page/2/, gerada pela função nativa paginate_links()) é autocanonicalizante por padrão: cada arquivo paginado recebe a própria canonical apontando para si mesmo, e os plugins de SEO populares costumam preservar esse comportamento. O erro comum no WordPress vem de um tema ou de um plugin de page builder sobreposto que reescreve em silêncio a canonical de volta para a página 1.
As páginas de coleção da Shopify paginam automaticamente depois de um certo número de produtos, comumente 36 ou 50, dependendo do tema. A Shopify gera tags canonical que apontam cada página de coleção paginada para ela mesma, o que é um padrão correto. As lojas costumam ter problemas com parâmetros de filtro e de ordenação aplicados sobre as coleções por meio de aplicativos ou de widgets de filtragem personalizados, que podem gerar grandes volumes de combinações de parâmetros rastreáveis fora dos padrões da própria plataforma.
O WooCommerce roda sobre o WordPress e herda sua mecânica de paginação para os arquivos de loja e de categoria, então o mesmo padrão autocanonicalizante em geral se aplica. As lojas WooCommerce costumam adicionar plugins de filtro de terceiros para faixa de preço, atributo ou marca, e eles introduzem o mesmo problema de excesso de parâmetros que as lojas Shopify enfrentam, por meio de um conjunto diferente de plugins.
Lojas headless e feitas sob medida não têm padrão algum: o comportamento que você recebe é o que a equipe de front-end implementar. É também por isso que os sites headless aparecem desproporcionalmente nos erros de direção de canonical, já que nenhuma convenção de plataforma os protege em silêncio como acontece no WordPress ou na Shopify.
Em todas essas plataformas, a plataforma-base raramente é onde a paginação quebra. Um tema, plugin, aplicativo ou template personalizado sobreposto costuma substituir um padrão correto por um incorreto, então verifique primeiro essas camadas em qualquer plataforma antes de culpar o próprio CMS.
Mitos comuns sobre paginação que valem ser aposentados
Algumas crenças sobre paginação continuam circulando muito depois de deixarem de ser verdadeiras. A primeira é que rel="next"/"prev" ainda ajuda o Google a entender uma série, quando o Google ignora as duas tags desde antes do anúncio de 2019. A segunda é que mais páginas paginadas sempre significam mais orçamento de rastreamento gasto, quando uma série enxuta e bem linkada de páginas autocanonicalizadas é barata para o Google rastrear e o desperdício real vem do excesso de parâmetros e de canonicals quebradas. A terceira é que a rolagem infinita é automaticamente pior para o SEO do que a paginação numerada, quando o que realmente determina é se existem URLs rastreáveis por baixo da rolagem. A quarta é que aplicar noindex em páginas profundas é um padrão seguro e conservador, quando isso geralmente remove em silêncio conteúdo que o Google indexaria sem problema. Cada mito vem da mesma causa raiz, que é tratar a paginação como um problema resolvido em 2015, em vez de verificar o que acontece no rastreamento de hoje.
Como decidir se a paginação precisa ser corrigida agora
Nem todo problema de paginação é urgente. Um fórum com links next/prev limpos e canonicals corretas não precisa de atenção só porque este guia existe. A paginação merece revisão imediata quando qualquer um dos itens a seguir for verdadeiro:
- Uma grande parte do seu catálogo ou arquivo está a duas ou mais páginas de profundidade.
- Suas tags canonical foram configuradas antes de 2019 e não foram revisitadas desde a descontinuação do rel=next/prev.
- Seu site adicionou recentemente rolagem infinita ou um botão de "carregar mais" sem que ninguém verificasse o que aconteceu com as URLs subjacentes.
- O Search Console mostra um número crescente de URLs paginadas "duplicate" ou "excluded".
Se qualquer um desses itens corresponde à sua situação, trate a paginação como uma correção prioritária. Quanto antes uma cadeia de canonical quebrada for corrigida, mais rápido as páginas profundas voltam ao índice.
Um checklist rápido de paginação antes do lançamento
Antes de publicar qualquer mudança em um template paginado, passe por uma lista curta de aprovado/reprovado, em vez de confiar na memória. Toda página tem uma canonical autorreferente, confirmada ao ver o código-fonte de três páginas e não só da página 1? O controle "próxima" tem um href real, visível no código-fonte da página com o JavaScript desativado? A página 2 linka de volta para a página 1 e a cadeia se mantém até a última página? As variantes de URL filtradas e ordenadas estão bloqueadas para indexação, em vez de abertas por padrão? O número da página está no caminho ou em um parâmetro de consulta, nunca depois de um #? Um sim para os cinco pega a esmagadora maioria dos erros de paginação antes de irem ao ar, o que é melhor do que encontrá-los três semanas depois em um relatório do Search Console, depois que o dano já está feito.
Perguntas frequentes
O Google ainda usa rel="next" e rel="prev" na paginação?
Não. O Google confirmou em 21 de março de 2019 que havia parado de usar essas tags e que já as ignorava havia algum tempo antes desse anúncio. Agora ele trata cada página paginada como uma página comum e se baseia em links internos e tags canonical. Alguns outros mecanismos de busca ainda podem ler as tags, mas elas não são mais necessárias para o Google.
As páginas paginadas devem receber noindex?
Em geral, não. Aplicar noindex em uma página paginada a remove do índice por completo, o que pode esconder conteúdo único, como produtos, artigos ou posts que existem apenas naquela página específica. Mantenha as páginas paginadas indexáveis, com tags canonical autorreferentes, e reserve o noindex para variantes realmente de pouco valor, como URLs filtradas ou ordenadas.
A rolagem infinita é ruim para o SEO?
A rolagem infinita não é ruim para o SEO por natureza, mas é arriscada sem trabalho extra. Se o conteúdo carrega dinamicamente em uma única URL, sem links rastreáveis por baixo, os mecanismos de busca podem nunca descobrir a maior parte dele. Combinar a rolagem infinita com URLs reais e endereçáveis para cada segmento, e atualizar a barra de endereços conforme o usuário rola, fecha essa lacuna.
Qual é a diferença entre paginação e uma página "ver tudo"?
A paginação divide o conteúdo em várias URLs, enquanto uma página "ver tudo" coloca tudo em uma única URL, muitas vezes com as páginas paginadas canonicalizando para ela. As páginas de ver tudo podem consolidar sinais de ranqueamento, mas exigem uma forte otimização de desempenho, porque uma página lenta, com centenas de itens, pode prejudicar a experiência do usuário e os sinais de velocidade de página mais do que a paginação teria prejudicado.
Quantas páginas paginadas são demais para o SEO?
Não há um limite fixo, mas uma paginação muito profunda (centenas de páginas em uma série) aumenta o orçamento de rastreamento gasto com conteúdo quase duplicado. Técnicas como a paginação por ponto médio mostram links de página como 1, 2, 3 … 9, 10, 11 em vez de todos os números. Isso reduz a profundidade de rastreamento até páginas distantes e mantém a estrutura de links administrável, sem sacrificar o alcance.
Corrigir a paginação começa por enxergar a cadeia inteira
Os problemas de paginação raramente se anunciam. Eles aparecem como páginas que pararam de ser indexadas, categorias que pararam de ranquear e relatórios de rastreamento que ninguém chegou a ler com atenção. A solução raramente é uma reconstrução; com mais frequência, é uma tag canonical apontada para o lado errado, uma tag noindex que não deveria estar lá ou um botão de "próxima página" sem nenhum link real por trás.
Se você quer ver exatamente quais desses erros de paginação o seu próprio site está cometendo, fale com a equipe e receba um relatório de SEO de amostra montado em torno do seu site de verdade.
Recursos / Referências
Fontes
- Pagination Best Practices for Google | Google Search Central
- Pagination
- API Design Basics: Pagination
- Pagination.com - The fastest path from data to documents
Aviso: Este artigo traz informações gerais sobre regras e valores que estavam em vigor na data em que foi escrito, e não aconselhamento financeiro, tributário ou de investimento personalizado. Ele não leva em conta a sua renda, as suas obrigações, a sua tolerância a risco nem os seus objetivos, e taxas e limites mudam. Verifique a situação atual junto à autoridade competente e converse com um consultor habilitado ou um contador qualificado antes de agir.
Sobre o autor
O SearchBlueprint pesquisou, escreveu e avaliou este artigo com o mesmo pipeline de conteúdo que nossos clientes usam nos próprios sites. A nota que aparece na assinatura é a que nosso mecanismo de conteúdo deu a esta página antes de ela ser publicada. Nada aqui passa por revisão manual, e esse é justamente o ponto: é o resultado do produto, publicado onde qualquer pessoa pode conferir.