Pagination-SEO-Fehler, die Ihre Rankings leise versenken
Von Toy Wen Da, Mitgründer · Aktualisiert · 33 Min. Lesezeit
Übersetzt aus dem englischen Original. Auf Englisch lesen
Pagination-SEO-Fehler zeigen sich selten als plötzlicher Absturz. Sie zeigen sich als schleichender Verlust. Jeden Monat werden weniger Seiten indexiert, die Rankings von Kategorieseiten stagnieren, und Crawl-Berichte füllen sich mit URLs, die nie so recht die Aufmerksamkeit bekommen, die sie verdienen. Die Pagination selbst ist nicht das Problem. Das Problem ist die Art, wie die meisten Websites sie umsetzen.
Dieser Leitfaden zeigt genau, wo bei der Pagination etwas schiefgeht und warum das Ihren Rankings schadet. Anschließend erfahren Sie, wie Sie sie so neu aufbauen, dass Suchmaschinen jede Seite der Reihe crawlen, indexieren und ranken können, nicht nur Seite eins.
Was ist Pagination im SEO?
Pagination im SEO bedeutet, eine große Menge an Inhalten auf mehrere URLs aufzuteilen, statt sie auf eine einzige Seite zu pressen. Produktlisten, Artikel, Forenthreads und Suchergebnisse funktionieren alle so. Jede Seite der Reihe bekommt ihre eigene Adresse, meist etwas wie /category/widgets?page=2, und Suchmaschinen crawlen und indexieren sie als eigenständige Seite.
Pagination ist keine neue Idee. Das Wort selbst ist Jahrhunderte älter als Computer. Die Seitenzählung in Büchern wurde erst um 1550 zur gängigen Praxis und löste das ältere System ab, bei dem nur die Vorderseite jedes Blatts nummeriert wurde. Im Web erfüllt die Pagination im Grunde dieselbe Aufgabe: Sie gibt einer langen Abfolge von Inhalten eine navigierbare Ordnung. Sie muss aber nicht nur Leser zufriedenstellen, sondern auch einen Crawler.
Warum es sie gibt
Ohne Pagination müsste eine Website mit 10.000 Produkten alle 10.000 auf einer Seite darstellen oder die meisten hinter JavaScript verstecken. Beides ist schlecht für die Performance und schlecht für die Crawlbarkeit. Googles eigene Search-Central-Dokumentation zu Pagination und inkrementellem Nachladen von Seiten weist darauf hin, dass die Aufteilung großer Ergebnismengen in Seiten die anfängliche Ladegeschwindigkeit verbessert und den Netzwerkverkehr senkt. Das zählt vor allem bei mobilen Verbindungen. Außerdem verringert es die Last im Backend und vermeidet die Ressourcengrenzen von Browser oder Server, die entstehen, wenn extrem lange Listen auf einmal gerendert werden.
Wie Suchmaschinen paginierte Seiten behandeln
An dieser Stelle stolpern viele. Jahrelang behandelten SEOs eine paginierte Reihe als zusammenhängende Einheit, vor allem weil Google ihnen das mit rel="next" und rel="prev" so vorgegeben hatte. So funktioniert es nicht mehr.
Google führte rel="next" und rel="prev" 2011 ein, um gezielt die Beziehung zwischen den Seiten einer Reihe besser zu verstehen. Am 21. März 2019 bestätigte Google dann, dass es die Unterstützung für diese Tags eingestellt hatte und sie schon seit einiger Zeit ignorierte. Die heutige Haltung: Paginierte Seiten sind ganz normale Seiten, Punkt. Die Indexierung hängt von gewöhnlichen Signalen ab, nämlich interner Verlinkung, Canonical-Tags und Inhaltsqualität, nicht von einer speziellen Pagination-Anweisung. Andere Suchmaschinen lesen rel="next"/"prev" möglicherweise noch, Google nicht.
Diese eine Änderung ist der Grund, warum so viele Setups, die in den Jahren 2012–2018 um rel=next/prev herum gebaut wurden, heute still und leise kaputt sind. Wenn Ihre Canonical-Strategie, Ihre Verlinkung und Ihre Indexierungsregeln um rel=next/prev herum entworfen wurden, lohnt sich ein zweiter Blick. Ein technisches SEO-Audit ist der schnellste Weg herauszufinden, ob Ihre paginierten Seiten noch die Signale senden, die Sie erwarten.
Welche Beispiele für Pagination gibt es im SEO?
Pagination taucht überall dort auf, wo eine Website mehr Inhalt hat, als bequem auf einen Bildschirm passt. Die Umsetzung unterscheidet sich je nach Anwendungsfall, das Ziel bleibt aber gleich: Jeder Abschnitt soll crawlbar und indexierbar bleiben.
| Anwendungsfall | Typisches URL-Muster | Was die Pagination schützt |
|---|---|---|
| E-Commerce-Kategorieseiten | /shoes?page=3 |
Sichtbarkeit der Produkte in einem großen Katalog |
| Blog- oder Nachrichtenarchive | /blog/page/4 |
Ältere Artikel bleiben auffindbar |
| Forenthreads | /thread/128?p=5 |
Lange Diskussionen bleiben lesbar und indexierbar |
| Bildergalerien | /gallery/42?page=2 |
Ladezeit bei bildlastigen Seiten |
| Seiten mit Suchergebnissen | /search?q=widgets&page=2 |
Tiefe Ergebnisse bleiben erreichbar |
| Mehrseitige Langform-Artikel | /guide/part-3 |
Scrolllänge und Lesefokus bei sehr langen Ratgebern |
Jeder dieser Fälle hat ein anderes Risikoprofil. Ein Forenthread, der auf 40 Seiten verteilt ist, ist bei solider Verlinkung risikoarm. Ein Produktkatalog, der sich mit fehlerhaften Canonicals über 200 Seiten erstreckt, kann den Großteil Ihres Sortiments leise aus den Suchergebnissen löschen. Diese Variante verdient die meiste Aufmerksamkeit, und auf sie konzentriert sich dieser Leitfaden am stärksten.
Wie wirkt sich Pagination auf SEO aus?
Pagination beeinflusst Crawlbarkeit, Indexierung, Seitengeschwindigkeit und den Fluss von Link Equity durch Ihre Website. Gut umgesetzt, hilft sie bei allen vieren. Schlecht umgesetzt, kann sie Seiten, die Sie eigentlich ranken lassen wollen, leise unterdrücken.
Die Vorteile
Pagination verbessert die Seitengeschwindigkeit, weil sie begrenzt, wie viel Inhalt pro Anfrage geladen wird, und die Seitengeschwindigkeit ist ein bestätigter Ranking-Faktor. Außerdem entsteht eine Spur crawlbarer interner Links, denen Google folgen kann, um Inhalte tief in einem Katalog oder Archiv zu erreichen. Ohne diese Spur können Seiten jenseits des ersten Bildschirms praktisch zu Waisen werden: technisch online, aber nie entdeckt, weil nichts auf sie verlinkt. Unser Leitfaden zur internen Verlinkung behandelt die Erkennung von Waisenseiten ausführlicher, falls Sie vermuten, dass das bei Ihnen schon passiert.
Die Nachteile
Derselbe Mechanismus, der hilft, birgt auch Risiken. Jede paginierte URL ist ein Beinahe-Duplikat ihrer Nachbarn: gleiche Vorlage, gleiche Seitenleiste, gleiche Gesamtstruktur, nur die zehn oder zwanzig Einträge in der Mitte unterscheiden sich. Suchmaschinen brauchen eine Möglichkeit, diese Seiten auseinanderzuhalten, ohne sie als Duplicate Content zu behandeln. Hier kommen Canonical-Tags, eindeutige URLs und konsistente Verlinkung ins Spiel. Machen Sie bei einem davon einen Fehler, erzeugen Sie genau die Verwirrung, die Suchmaschinen vermeiden wollen. Google crawlt URLs, die es im href-Attribut von Anchor-Tags findet, und nichts sonst. Es führt keine „Mehr laden“-Klick-Handler aus und löst in der Regel keine JavaScript-Funktionen aus, die Inhalte ohne echte URL-Änderung aktualisieren. Wenn Ihre Pagination ausschließlich auf JavaScript-Interaktion ohne crawlbares href beruht, werden die Inhalte ab Seite 2 womöglich nie indexiert. Mehr dazu in unserem Beitrag warum Single-Page-Apps bei Google verschwinden. JavaScript-abhängige Navigation ist eines der größten gemeinsamen Risiken von SPA-Websites und stark paginierten Katalogen.
Die Zahlen hinter dem Ranking-Einfluss der Pagination
Die meisten Ratschläge zur Pagination bleiben abstrakt: „Sie beeinflusst die Crawlbarkeit“, „Sie beeinflusst die Seitengeschwindigkeit“. Die tatsächlichen Zahlen sind konkreter, und sie stammen von Google selbst, nicht aus SEO-Folklore.
Beginnen wir mit der Geschwindigkeit. Googles Core-Web-Vitals-Programm legt drei konkrete Schwellenwerte für eine gute Seitenerfahrung fest. Der Largest Contentful Paint, also die Zeit, bis der Hauptinhalt gerendert ist, sollte unter 2,5 Sekunden bleiben. Interaction to Next Paint sollte unter 200 Millisekunden bleiben. Und Cumulative Layout Shift sollte unter 0,1 bleiben. Diese Zahlen stammen direkt aus Googles eigener web.dev-Dokumentation, vom selben Team, das die Core Web Vitals als Ranking-Eingangsgröße pflegt. Eine paginierte Kategorieseite mit 24 Produkten hat bei allen drei Messwerten einen klaren Vorsprung gegenüber demselben Katalog als eine einzige durchgehende Seite mit 400 Produkten. Es gibt weniger HTML zu parsen, weniger Bilder, die beim ersten Laden um Bandbreite konkurrieren, und weniger Layout, das sich verschieben kann, während Inhalte eintreffen. Keiner dieser Schwellenwerte ist ein abstraktes Ziel. Die Search Console berichtet die Core-Web-Vitals-Leistung gruppiert nach ähnlichen URL-Mustern. Eine Website kann also tatsächlich beobachten, wie eine paginierte Reihe von „Verbesserungswürdig“ auf „Gut“ wechselt, sobald Korrekturen Seite für Seite greifen, und zwar im selben Bericht, mit dem auch Indexierungsprobleme diagnostiziert werden.
Das Crawl-Budget ist die andere wissenswerte Zahl, und hier ist Google ungewöhnlich direkt darin, wen es betrifft. Die eigene Dokumentation zum Crawl-Budget stellt klar, dass die meisten Websites sich darüber gar keine Gedanken machen müssen. Es betrifft gezielt sehr große Websites mit URLs, die sich häufig ändern. Das beschreibt weder einen Blog mit ein paar hundert Beiträgen noch einen Shop mit einigen tausend SKUs. Die praktische Schwelle, die die meisten SEOs als Faustregel verwenden und die sich aus Googles Darstellung im Leitfaden ableitet, liegt irgendwo im fünfstelligen URL-Bereich und darüber. Darunter ist das Crawl-Budget selten der Engpass; eine langsame Serverantwort oder ein defekter Link ist viel eher das eigentliche Problem. Darüber wird die Ausuferung der Pagination zu einer der ersten Stellen, die ein Audit lohnen. Das gilt besonders für Websites, auf denen Filter- und Sortierparameter einige tausend Basis-URLs zu Hunderttausenden crawlbaren Kombinationen vervielfachen.
Die beiden Zahlen hängen zusammen. Eine Reihe, die schnell lädt, hält die Core Web Vitals auf jeder Seite im grünen Bereich, nicht nur auf Seite eins. Eine Reihe, die schlank bleibt, ohne ausufernde Filterkombinationen und ohne endlose Duplikatvarianten, richtet das Crawl-Budget auf Seiten, die tatsächlich ranken können. Wenn beides stimmt, ist die Pagination keine Steuer mehr auf Performance und Indexierung, sondern schützt beides.
Mobile Pagination: Tap-Ziele und Reichweite des Daumens
Googles Leitlinien zur mobilen Nutzbarkeit empfehlen Tap-Ziele von mindestens 48x48 CSS-Pixeln mit etwa 8 px Abstand dazwischen. Diese Zahlen stammen direkt aus Googles eigener Dokumentation zu Barrierefreiheit und mobiler UX. Pagination-Steuerungen, die in einer winzigen Reihe von Seitenzahlen zusammengedrängt sind, bestehen diesen Test oft nicht, besonders ab Seite 10, wenn eine zweistellige Zahl in dasselbe Kästchen passen muss, in dem früher eine einstellige stand. Die Lösung ist nicht kompliziert: Halten Sie die Steuerungen „Zurück“ und „Weiter“ groß und gut beabstandet, und kürzen Sie die nummerierte Mitte auf etwas wie 1, 2, 3 … 9, 10, 11 zusammen, statt jede Seitenzahl Kante an Kante auszugeben. Eine Pagination-Leiste, die sich auf dem Handy nur schwer treffsicher antippen lässt, frustriert nicht nur Nutzer. Sie macht die Crawlbarkeit hinfällig, wenn niemand ohne drei Fehltipper auf Seite 4 kommt. Da der meiste kommerzielle Traffic mobil ist, sollten Sie das auf einem echten Handy testen, nicht nur in einem verkleinerten Desktop-Browserfenster, bevor Sie davon ausgehen, dass eine paginierte Reihe so funktioniert, wie es das Design-Mockup nahelegte.
Pagination vs. Infinite Scroll vs. „Mehr laden“
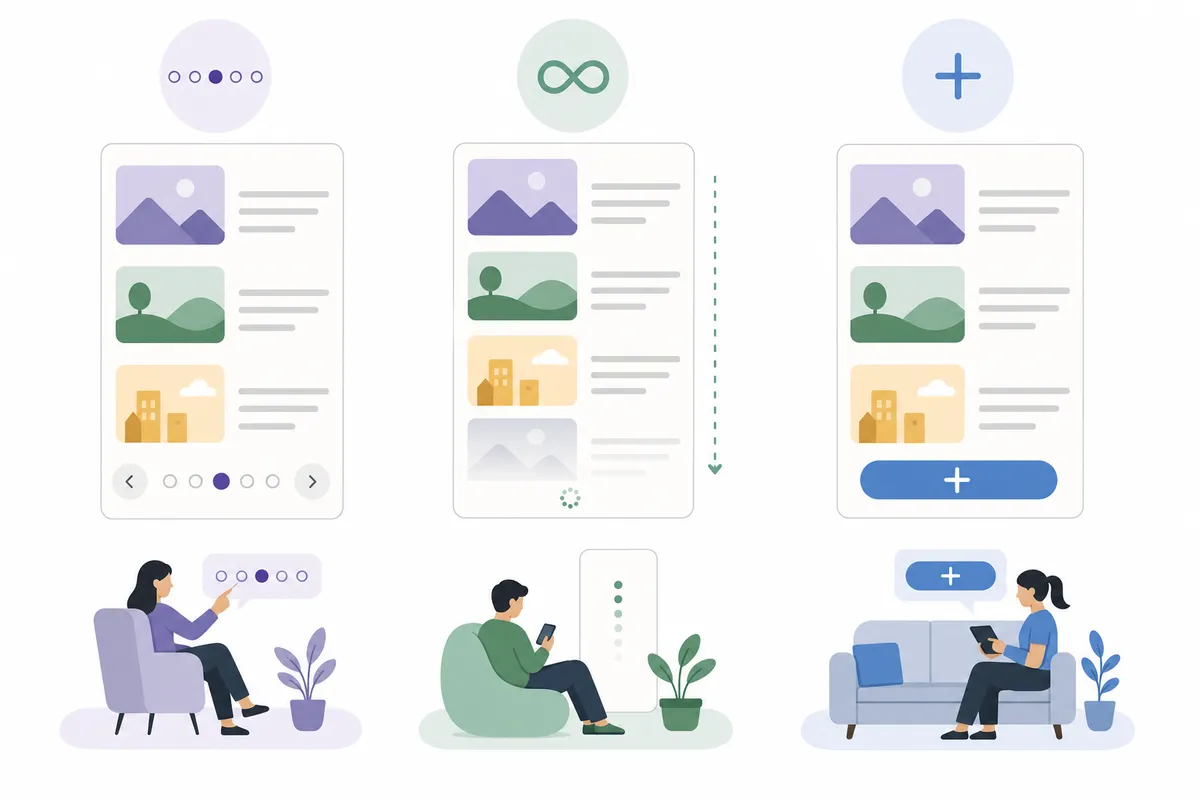
Pagination, Infinite Scroll und „Mehr laden“-Buttons lösen alle dasselbe UX-Problem: zu viel Inhalt für einen Bildschirm. Aber sie lösen es auf unterschiedliche Weise, mit unterschiedlichen Folgen für SEO.
Pagination teilt Inhalte auf getrennte, adressierbare URLs auf. Infinite Scroll lädt beim Herunterscrollen automatisch weitere Inhalte auf einer einzigen URL nach. „Mehr laden“-Buttons liegen dazwischen: ein manueller Klick, der die aktuelle Seite erweitert, ohne zwingend die URL zu ändern. Der Unterschied ist nicht kosmetisch. Er entscheidet darüber, ob ein Crawler Ihre Inhalte überhaupt erreichen kann.
Die drei Muster im Vergleich
| Muster | SEO-Crawlbarkeit | Nutzererlebnis | Am besten geeignet für |
|---|---|---|---|
| Pagination | Stark, jede Seite hat eine eindeutige, crawlbare URL | Klares Gefühl für Fortschritt und Gesamtumfang; leicht, auf einer bestimmten Seite weiterzumachen | Produktkataloge, Archive, alles, was Nutzer vergleichen oder erneut aufrufen müssen |
| Infinite Scroll | Schwach, es sei denn, im Hintergrund gibt es crawlbare URLs | Wirkt kontinuierlich und immersiv; kann bei riesigen Listen „Scroll-Müdigkeit“ auslösen | Social Feeds, Bilderentdeckung, Browsing mit Fokus auf Interaktion |
| Mehr laden | Schwach, Inhalte werden meist per JavaScript in dieselbe URL geladen | Gibt Nutzern ein Gefühl von Kontrolle ohne vollständiges Neuladen der Seite | Listen mittlerer Länge, bei denen vollständiger Infinite Scroll übertrieben wirkt |
Googles eigene Dokumentation benennt den Kompromiss deutlich. Pagination lässt Nutzer die Gesamtlänge einer Liste sehen und erkennen, wo sie sich darin befinden, kostet aber einen zusätzlichen Klick zwischen den Seiten. Infinite Scroll fühlt sich mühelos an, verbirgt aber die Gesamtgröße der Liste und kann es schwer machen, ältere Inhalte wiederzufinden.
Infinite Scroll suchmaschinentauglich machen
Infinite Scroll muss keine SEO-Sackgasse sein, braucht aber Unterstützung. Die Lösung besteht darin, das Scrollverhalten mit echten paginierten URLs im Hintergrund zu kombinieren. Ein Crawler, der direkt /products?page=2 aufruft, sollte denselben Inhalt erhalten, den ein scrollender Nutzer irgendwann sehen würde. Und history.pushState() sollte die Adressleiste beim Scrollen aktualisieren, damit jeder Abschnitt verlinkbar und teilbar bleibt. Fehlt diese Ebene, wird Infinite Scroll zu einer einzigen URL mit Inhalten, die ein Crawler schlicht nie erreicht. Auch die Barrierefreiheit leidet: Infinite Scroll kann Screenreader-Nutzer desorientieren und den Seitenfuß verschütten, was bei klassischer Pagination nicht passiert.
Barrierefreiheitsstandards und Infinite Scroll
Das Problem der Barrierefreiheit ist nicht nur eine Faustregel. Die Web Content Accessibility Guidelines, gepflegt von der W3C Web Accessibility Initiative, stellen zwei einschlägige Anforderungen. Nutzer müssen wahrnehmen können, wo sie sich in einer Menge von Inhalten befinden. Und sie müssen sie allein mit der Tastatur bedienen können, ohne Maus. Infinite Scroll kann beides leise verfehlen. Screenreader-Nutzer, die sich per Tab durch eine Seite bewegen, verlassen sich darauf, den Seitenfuß zu erreichen, um zu wissen, dass die Seite zu Ende ist. Wenn unter ihnen ständig neue Inhalte nachladen, kommt der Seitenfuß nie, und die Seite hat praktisch kein Ende. Nutzer, die nur die Tastatur verwenden, stehen vor einem verwandten Problem: Der Fokus kann unvorhersehbar springen, wenn neue Abschnitte eingebunden werden, und sie landen an einer Stelle der Seite, die sie nicht gewählt haben.
Die praktischen Lösungen sind gut dokumentiert. Kombinieren Sie das Scrollen mit einer sichtbaren „Mehr laden“-Steuerung, die Tastatur- und Screenreader-Nutzer gezielt auslösen können, statt sich auf die Scrollposition zu verlassen. Verwenden Sie eine ARIA-Live-Region mit der Einstellung „polite“, um neue Inhalte beim Laden anzukündigen. So merken Screenreader-Nutzer, dass sich etwas geändert hat, ohne dass ihre Position im Dokument verrissen wird. Und behalten Sie einen echten, erreichbaren Link im Seitenfuß oder eine „Zurück nach oben“-Steuerung, damit die Seite weiterhin ein navigierbares Ende hat. Nichts davon ist exotisch. Es ist dieselbe Latte, die WCAG für jede dynamisch aktualisierte Seite anlegt. Infinite Scroll reißt sie nur häufiger als die meisten Muster, weil der ganze Sinn des Musters in Inhalten liegt, die nie aufhören nachzukommen.
Wenn Pagination nicht die richtige Lösung ist
Pagination hat ihre Berechtigung, wenn eine Liste wirklich lang ist, aber viele Listen sind es nicht. Eine Kategorie mit 18 Produkten braucht keine fünf Seiten mit je vier Artikeln; eine einzige Seite lädt genauso schnell und gibt Google eine starke Seite zum Ranken statt fünf dünner. Die praktische Schwelle, auf die sich die meisten Websites einpendeln, nämlich 40 bis 60 Einträge auf Seite eins, bevor geteilt wird, hält eine einzelne Seite sicher innerhalb der Core-Web-Vitals-Schwellenwerte und vermeidet trotzdem sinnlose Duplizierung. Dieselbe Logik gilt für Langform-Inhalte: Einen Artikel mit 1.200 Wörtern in drei dünne „Teile“ zu zerlegen, vor allem um Seitenaufrufe aufzublähen, schadet ihm meist, da jeder Teil für sich zu kurz ist, um gut zu ranken, und die Teilung die Leser zusätzlich bremst. Eine einzige umfassende Seite mit klaren Überschriften lässt sich außerdem leichter von einem KI-System zusammenfassen oder zitieren als eine Folge kurzer Fragmente. Bevor Sie irgendetwas paginieren, sollten Sie sich fragen, ob die Liste tatsächlich zu lang ist, um sie auf einer Seite gut darzustellen, oder ob sie nur geteilt wurde, damit es geschäftiger aussieht.
Die Pagination-Fehler, die Ihre Rankings leise versenken
Hier entsteht der meiste Schaden. Keiner dieser Fehler sieht im Browser dramatisch aus, die Seiten laden weiterhin, der „Weiter“-Button funktioniert weiterhin. Der Schaden zeigt sich in der Google Search Console und in Crawl-Logs, Wochen später.
Fehler 1: Jede Seite auf Seite 1 canonicalisieren
Das ist der häufigste Pagination-Fehler überhaupt. Ein wohlmeinender Entwickler setzt den Canonical-Tag jeder paginierten URL auf Seite 1, in der Annahme, das „bündele“ die Ranking-Signale. Stattdessen sagt es Google, dass die Seiten 2 bis 50 nicht für sich indexiert werden sollen, sondern Duplikate von Seite 1 sind. Google befolgt diese Anweisung oft und nimmt die Seiten aus dem Index. Wenn Ihr Katalog einzigartige Produkte hat, die nur auf Seite 4 oder Seite 12 stehen, verschwinden diese Produkte praktisch aus der Suche. Jede Seite einer paginierten Reihe sollte einen selbstreferenzierenden Canonical tragen, also einen Tag, der auf sich selbst zeigt, nicht auf Seite 1. Wenn Sie nicht sicher sind, ob Ihre Canonical-Tags tun, was Sie denken, lohnt sich unsere Übersicht zu Canonical-Tag-Fehlern, die Duplicate Content verursachen. Genau dieser Fehler tritt auch außerhalb der Pagination ständig auf.
Fehler 2: Paginierte Seiten auf noindex setzen, „um den Index aufzuräumen“
Manche Teams gehen den umgekehrten Weg: Sie setzen noindex auf jede Seite nach Seite 1. Die Annahme ist, dass dies die Suchergebnisse aufräumt und Autorität auf die Hauptkategorieseite lenkt. Meist geht das nach hinten los. Noindex weist Google an, die Seite ganz aus dem Index zu nehmen. Wenn diese Seite der einzige Ort ist, an dem ein bestimmtes Produkt, ein Artikel oder ein Forenbeitrag steht, taucht dieser Inhalt in der Suche nicht mehr auf, Punkt. Schlimmer noch: Die Kombination eines noindex-Tags mit einem Canonical-Tag auf derselben Seite sendet widersprüchliche Signale. Das eine sagt „Indexiere mich nicht“, das andere „Ich bin die maßgebliche Version dieser URL“. Google muss raten, welchem es vertraut, und das Raten geht nicht immer zu Ihren Gunsten aus.
Fehler 3: Navigationselemente nur mit JavaScript
Wenn Ihr „Nächste Seite“-Element ein <button> mit einem onclick-Handler und ohne echtes href ist, wetten Sie Ihre tiefen Seiten darauf, dass Googlebot Ihr JavaScript einwandfrei ausführt. Das müsste jedes Mal passieren, bei jedem Crawl, ohne Ausnahme. Das ist eine schlechte Wette. Google crawlt die URLs, die es in href-Attributen von Anchor-Tags findet. Es klickt keine Buttons und löst in der Regel auch nicht die Art von interaktionsabhängigen Skripten aus, mit denen viele Front-End-Frameworks neue Inhalte einblenden. Jedes „Weiter“- und „Zurück“-Element sollte ein echter Anchor-Tag sein, der auf eine echte, crawlbare URL zeigt. JavaScript kann das Klickerlebnis trotzdem verbessern, aber der zugrunde liegende Link muss im Markup existieren.
Fehler 4: Filter- und Sortierparameter vervielfachen Ihre URLs
Eine paginierte Kategorieseite ist bereits eine URL, multipliziert mit Dutzenden Seiten. Kommen Filter wie Größe, Farbe, Preis und Marke sowie Sortieroptionen wie Preis aufsteigend, Neueste zuerst und Bestseller hinzu, lassen sich aus einer einzigen Kategorie Tausende fast identischer URL-Kombinationen erzeugen. Suchmaschinen wollen nicht, dass alle indexiert werden; die meisten bringen keinen eigenen Mehrwert und verwässern nur die Crawl-Aufmerksamkeit über nahezu doppelte Inhalte. Die Lösung ist entweder ein noindex-Meta-Tag auf gefilterten/sortierten URL-Varianten oder eine Disallow-Regel in der robots.txt für die betreffenden Parametermuster. In beiden Fällen verschwenden Crawler ihre begrenzte Aufmerksamkeit nicht mehr auf Kombinationen, die ohnehin nie ranken werden. Die Disallow-Syntax der robots.txt ist dabei nicht bloß Konvention. Sie ist inzwischen ein formaler IETF-Standard, RFC 9309, und das ist gut zu wissen, falls ein Entwickler je bezweifelt, ob eine Disallow-Regel von den großen Crawlern zuverlässig beachtet wird.
Fehler 5: URL-Fragmente statt echter Pfade verwenden
Manche Pagination-Umsetzungen verwenden einen Fragmentbezeichner, also den Teil einer URL nach einem #, um die Seitenzahl darzustellen, etwa /products#page2. Google ignoriert bei der Bewertung einer URL alles nach einem #. Wenn der einzige Unterschied zwischen zwei URLs der Text nach dem # ist, behandelt Googlebot sie womöglich als dieselbe, bereits abgerufene Seite. Er crawlt möglicherweise gar nicht erst, was er für ein Duplikat hält. Seitenzahlen gehören in den Pfad oder in einen echten Query-Parameter, niemals in ein Fragment.
Fehler 6: Jede Seite der Reihe überoptimieren
Es ist verlockend, für jede einzelne paginierte Seite einen eigenen, keywordreichen Titel und eine eigene Meta-Beschreibung zu schreiben, so wie bei wirklich verschiedenen Seiten. Tun Sie es nicht. Wenn Seite 2 einer Kategorie „Laufschuhe“ mit Seite 1 derselben Kategorie um dasselbe Keyword konkurriert, ist das Keyword-Kannibalisierung gegen sich selbst. Die Standardlösung ist, paginierte Seiten ab Seite 1 hinaus zu de-optimieren. Halten Sie Titel und Beschreibungen über die Reihe hinweg ähnlich oder identisch, Google hat bestätigt, dass das bei einer paginierten Folge in Ordnung ist, da es die Beziehung erkennt und entsprechend indexiert. Konzentrieren Sie dann Ihr primäres Keyword-Targeting, Ihre internen Links und die Onpage-Optimierung auf die Hauptkategorieseite.
Fehler 7: Die Linkkette unterbrechen
Dieses Muster beruht auf crawlbaren Verbindungen zwischen den Seiten. Wenn Seite 3 auf Seite 4 verlinkt, aber nichts zurück auf Seite 1, oder wenn die Reihe irgendwo in der Mitte abreißt, fällt es Google schwerer, die Reihe zu verstehen. Es fällt ihm auch schwerer, die Seiten zu erreichen, die am weitesten vom Anfang entfernt sind. Best Practice ist, jede Seite mit der nächsten in der Reihe zu verlinken und jede Seite zurück auf Seite 1. Das signalisiert Google, dass Seite 1 der natürliche Einstiegspunkt der Reihe ist. Das ist im Grunde nur ein Spezialfall eines viel breiteren Problems: Seiten, die zwar existieren, aber nicht gut mit dem Rest der Website verbunden sind. Unser ausführlicherer Beitrag zu Fehlern in der Seitenstruktur, die Rankings kosten, behandelt dasselbe Fehlermuster außerhalb der Pagination.
Fehler 8: Infinite Scroll als Abkürzung bei der Crawlbarkeit behandeln
Infinite Scroll wirkt modern und verbessert bei Content-Feeds tatsächlich die Interaktionskennzahlen. Wer aber die seitenweise Navigation durch Infinite Scroll ersetzt, ohne darunter crawlbare URLs zu ergänzen, liefert eine der häufigsten SEO-Geschichten nach dem Muster „Wir haben die Website neu gestaltet und der Traffic ist eingebrochen“. Wenn ein Crawler unter der Basis-URL nur den ersten Schwung an Einträgen sieht und alles andere beim Scrollen ohne passende Linkstruktur nachlädt, ist alles nach diesem ersten Schwung für Suchmaschinen praktisch unsichtbar. Nutzer sehen weiterhin alles; nur Google kann es nicht.
Fehler 9: Das Crawl-Budget bei sehr großen Katalogen ignorieren
Bei einer Website mit ein paar hundert Seiten spielt das Crawl-Budget kaum eine Rolle. Bei einer Website mit Zehntausenden paginierten Produkt- oder Archivseiten spielt es eine große Rolle. Jede dünne, nahezu doppelte paginierte URL, die Google crawlt, ist Aufmerksamkeit, die es nicht auf Ihre wertvolleren Seiten verwendet. Übermäßiges, schlecht beschnittenes Wuchern von Seiten, besonders in Kombination mit unkontrollierten Filter- und Sortierparametern, kann messbar verlangsamen, wie schnell neue oder aktualisierte Inhalte anderswo auf der Website erfasst werden. Wenn Seiten wochenlang unindexiert bleiben, ist ausufernde Pagination eine häufige Ursache; unser Leitfaden dazu, warum Seiten bei der Indexierung übersprungen werden, zeigt, wie Sie das diagnostizieren. Googles eigene Dokumentation zum Crawl-Budget sagt direkt, für wen das gilt. Websites ohne eine große Zahl sich häufig ändernder URLs müssen sich darüber in der Regel gar keine Sorgen machen. Genau deshalb braucht ein kleiner Blog diesen Leitfaden selten, ein Katalog mit 200.000 SKUs dagegen schon.
So strukturieren Sie die Pagination, damit sie den Rankings wirklich hilft
Pagination zu reparieren ist nicht kompliziert, wenn man die Checkliste kennt. Das meiste läuft darauf hinaus, einen der neun oben genannten Fehler konsequent über die gesamte Reihe hinweg rückgängig zu machen.
1. Jede Seite selbst canonicalisieren
Jede paginierte URL sollte einen Canonical-Tag tragen, der auf sich selbst zeigt: der Canonical von Seite 2 zeigt auf Seite 2, der von Seite 3 auf Seite 3 und so weiter. Lassen Sie niemals die ganze Reihe auf Seite 1 zurückzeigen. Diese eine Änderung behebt den schädlichsten Fehler dieser Liste.
2. Klare, aussagekräftige, crawlbare URLs verwenden
Geben Sie jeder Seite der Reihe eine eigene echte URL, erreichbar über einen normalen href-Link, etwa /category?page=2 oder /category/page/2, und keinen per JavaScript ausgelösten Inhaltswechsel unter einer einzigen Adresse. Klare, einheitliche URL-Muster erleichtern es zudem erheblich, eine paginierte Reihe später in großem Umfang zu prüfen.
3. Keine Fragmentbezeichner für Seitenzahlen
Halten Sie die Seitenzahl im Pfad oder als echten Query-Parameter. Verlassen Sie sich nie auf ein #-Fragment, um eine Seite von der anderen zu unterscheiden, denn Google ignoriert diesen Teil der URL vollständig.
4. Seiten nach Seite 1 de-optimieren
Lassen Sie die Hauptseite Ihr primäres Keyword-Targeting, Ihre stärksten internen Links und Ihren besten Onpage-Text tragen. Seite 2 und alle weiteren können ähnliche Titel und Meta-Beschreibungen teilen; das ist bei einer paginierten Reihe erwartetes Verhalten und keine Duplicate-Content-Strafe, die nur darauf wartet, zu passieren.
5. Paginierte Seiten indexierbar halten
Widerstehen Sie dem Drang, Seiten nach Seite 1 „sicherheitshalber“ auf noindex zu setzen. Solange eine Seite nicht wirklich wenig wertvoll ist (zum Beispiel eine gefilterte/sortierte Variante), lassen Sie sie indexierbar, damit einzigartige Inhalte darauf weiterhin gefunden werden können.
6. Seiten der Reihe nach verlinken und zurück auf Seite 1
Jede Seite sollte vorwärts auf die nächste Seite verlinken, und jede Seite sollte zurück auf Seite 1 verlinken. Das gibt Google einen sauberen, einheitlichen Pfad durch die ganze Reihe und bekräftigt, welche Seite der Reihe die meiste Autorität verdient.
7. Wildwuchs bei Filter- und Sortierparametern kontrollieren
Entscheiden Sie vorab, welche Parameterkombinationen indexiert werden sollen (meist: keine) und sperren Sie den Rest mit noindex oder robots.txt-Regeln. So bleibt das Crawl-Budget auf Seiten konzentriert, die tatsächlich ranken können.
8. Crawlern und Nutzern mit Preload und Prefetch helfen
Googles Dokumentation empfiehlt ausdrücklich, die nächste Seite einer Reihe per Preload, Preconnect oder Prefetch vorzuladen. Das beschleunigt das Erlebnis für Nutzer, die sich durch die Reihe bewegen, ein Performance-Detail, das zugleich das Seitengeschwindigkeitssignal stützt, das die Pagination teilweise schützen soll.
9. Die gesamte Kette mit einem technischen Audit prüfen
Pagination berührt Canonical-Tags, interne Verlinkung, Indexierungsanweisungen und Crawl-Pfade gleichzeitig. Deshalb ist es so leicht, ein Teil richtig und ein anderes falsch zu machen, ohne es zu merken. Ein vollständiges technisches SEO-Audit prüft alle vier zusammen statt eines isoliert, und es lohnt sich in der Regel, vor und nach jeder größeren Änderung an der Pagination eines durchzuführen.
Hreflang und Pagination bei mehrsprachigen Websites
Websites mit mehreren Sprachversionen desselben paginierten Katalogs fügen eine Ebene hinzu, die die meisten Pagination-Ratschläge komplett auslassen. Jede paginierte URL braucht ihr eigenes Hreflang-Set, nicht nur Seite 1. Das heißt, Seite 3 des englischen Katalogs sollte auf Seite 3 der französischen und deutschen Version zeigen, nicht auf deren jeweilige Seite 1. Der häufige Fehler ist, Hreflang als reine Einstellung für Seite 1 zu behandeln und es auf jeder weiteren Seite stillschweigend wegfallen zu lassen. Dann rät Google bei den Seiten 2 bis 40 in jedem Markt, welche Sprachzuordnung die richtige ist. Fehlendes Hreflang auf tiefen Pagination-Seiten ist genauso schädlich wie ein fehlender Canonical, es teilt Suchmaschinen leise mit, dass die Beziehung zwischen den Sprachversionen nach der ersten Seite endet, obwohl der Katalog offensichtlich weitergeht. Jede Website mit internationaler Pagination sollte das bei einem Audit gezielt prüfen, statt anzunehmen, das CMS habe es automatisch durchgereicht, denn viele Vorlagen behandeln Hreflang und Pagination als zwei voneinander unabhängige Einstellungen, die nie zusammen getestet wurden.
Ein Praxisbeispiel: Die Pagination einer Kategorie mit 40 Seiten neu aufbauen
Abstrakten Rat kann man leicht zustimmen und schwer umsetzen. So sieht es konkret aus, eine echte paginierte Kategorieseite Schritt für Schritt zu reparieren, am Beispiel eines hypothetischen Shops mit einer Kategorie „Running Shoes“, die sich über 40 Seiten mit je 20 Produkten erstreckt, insgesamt 800 Produkte.
Schritt 1: Herausfinden, was tatsächlich kaputt ist
Bevor Sie Code anfassen, holen Sie sich von fünf Stichprobenseiten den Canonical-Tag, den Meta-Robots-Tag und das href des „Weiter“-Links: Seite 1, Seite 2, Seite 10, Seite 25 und Seite 40. In diesem Beispiel tragen die Seiten 2 bis 40 alle:
<link rel="canonical" href="https://example.com/running-shoes" />
Das ist der häufigste Fehler dieser Liste: Jede Seite nach Seite 1 lässt ihren Canonical auf die Hauptkategorie zurückzeigen. Google wird damit praktisch mitgeteilt, dass die Seiten 2 bis 40 als eigenständige Einheiten gar nicht existieren.
Schritt 2: Die Canonical-Richtung korrigieren
Die Lösung ist eine einzeilige Änderung an der Vorlage, die sitewide statt seitenweise erfolgt. Der Canonical von Seite 2 sollte lauten:
<link rel="canonical" href="https://example.com/running-shoes?page=2" />
Und so weiter bis Seite 40, jede Seite zeigt auf sich selbst. Auf den meisten CMS-Plattformen ist das eine einzelne Bedingung in der Kategorievorlage, keine vierzig manuellen Änderungen. Genau deshalb ist der Fehler so verbreitet: Wer die Vorlage geschrieben hat, hat die Logik einmal verkehrt herum gebaut, und sie wurde von da an still und leise auf jede Seite in jeder Kategorie der gesamten Website angewendet.
Schritt 3: Die Linkkette prüfen
Mit korrigierten Canonicals bestätigen Sie, dass Seite 2 auf Seite 3 verlinkt, Seite 3 auf Seite 4 und so weiter bis Seite 40, und dass jede Seite außerdem zurück auf Seite 1 verlinkt. Ein Crawl mit einem Tool wie Screaming Frog, gefiltert auf dieses URL-Muster, sollte eine durchgehende Kette ohne Lücken zeigen. In diesem Beispiel reißt die Kette bei Seite 23: Ein Fehler in der Paging-Komponente lässt den „Weiter“-Link komplett wegfallen, sobald die Seitenzahl nach 20 zweistellig wird. Das sollten Sie abfangen, bevor Sie die Korrektur für abgeschlossen erklären; ein korrigierter Canonical nützt nichts, wenn der Crawler die Seite, deren Canonical Sie gerade repariert haben, nie erreichen kann.
Schritt 4: Alles nach Seite 1 de-optimieren
Der Titel von Seite 1, „Running Shoes | 800+ Styles, Free Shipping | Example Shop“, bleibt unangetastet; sie ist die Seite mit dem primären Keyword-Ziel. Die Seiten 2 bis 40 erhalten einen nahezu identischen Titel mit angehängter Seitenzahl, etwa „Running Shoes | Page 3 | Example Shop“. Das ist besser als vierzig individuell geschriebene Titel, die mit Seite 1 um dieselben Suchbegriffe konkurrieren. Google hat bestätigt, dass diese Duplizierung über eine paginierte Reihe hinweg erwartet wird und in Ordnung ist; Selbstkonkurrenz entsteht durch vierzig einzigartige Titel, die ein Keyword jagen, nicht durch vierzig ähnliche.
Schritt 5: Erneut crawlen und neu einreichen
Sobald die Änderungen an der Vorlage live sind, reichen Sie die aktualisierte Kategorie-URL über das URL-Prüftool der Search Console ein, um einen schnelleren erneuten Crawl von Seite 1 anzustoßen, und lassen Sie den Rest der Reihe über das normale Crawling mithilfe der nun reparierten internen Links nachziehen. Reichen Sie nicht alle 40 URLs manuell ein; dafür gibt es die Linkkette aus Schritt 3.
Schritt 6: Den Indexierungsbericht zur Bestätigung beobachten
Warten Sie zwei bis vier Wochen und gehen Sie dann zurück zum Bericht „Seitenindexierung“ (Page Indexing) der Search Console und filtern Sie nach dem URL-Muster der Kategorie. Seiten, die zuvor mit „Duplikat – vom Nutzer nicht als kanonisch festgelegt“ (Duplicate without user-selected canonical) markiert waren, sollten allmählich zu „Indexiert“ (Indexed) wechseln. Das geschieht Stapel für Stapel statt auf einmal, weil Google Seiten je nach ihrer bisherigen Änderungshäufigkeit unterschiedlich schnell neu crawlt. Eine Seite an Position 35 der Reihe, die selten gecrawlt wird, weil sich auf ihr kaum etwas ändert, braucht womöglich spürbar länger als Seite 2. Das ist zu erwarten und kein Zeichen, dass die Korrektur gescheitert ist.
Was sich geändert hat
Drei Korrekturen auf Vorlagenebene, nämlich die Canonical-Richtung, ein defekter Link in der Kette und doppelte Titel, ersetzen, was sonst vierzig einzelne manuelle Korrekturen wären. Dieses Verhältnis ist das eigentliche Argument dafür, Pagination auf Vorlagenebene zu reparieren: Ein einziger Logikfehler hat das Problem im gesamten Katalog erzeugt, und eine einzige korrigierte Vorlage beseitigt es auf dieselbe Weise.
Pagination ist nicht nur eine Front-End-Entscheidung: API-Pagination
Die meisten SEO-Gespräche über Pagination drehen sich um die Seite, die Sie im Browser sehen. Läuft Ihre Website aber auf einem Headless-CMS, einem individuellen Storefront oder irgendetwas, das Produkt- und Inhaltsdaten aus einer API bezieht, kann die Pagination-Methode Ihres Backends mitbestimmen, was das Front-End Crawlern überhaupt zeigen kann.
Der Entwickler Phil Sturgeon formulierte es in einem viel gelesenen Beitrag über API-Pagination so: „pagination is basically breaking down a large dataset into smaller chunks, which can be fetched incrementally by a client.“ Die drei gängigen Ansätze bringen jeweils echte Kompromisse mit sich.
| Methode | So funktioniert sie | Am stärksten für | Schwachpunkt |
|---|---|---|---|
| Seitenbasiert | Der Client fragt page=2&size=10 an; der Server liefert diese Seite plus die Gesamtzahl der Seiten |
Einfache UIs mit nummerierten Seitenlinks | Das Zählen des gesamten Datensatzes wird mit dessen Wachstum langsamer |
| Offset-basiert | Der Client fragt offset=10&limit=10 an; der Server überspringt Einträge und liefert den nächsten Block |
Einfache Backends, SQL-Abfragen mit LIMIT/OFFSET |
Die Performance bricht bei hohen Offsets in großen Tabellen stark ein |
| Cursor-basiert | Der Client sendet einen undurchsichtigen Cursor (oft eine kodierte Datensatz-ID), der markiert, wo die letzte Seite endete | Sehr große, sich häufig ändernde Datensätze | Daraus lässt sich nur schwer direkt eine UI im Stil „Seite 1, 2, 3 … 10“ bauen |
Die praktische Erkenntnis für SEO: Wenn Ihr Backend aus Performance-Gründen Cursor-basierte Pagination nutzt, achten Sie darauf, dass das Front-End weiterhin stabile, crawlbare, als Lesezeichen speicherbare URLs für jede Seite erzeugt. Geben Sie sich nicht mit einem undurchsichtigen API-Cursor zufrieden, der sich bei jeder Aktualisierung des Datensatzes ändert. Uneinheitliche URLs über mehrere Crawls hinweg machen es Google viel schwerer, „Seite 2 heute“ als dieselbe Seite zu erkennen, die es letzte Woche indexiert hat.
Das ist wichtiger als früher, denn Seiten werden zunehmend nicht nur von Browsern und Crawlern gelesen, sondern auch von KI-Systemen, die Inhalte zusammenfassen oder zitieren. Eine paginierte Reihe mit instabilen URLs verwirrt diese Systeme genauso wie Googlebot. Wenn das für Ihren Katalog oder Ihr Inhaltsarchiv eine Priorität ist, zeigt unsere Seite zur Generative Engine Optimization, wie strukturelle Konsistenz allgemein in die KI-gestützte Auffindbarkeit einfließt.
Sollten paginierte Reihen strukturierte Daten tragen?
Strukturierte Daten reparieren keinen fehlerhaften Canonical und keinen fehlenden Link, beantworten aber eine Frage, die der Rest dieses Leitfadens offenlässt: Sollte eine paginierte Reihe Suchmaschinen ausdrücklich mitteilen, wie die gesamte Sammlung aussieht, und nicht nur, was auf der aktuellen Seite steht?
Schema.org, das Vokabular für strukturierte Daten, das gemeinsam von Google, Microsoft, Yahoo und Yandex gepflegt wird, definiert für genau diese Situation einen Typ ItemList: eine Menge von Elementen mit einer festgelegten Reihenfolge. Er beschreibt eine paginierte Reihe als eine einzige logische Liste statt als vierzig unzusammenhängende Seiten. Eine minimale Umsetzung auf Seite 3 einer Kategorie mit 40 Seiten könnte so aussehen:
{
  "@context": "https://schema.org",
  "@type": "ItemList",
  "itemListElement": [
    { "@type": "ListItem", "position": 41, "url": "https://example.com/products/trail-runner-x1" },
    { "@type": "ListItem", "position": 42, "url": "https://example.com/products/trail-runner-x2" }
  ]
}
Die position-Werte laufen über die gesamte Reihe weiter, statt auf jeder Seite neu zu beginnen. Die Einträge 41 und 42 etwa stehen bei 20 Einträgen pro Seite auf Seite 3 der Reihe. So kann jeder, der dieses Markup auswertet, verstehen, wo eine bestimmte Seite innerhalb der gesamten Sammlung sitzt.
Ist das nötig? Nein. Google braucht kein ItemList-Markup, um eine paginierte Reihe richtig zu verstehen oder zu indexieren. Die Canonical-Tags und internen Links, die weiter oben in diesem Leitfaden behandelt wurden, erledigen diese Aufgabe von allein. Was ItemList hinzufügt, ist eine sauberere, maschinenlesbare Beschreibung der Sammlung für jedes System, das strukturierte Daten auswertet. Dazu zählen die Answer Engines, die zunehmend das Markup einer Seite lesen statt nur ihren gerenderten Text. Ein Produktkatalog, der seine paginierte Reihe mit ItemList auszeichnet, gibt diesen Systemen eine explizite, geordnete Sicht: „Das sind die Einträge 41 bis 60 einer Liste mit 800.“ Das ist besser, als sie zu zwingen, die Struktur aus vierzig getrennten HTML-Dokumenten abzuleiten. Für Websites, die in Sichtbarkeit jenseits der klassischen Suchergebnisse investieren, ist das eine sinnvolle, günstige Ergänzung, sobald die Grundlagen bei Canonical und Verlinkung bereits stehen, kein Ersatz dafür.
Die Reihenfolge der Schritte ist hier entscheidend. Einen verkehrten Canonical auf einer Reihe mit 40 Seiten zu korrigieren, lohnt sich diese Woche. ItemList-Markup für dieselbe Reihe zu ergänzen, lohnt sich irgendwann, wenn die Grundlagen halten, nicht statt ihrer.
Tools zur Prüfung der Pagination in großem Umfang
Die Pagination von Hand zu prüfen, funktioniert bei einem Forenthread mit fünf Seiten; bei einem Katalog mit 40.000 SKUs skaliert es nicht. Screaming Frog ist der häufigste Ausgangspunkt: Die kostenlose Version crawlt bis zu 500 URLs, und eine kostenpflichtige Lizenz hebt diese Grenze auf und ergänzt die benutzerdefinierte Extraktion, mit der sich Canonical-Tags und href-Werte von jeder paginierten Seite in einem Durchlauf auslesen lassen. Sitebulb baut auf derselben Idee auf und bietet eine visuelle Crawl-Karte, auf der sich eine unterbrochene Linkkette leichter erkennen lässt als beim Scrollen durch eine Tabelle. JetOctopus und ContentKing überwachen das Crawl-Verhalten kontinuierlich statt in einer einzelnen Momentaufnahme, was hier besonders wichtig ist, da ein Fehler in der Vorlage Monate nach der ursprünglichen Korrektur still und leise einen defekten Canonical wieder einführen kann. Keines dieser Tools ersetzt den Bericht „Seitenindexierung“ der Google Search Console, das einzige Tool, das zeigt, wie Google jede paginierte URL gerade tatsächlich behandelt. Aber ein Crawler liefert das „Warum“ hinter dem, was die Search Console als Symptom meldet. Beide zusammen einzusetzen, ein Crawl plus Search Console, deckt Probleme auf, die keines der beiden Tools allein sauber zeigt.
Pagination-Probleme prüfen und beheben
Ein Pagination-Problem zu finden, kostet meist weniger Aufwand, als man denkt, die Signale sind einheitlich, sobald man weiß, worauf man achten muss.
Was Sie zuerst prüfen sollten
Beginnen Sie mit dem Bericht „Seitenindexierung“ der Google Search Console. Suchen Sie nach paginierten URLs, die mit „Duplikat – vom Nutzer nicht als kanonisch festgelegt“ (Duplicate without user-selected canonical) oder „Alternative Seite mit richtigem kanonischen Tag“ (Alternate page with proper canonical tag) markiert sind. Beides sind deutliche Hinweise darauf, dass Ihre Canonical-Strategie in die falsche Richtung zeigt. Crawlen Sie dann die Website direkt mit einem Tool wie Screaming Frog und filtern Sie nach paginierten URL-Mustern. Prüfen Sie, was der Canonical-Tag und der Meta-Robots-Tag jeder Seite tatsächlich aussagen, im Vergleich zu dem, was Sie erwarten.
| Prüfung | Wo nachsehen | Woran man ein Problem erkennt |
|---|---|---|
| Canonical-Richtung | Seitenquelltext, <link rel="canonical"> |
Seiten ab 2 canonicalisieren auf Seite 1 statt auf sich selbst |
| Indexierungsstatus | Google Search Console → Seitenindexierung | Paginierte URLs sind als Duplikat oder ausgeschlossen markiert |
| Erreichbarkeit der Links | Website-Crawl (Screaming Frog, JetOctopus usw.) | „Weiter“-Links ohne href oder nur in JS vorhanden |
| Parameter-Wildwuchs | Crawl-Bericht, Anzahl der URL-Parameter | Hunderte Filter-/Sortierkombinationen werden gecrawlt |
| Verwendung von Fragmenten | Prüfung der URL-Struktur | Seitenzahlen erscheinen nach einem # |
Beheben, was Sie finden
Sobald Sie wissen, welcher Fehler vorliegt, ist die Lösung fast immer eine der neun oben genannten Korrekturen. Die Canonical-Richtung umdrehen, ein unnötiges noindex entfernen, eine reine JS-Steuerung durch einen echten Link ersetzen oder die Robots-Regeln für Parametervarianten straffen. Der schwierigere Teil ist meist die Priorisierung. Bei einem Katalog mit Tausenden paginierter URLs bringt die sitewide Korrektur der Canonical-Richtung in der Regel die größte und schnellste Erholung, weil sie jede Seite in jeder Reihe auf einmal betrifft. Ein umfassenderer Leitfaden zu technischen SEO-Fixes ist eine gute nächste Lektüre, falls sich die Pagination als ein Symptom eines größeren Problems mit Crawl-Budget oder Indexierung Ihrer Website herausstellt.
Wie lange die Erholung nach einer Pagination-Korrektur dauert
Diese Frage übergehen die meisten Leitfäden, und es ist genau die, die Leute beantwortet haben wollen: Wie lange dauert es nach der Korrektur eines fehlerhaften Canonicals oder eines noindex-Tags, bis die Seiten zurückkommen?
Es gibt keine feste Zahl, und Googles eigene Dokumentation zu Crawling und Indexierung tut auch nicht so. Sie beschreibt den Zeitpunkt des erneuten Crawls als abhängig von der Crawl-Nachfrage, davon, für wie wichtig Google eine URL hält, und davon, wie oft sie sich bisher geändert hat, nicht als garantierten Zeitplan. Dennoch gilt bei den meisten Websites, die eine sitewide Pagination-Korrektur durchführen, ein grobes Muster.
Seite 1 und stark besuchte Kategorieseiten werden typischerweise innerhalb von Tagen erneut gecrawlt, da Google diese ohnehin häufig besucht. Wenn Sie die URL über das URL-Prüftool der Search Console einreichen, kann sich das auf ein bis zwei Tage verkürzen.
Seiten aus der Mitte der Reihe (etwa die Seiten 2 bis 10) folgen in der Regel innerhalb von ein bis drei Wochen, erfasst durch den normalen Crawl der nun korrigierten internen Linkkette statt durch manuelles Einreichen.
Seiten tief in der Reihe (Seite 20 und weiter) können einen Monat oder länger brauchen, besonders bei Websites, die Google insgesamt seltener crawlt. Diese Seiten hatten schon vor der Korrektur die geringste Crawl-Priorität. Ein korrigierter Canonical hebt diese Priorität nicht automatisch an, er beseitigt nur die aktive Barriere, die sie draußen gehalten hat.
Die vollständige Erholung der Rankings, im Unterschied zur bloßen Neuindexierung, hinkt der Neuindexierung in der Regel noch einige Wochen hinterher. Eine Seite kann in den Index zurückkehren und trotzdem Zeit brauchen, bis sie die Rankings zurückgewinnt, die sie vorher hatte. Der Grund: Google bewertet auch neu, wie diese Seite in die aktuelle Version der Website passt, und stellt nicht einfach ein zwischengespeichertes Ranking von vor dem Fehler wieder her.
Einiges beschleunigt das: eine saubere, ununterbrochene interne Linkkette, eine Sitemap, die die korrigierten URLs auflistet, und die allgemeine Autorität der Website. Eine etablierte Website mit häufigen Googlebot-Besuchen erholt sich immer schneller als eine kleinere, die Google wöchentlich crawlt. Einiges bremst es auch: ein großer Katalog, bei dem das fehlerhafte Muster zehntausende URLs auf einmal betraf, oder eine Website, bei der das Crawl-Budget schon vor der Korrektur knapp war.
Die ehrliche Einschränkung: Wenn vier bis sechs Wochen ohne jede Bewegung bei Seite 1 und den am stärksten besuchten Kategorieseiten vergehen, hat die Korrektur wahrscheinlich nicht vollständig gegriffen. Das ist etwas anderes als eine bloß langsame Erholung, und es lohnt sich, erneut zu prüfen, statt länger zu warten.
Pagination auf verschiedenen Plattformen
Die Pagination-Standardeinstellungen unterscheiden sich stark je nach Plattform, und eine Einstellung, die in einem CMS in Ordnung ist, kann in einem anderen zur Belastung werden.
E-Commerce-Plattformen sind der Fall mit dem höchsten Einsatz, da Kategorieseiten oft Hunderte Produkte paginieren und direkt den Umsatz treiben. Wenn Ihr Katalog nach den Best Practices für E-Commerce-SEO läuft, gehören Canonicalisierung der Pagination und Parameterkontrolle weit oben auf die Checkliste. Sie sollten kein Nachgedanke sein, der einmal im Jahr erledigt wird.
Abseits des E-Commerce unterscheiden sich CMS-Plattformen darin, wie viel Kontrolle über die Pagination sie von Haus aus bieten. Manche erzeugen standardmäßig selbstcanonicalisierende paginierte Archivseiten; andere erfordern manuelle Vorlagenänderungen, damit Canonical und Linkstruktur stimmen. Wenn Sie innerhalb der Grenzen einer bestimmten Plattform arbeiten, führen unsere CMS-spezifischen SEO-Leitfäden durch die Einstellungen, auf die es für Ihren Stack ankommt, einschließlich der Stellen, an denen die Pagination-Standards typischerweise angepasst werden müssen.
Ein paar konkrete Beispiele zeigen, wie stark die Standardeinstellungen tatsächlich voneinander abweichen. Die native Pagination von WordPress (/blog/page/2/, erzeugt von der eingebauten Funktion paginate_links()) ist standardmäßig selbstcanonicalisierend. Jedes paginierte Archiv bekommt seinen eigenen Canonical, der auf sich selbst zeigt, und beliebte SEO-Plugins behalten dieses Verhalten in der Regel bei, statt es zu überschreiben. Der übliche WordPress-Fehler liegt nicht im Standard der Plattform, sondern in einem Theme oder Page-Builder-Plugin darüber, das den Canonical stillschweigend auf Seite 1 zurückschreibt.
Die Kollektionsseiten von Shopify werden ab einer festgelegten Produktzahl automatisch paginiert, häufig 36 oder 50, je nach Theme. Shopify erzeugt Canonical-Tags, die jede paginierte Kollektionsseite auf sich selbst zeigen lassen statt auf die erste Seite, ein korrekter Standard. Probleme bekommen Shopify-Shops meist durch Filter- und Sortierparameter, die über Apps oder eigene Filter-Widgets auf die Kollektionen aufgesetzt werden. Diese können große Mengen crawlbarer Parameterkombinationen außerhalb der eigenen Plattform-Standards erzeugen.
WooCommerce, das auf WordPress läuft, erbt die Pagination-Mechanik von WordPress für seine Shop- und Kategoriearchive, sodass im Allgemeinen derselbe selbstcanonicalisierende Standard gilt. Doch WooCommerce-Shops ergänzen häufig Filter-Plugins von Drittanbietern, etwa für Preisspanne, Attribut oder Marke, die dasselbe Problem des Parameter-Wildwuchses mit sich bringen wie bei Shopify-Shops, nur über andere Plugins.
Headless- und individuell entwickelte Storefronts haben überhaupt keinen Standard. Was auch immer das Front-End-Team umsetzt, ist das Verhalten, das Sie bekommen, und deshalb sind Headless-Websites bei Fehlern in der Canonical-Richtung überproportional vertreten. Keine Plattformkonvention schützt sie still im Hintergrund, wie es bei WordPress oder Shopify der Fall ist.
Das Muster über alle hinweg: Die Basisplattform ist selten die Stelle, an der die Pagination bricht. Es ist fast immer ein Theme, Plugin, eine App oder eine individuelle Vorlage darüber, die einen korrekten Standard durch einen falschen überschreibt. Das sollten Sie auf jeder Plattform zuerst prüfen, bevor Sie annehmen, das CMS selbst sei das Problem.
Verbreitete Pagination-Mythen, die in den Ruhestand gehören
Einige Annahmen über Pagination halten sich hartnäckig, lange nachdem sie aufgehört haben, wahr zu sein. Die erste: dass rel="next"/"prev" Google noch hilft, eine Reihe zu verstehen, obwohl Google beide Tags schon vor seiner Ankündigung von 2019 ignoriert hat. Die zweite: dass mehr paginierte Seiten immer mehr verbrauchtes Crawl-Budget bedeuten, obwohl in der Praxis eine schlanke, gut verlinkte Reihe selbstcanonicalisierter Seiten für Google günstig zu crawlen ist. Parameter-Wildwuchs und defekte Canonicals verschwenden Budget, nicht die Seitenzahl allein. Die dritte: dass Infinite Scroll automatisch schlechter für SEO ist als nummerierte Pagination, obwohl entscheidend ist, ob unter dem Scrollen crawlbare URLs existieren, nicht welches Muster ein Designer gewählt hat. Und die vierte: dass noindex auf tiefen Seiten ein sicherer, konservativer Standard ist, obwohl es meist das Gegenteil ist, nämlich ein Weg, Inhalte leise zu entfernen, die Google sonst problemlos indexiert hätte. Jeder dieser Mythen führt auf dieselbe Ursache zurück: Pagination wie ein gelöstes Problem von 2015 zu behandeln, statt zu prüfen, was beim heutigen Crawl tatsächlich passiert.
Woran Sie erkennen, ob die Pagination jetzt repariert werden muss
Nicht jedes Pagination-Problem ist dringend. Ein Forum mit sauberen Next/Prev-Links und korrekten Canonicals braucht keine Aufmerksamkeit, nur weil es diesen Leitfaden gibt. Eine sofortige Prüfung der Pagination ist angebracht, wenn eines der folgenden Dinge zutrifft. Ein großer Teil Ihres Katalogs oder Archivs liegt zwei oder mehr Seiten tief. Ihre Canonical-Tags wurden vor 2019 eingerichtet und seit der Abschaffung von rel=next/prev nicht mehr überprüft. Ihre Website hat kürzlich Infinite Scroll oder einen „Mehr laden“-Button eingeführt, ohne zu prüfen, was mit den zugrunde liegenden URLs passiert. Oder die Search Console zeigt eine wachsende Zahl „doppelter“ oder „ausgeschlossener“ paginierter URLs. Wenn eines davon auf Ihre Situation zutrifft, behandeln Sie die Pagination als vorrangige Korrektur und nicht als Aufgabe für irgendwann. Je früher eine fehlerhafte Canonical-Kette korrigiert wird, desto schneller kommen tiefe Seiten in den Index zurück.
Eine kurze Pagination-Checkliste vor dem Livegang
Bevor Sie eine Änderung an einer paginierten Vorlage ausliefern, gehen Sie eine kurze Liste mit Bestanden/Nicht bestanden durch, statt sich auf Ihr Gedächtnis zu verlassen. Trägt jede Seite einen selbstreferenzierenden Canonical, bestätigt durch einen tatsächlichen Blick in den Quelltext von drei Seiten, nicht nur von Seite 1? Hat das „Weiter“-Element ein echtes href, im Seitenquelltext sichtbar, auch bei deaktiviertem JavaScript? Verlinkt Seite 2 zurück auf Seite 1, und hält die Kette bis zur letzten Seite? Sind gefilterte und sortierte URL-Varianten von der Indexierung ausgeschlossen, statt standardmäßig offen gelassen zu werden? Steht die Seitenzahl im Pfad oder in einem Query-Parameter, niemals nach einem #? Wenn Sie alle fünf Fragen mit Ja beantworten, fangen Sie die überwiegende Mehrheit der Pagination-Fehler ab, bevor sie live gehen, statt sie drei Wochen später in einem Search-Console-Bericht zu finden, wenn der Schaden schon entstanden ist.
Häufig gestellte Fragen
Verwendet Google rel="next" und rel="prev" noch für die Pagination?
Nein. Google bestätigte am 21. März 2019, dass es diese Tags nicht mehr verwendet und sie schon vor dieser Ankündigung eine Zeit lang ignoriert hatte. Es behandelt jede paginierte Seite jetzt als normale Seite und stützt sich stattdessen auf interne Verlinkung und Canonical-Tags. Manche anderen Suchmaschinen lesen die Tags womöglich noch, für Google sind sie aber nicht mehr nötig.
Sollten paginierte Seiten auf noindex gesetzt werden?
In der Regel nein. Eine paginierte Seite auf noindex zu setzen, entfernt sie komplett aus dem Index, wodurch einzigartige Inhalte, Produkte, Artikel, Beiträge, die nur auf dieser einen Seite stehen, verborgen werden können. Halten Sie paginierte Seiten mit selbstreferenzierenden Canonical-Tags indexierbar und reservieren Sie noindex für wirklich minderwertige Varianten wie gefilterte oder sortierte URLs.
Ist Infinite Scroll schlecht für SEO?
Infinite Scroll ist nicht von Natur aus schlecht für SEO, aber ohne zusätzlichen Aufwand riskant. Wenn Inhalte dynamisch auf einer einzigen URL nachgeladen werden, ohne dass darunter crawlbare Links liegen, entdecken Suchmaschinen die meisten davon womöglich nie. Wer Infinite Scroll mit echten, adressierbaren URLs für jeden Abschnitt kombiniert (und die Adressleiste beim Scrollen aktualisiert), schließt diese Lücke.
Was ist der Unterschied zwischen Pagination und einer „Alle anzeigen“-Seite?
Pagination teilt Inhalte auf mehrere URLs auf; eine „Alle anzeigen“-Seite legt alles auf eine URL, oft mit paginierten Seiten, die darauf canonicalisieren. „Alle anzeigen“-Seiten können Ranking-Signale bündeln, brauchen aber eine starke Performance-Optimierung. Eine langsam ladende Seite mit Hunderten von Einträgen kann dem Nutzererlebnis und den Seitengeschwindigkeitssignalen mehr schaden, als es die Pagination getan hätte.
Wie viele paginierte Seiten sind für SEO zu viele?
Es gibt keine feste Grenze, aber sehr tiefe Pagination (Hunderte Seiten in einer Reihe) erhöht das Crawl-Budget, das für nahezu doppelte Inhalte aufgewendet wird. Techniken wie die Mittelpunkt-Pagination zeigen Seitenlinks wie 1, 2, 3 … 9, 10, 11 statt jeder einzelnen Zahl. Das verringert die Crawl-Tiefe zu weit entfernten Seiten und hält die Linkstruktur überschaubar, ohne die Erreichbarkeit zu opfern.
Pagination zu reparieren beginnt damit, die ganze Kette zu sehen
Pagination-Probleme kündigen sich selten an. Sie zeigen sich einfach als Seiten, die nicht mehr indexiert werden, Kategorien, die nicht mehr ranken, und Crawl-Berichte, die niemand genau gelesen hat. Die Lösung ist selten ein Neubau. Meist ist es ein Canonical-Tag, der in die falsche Richtung zeigt, ein noindex-Tag, der nicht dort sein sollte, oder ein „Nächste Seite“-Button ohne echten Link dahinter.
Wenn Sie genau sehen möchten, welche dieser Pagination-Fehler Ihre eigene Website macht, sprechen Sie mit dem Team und erhalten Sie einen exemplarischen SEO-Bericht, der auf Ihrer tatsächlichen Website basiert.
Ressourcen / Referenzen
Quellen
- Pagination Best Practices for Google | Google Search Central
- Pagination
- API Design Basics: Pagination
- Pagination.com - The fastest path from data to documents
Haftungsausschluss: Dieser Artikel enthält allgemeine Informationen zu Regeln und Zahlen, die zum Zeitpunkt der Erstellung galten, und stellt keine persönliche Finanz-, Steuer- oder Anlageberatung dar. Er berücksichtigt weder Ihr Einkommen, Ihre Verpflichtungen, Ihre Risikobereitschaft noch Ihre Ziele, und Zinssätze und Schwellenwerte ändern sich. Prüfen Sie die aktuelle Lage bei der zuständigen Behörde, und sprechen Sie vor jeder Entscheidung mit einer zugelassenen Beratungsperson oder einem qualifizierten Steuerberater bzw. einer qualifizierten Buchhalterin.
Über den Autor
SearchBlueprint hat diesen Artikel mit der Content-Pipeline recherchiert, geschrieben und bewertet, die unsere Kunden auf ihren eigenen Websites einsetzen. Die Bewertung in der Autorenzeile ist die, die unsere Content-Engine dieser Seite vor der Veröffentlichung gegeben hat. Nichts davon wird von Hand geprüft, und genau das ist der Punkt: Es ist das Ergebnis des Produkts, veröffentlicht dort, wo jeder es nachprüfen kann.