Sitemap Could Not Be Read : 7 correctifs qui fonctionnent vraiment
Par Toy Wen Da, Cofondateur · · 6 min de lecture
Traduit de l'original en anglais. Lire en anglais
Si Google Search Console affiche « Sitemap could not be read », cela signifie généralement que le robot de Google n'a pas réussi à récupérer ou à analyser le fichier situé à l'URL que vous avez soumise, à cause d'une URL erronée, d'un blocage côté serveur, d'une erreur de format, ou parfois d'un problème temporaire du côté de Google. Dans la plupart des cas, vous pouvez le corriger en quelques minutes dès que vous savez où regarder.
Ce que signifie vraiment « Sitemap could not be read »
Le rapport Sitemaps de Google Search Console affiche deux états d'erreur très proches : « Couldn't fetch » et celui-ci. Dans les deux cas, Googlebot a essayé de demander votre fichier sitemap et n'a obtenu aucune réponse exploitable, ou une réponse qu'il n'a pas pu analyser comme du XML valide. Ce n'est pas une pénalité, et cela n'affecte pas directement votre classement. Mais cela empêche Google d'utiliser le sitemap comme signal de découverte et de priorité d'exploration, ce qui peut ralentir l'indexation des pages nouvelles ou mises à jour.
Les causes courantes de l'erreur « Could Not Be Read »
La plupart des cas se ramènent à l'une des quelques causes principales. Avant de modifier des réglages, passez l'URL de votre sitemap dans un vérificateur de sitemap gratuit pour voir exactement ce que verrait Googlebot : une URL erronée, une redirection ou un XML cassé apparaît généralement tout de suite.
| Cause | À quoi cela ressemble | Comment le confirmer | Correctif habituel |
|---|---|---|---|
| URL de sitemap soumise incorrecte | Faute de frappe, mauvais sous-domaine ou URL pointant vers le mauvais environnement | Ouvrir l'URL exacte dans une fenêtre de navigation privée | Soumettre à nouveau l'URL complète et correcte |
| Serveur ou pare-feu bloquant Googlebot | Le sitemap s'ouvre pour vous mais pas pour Google | Vérifier dans les journaux du serveur si l'user agent de Googlebot est refusé | Autoriser Googlebot dans les règles du pare-feu ou du CDN |
| robots.txt interdisant le chemin | Répertoire du sitemap bloqué | Chercher dans le robots.txt une règle Disallow couvrant le sitemap | Supprimer le blocage ou déplacer le fichier |
| XML mal formé ou mauvais type de fichier | Caractères en trop, balises fermantes manquantes, HTML renvoyé à la place du XML | Valider avec un vérificateur XML ou de sitemap | Corriger la syntaxe, réexporter, soumettre à nouveau |
| Fichier trop volumineux ou trop d'URL | Le sitemap dépasse 50 Mo non compressé ou 50 000 URL | Vérifier la taille du fichier et le nombre d'URL | Le scinder en plusieurs sitemaps avec un index de sitemaps |
| Problème temporaire côté Google | Le sitemap renvoie 200, est valide, mais affiche quand même l'erreur | Revérifier après 24 à 48 heures | Soumettre à nouveau ; se résout souvent sans aucune modification |
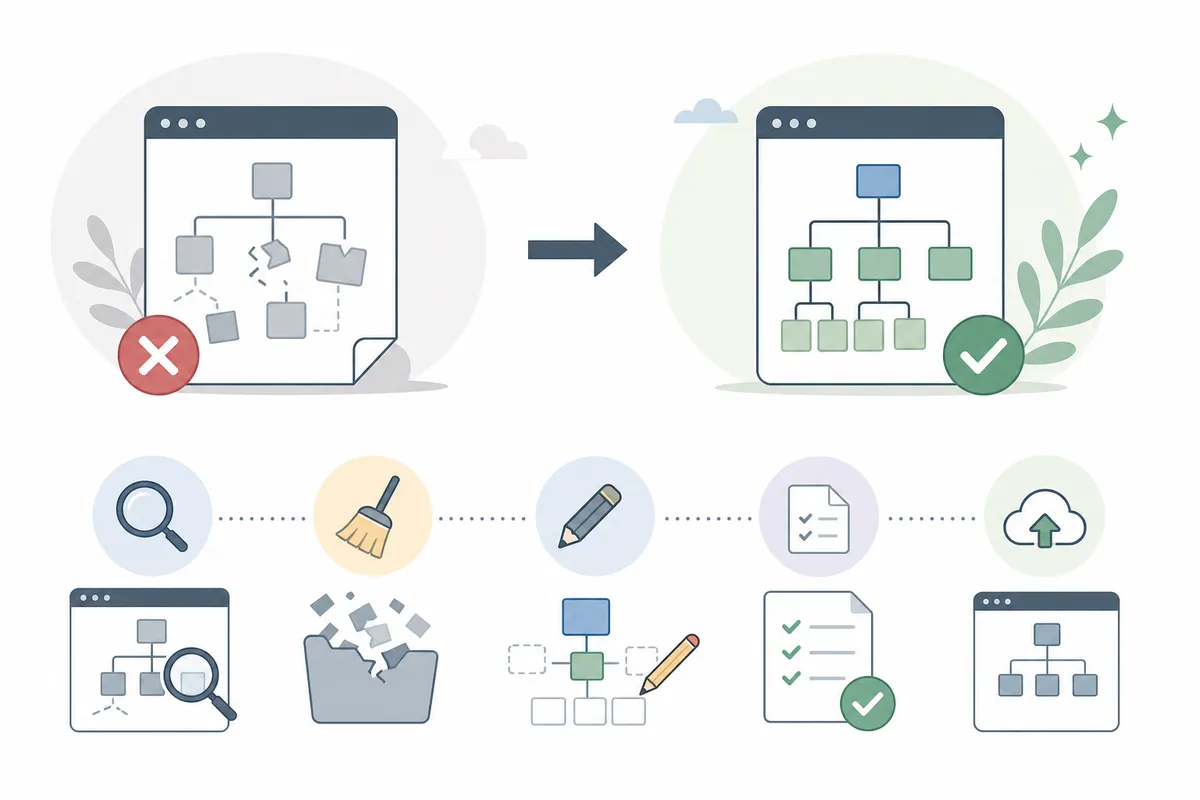
Comment corriger un sitemap qui ne peut pas être lu
Vérifier l'URL et le statut HTTP
Commencez simplement. Collez l'URL du sitemap soumis dans un navigateur. Il doit se charger instantanément et renvoyer du XML propre, pas une page de connexion, une erreur 404 ou une chaîne de redirections. Vérifiez ensuite que le code de réponse du serveur est bien un simple 200 ; un outil comme httpstatus.io ou l'onglet réseau de votre navigateur vous l'indiquera. Une redirection 301 vers une autre URL est une cause fréquente, et souvent négligée : Google ne la suit parfois pas comme vous l'attendez.
Vérifier le robots.txt et les accès du serveur
Si le sitemap s'affiche normalement dans votre navigateur mais reste impossible à récupérer, quelque chose bloque peut-être Googlebot en particulier, et non les visiteurs en général. Ouvrez votre fichier robots.txt et assurez-vous qu'aucune règle n'interdit le dossier du sitemap. Vérifiez aussi si un pare-feu, un service de protection contre les bots ou un mot de passe de préproduction bloque discrètement les robots tout en laissant passer les humains.
Valider la structure du XML
Une seule esperluette non échappée ou une balise non fermée peut rendre illisible pour Google un sitemap qui semble par ailleurs correct. Passez le fichier dans un validateur XML ou un vérificateur propre aux sitemaps, car les validateurs génériques passent parfois à côté de problèmes liés au protocole des sitemaps qu'un outil spécialisé détecte.
Soumettre à nouveau et laisser du temps
Une fois que vous avez confirmé que l'URL, le code de statut et le XML sont corrects, supprimez l'ancienne entrée du sitemap dans Search Console et soumettez-le à nouveau, plutôt que de simplement attendre. La documentation de Google sur l'exploration et l'indexation indique que le traitement d'un sitemap n'est pas instantané, et que le retraitement peut prendre de quelques heures à quelques jours.
Quand c'est une fausse alerte
Si vous cherchez cette erreur, vous verrez que c'est une plainte fréquente : des propriétaires de sites confirment que leur sitemap renvoie un statut 200, passe la validation, et voient pourtant le même message dans le rapport. Un fil de discussion très consulté de la Google Search Central Community décrit exactement cela : un sitemap valide, dont le bon fonctionnement est confirmé, signalé malgré tout comme illisible. Plusieurs marchands Shopify ont signalé le même phénomène pendant des semaines, avec des pages désindexées et des soumissions manuelles d'URL renvoyant « No referring sitemaps detected », même après plusieurs nouvelles soumissions.
Si vous avez réellement confirmé que l'URL, le statut et le XML sont corrects, l'erreur peut venir d'un simple décalage dans les rapports plutôt que d'un vrai problème. Soumettez à nouveau, attendez 48 heures et revérifiez avant de supposer que quelque chose est cassé de votre côté.
Pouvez-vous le corriger vous-même ?
Oui, dans la plupart des cas, vous pouvez corriger cette erreur vous-même. Vérifier une URL, lire un code de statut HTTP et valider du XML ne demandent pas de développeur : un outil de vérification gratuit fait le gros du travail technique. Voici quand il vaut la peine de faire appel à de l'aide : les grands catalogues e-commerce avec des sitemaps générés automatiquement, les configurations multi-CDN où il est difficile de savoir qui bloque Googlebot, ou les cas où l'erreur persiste plus d'une semaine malgré un sitemap propre et confirmé. À ce stade, quelqu'un qui sait lire votre rapport Search Console complet en parallèle des journaux du serveur, et qui sait comment lire un rapport SEO sans simplement deviner, repérera ce qu'il est facile de manquer depuis un seul tableau de bord.
Questions fréquentes
Pourquoi Search Console affiche-t-il « sitemap could not be read » alors que mon sitemap fonctionne parfaitement ?
Cela signifie généralement que votre sitemap renvoie bien un statut 200 et un XML valide, mais que le robot de Google a rencontré un problème temporaire : un délai d'attente dépassé, un user agent bloqué sur une requête, ou un retard de rapport. C'est une plainte récurrente et documentée dans la Google Search Central Community, et une nouvelle soumission après 24 à 48 heures la résout souvent sans aucune modification du fichier.
Cette erreur nuit-elle à mon classement ?
Pas directement. Un sitemap est une aide à la découverte, pas un facteur de classement. Mais s'il reste défaillant, les pages nouvelles ou mises à jour peuvent être explorées et indexées plus lentement, ce qui peut retarder le classement des contenus récents.
Combien de temps Google met-il à récupérer à nouveau un sitemap après sa correction ?
Il n'y a aucune garantie fixe, mais la plupart des sites voient le statut se mettre à jour un à deux jours après avoir soumis à nouveau un sitemap corrigé.
Un fichier robots.txt peut-il provoquer « sitemap could not be read » ?
Oui. Si le robots.txt interdit le dossier où se trouve votre sitemap, ou interdit le fichier sitemap lui-même, Googlebot peut être incapable de le récupérer même si l'URL s'affiche correctement dans un navigateur.
Quelle est la différence entre « couldn't fetch » et « sitemap could not be read » ?
Ce sont deux erreurs de récupération très proches, affichées dans le même rapport de Search Console. « Couldn't fetch » indique généralement un problème de connexion ou d'accès ; « could not be read » indique plus souvent un problème d'analyse une fois le fichier atteint. Les deux se corrigent avec les mêmes vérifications : URL, code de statut, robots.txt et validité du XML.
Faites vérifier correctement l'état de votre sitemap
Un sitemap qui « could not be read » est presque toujours réparable dès que vous savez s'il s'agit d'un problème d'URL, d'un blocage, d'une erreur de syntaxe, ou simplement de Google qui prend du retard. Si vous souhaitez un regard extérieur sur votre sitemap et sur le reste de la santé technique de votre site, parlez à l'équipe et obtenez un exemple de rapport SEO construit autour de votre propre site.
Sources
À propos de l'auteur
SearchBlueprint a recherché, rédigé et noté cet article avec la chaîne de production de contenu que nos clients utilisent sur leurs propres sites. La note affichée dans la signature est celle que notre moteur de contenu a attribuée à cette page avant sa publication. Rien ici n'est relu à la main, et c'est tout l'intérêt : c'est le résultat du produit, publié là où chacun peut le vérifier.