Erreurs de pagination SEO qui font couler vos classements en silence
Par Toy Wen Da, Cofondateur · Mis à jour le · 33 min de lecture
Traduit de l'original en anglais. Lire en anglais
Les erreurs de pagination SEO se manifestent rarement par un effondrement soudain. Elles prennent la forme d'une fuite lente. Chaque mois, moins de pages sont indexées, les classements des pages de catégorie stagnent, et les rapports d'exploration se remplissent d'URL qui ne reçoivent jamais vraiment l'attention qu'elles méritent. Le problème n'est pas la pagination elle-même, mais la façon dont la plupart des sites la mettent en œuvre.
Ce guide passe en revue les endroits précis où la pagination déraille et explique pourquoi elle nuit à vos classements. Il montre ensuite comment la reconstruire pour que les moteurs de recherche puissent explorer, indexer et classer chaque page de la séquence, et pas seulement la première.
Qu'est-ce que la pagination en SEO ?
En SEO, la pagination consiste à répartir un grand ensemble de contenus sur plusieurs URL au lieu de tout entasser sur une seule page. Les listes de produits, les articles, les fils de discussion de forum et les résultats de recherche fonctionnent tous ainsi. Chaque page de la série a sa propre adresse, généralement du type /category/widgets?page=2, et les moteurs de recherche l'explorent et l'indexent comme une page autonome.
La pagination n'est pas une idée nouvelle. Le mot lui-même est antérieur à l'informatique de plusieurs siècles. La pagination des livres ne s'est imposée qu'autour de 1550, remplaçant l'ancien système qui ne numérotait que le recto de chaque feuillet. Sur le web, la pagination remplit la même fonction de base : elle donne un ordre navigable à une longue séquence de contenus. Mais elle doit aussi satisfaire un robot d'exploration, et pas seulement un lecteur.
Pourquoi elle existe
Sans pagination, un site de 10 000 produits devrait afficher les 10 000 sur une seule page, ou en cacher la plupart derrière du JavaScript. Les deux options sont mauvaises pour les performances et pour l'explorabilité. La documentation Google Search Central sur la pagination et le chargement incrémental des pages souligne que le découpage de grands ensembles de résultats en pages améliore la vitesse de chargement initiale et réduit le trafic réseau. C'est surtout important sur les connexions mobiles. Cela allège aussi la charge côté serveur et évite d'atteindre les limites de ressources du navigateur ou du serveur qu'entraîne l'affichage de listes extrêmement longues d'un seul coup.
Comment les moteurs de recherche traitent les pages paginées
C'est là que beaucoup de gens se perdent. Pendant des années, les référenceurs ont traité une série paginée comme un tout connecté, en grande partie parce que Google le leur disait avec le balisage rel="next" et rel="prev". Ce n'est plus ainsi que cela fonctionne.
Google a introduit rel="next" et rel="prev" en 2011, précisément pour mieux comprendre la relation entre les pages d'une séquence. Puis, le 21 mars 2019, Google a confirmé qu'il avait abandonné la prise en charge de ces balises et qu'il les ignorait déjà depuis un certain temps. Sa position actuelle : les pages paginées sont des pages ordinaires, point final. L'indexation dépend de signaux classiques, le maillage interne, les balises canoniques et la qualité du contenu, et non d'une directive de pagination spécifique. D'autres moteurs de recherche peuvent encore lire rel="next"/"prev", mais pas Google.
Ce seul changement explique pourquoi tant de configurations bâties autour de rel=next/prev à l'époque 2012-2018 sont aujourd'hui discrètement cassées. Si votre stratégie de canoniques, votre maillage et vos règles d'indexation ont été conçus autour de rel=next/prev, mieux vaut y regarder de plus près. Un audit SEO technique est le moyen le plus rapide de savoir si vos pages paginées envoient toujours les signaux que vous croyez.
Quels sont des exemples de pagination en SEO ?
La pagination apparaît partout où un site a plus de contenu qu'un écran n'en contient confortablement. Les détails de mise en œuvre diffèrent selon le cas d'usage, mais l'objectif sous-jacent est le même : garder chaque segment explorable et indexable.
| Cas d'usage | Modèle d'URL typique | Ce que la pagination protège |
|---|---|---|
| Pages de catégorie e-commerce | /shoes?page=3 |
La visibilité des produits dans un grand catalogue |
| Archives de blog ou d'actualités | /blog/page/4 |
Les anciens articles qui restent repérables |
| Fils de discussion de forum | /thread/128?p=5 |
Les longues conversations qui restent lisibles et indexables |
| Galeries d'images | /gallery/42?page=2 |
Le temps de chargement des pages riches en photos |
| Pages de résultats de recherche | /search?q=widgets&page=2 |
Les résultats profonds qui restent accessibles |
| Articles longs en plusieurs pages | /guide/part-3 |
La longueur de défilement et l'attention du lecteur sur de très longs guides |
Chacun présente un profil de risque différent. Un fil de forum réparti sur 40 pages présente peu de risque si le maillage est solide. Un catalogue de produits réparti sur 200 pages avec de mauvaises canoniques peut discrètement effacer l'essentiel de votre inventaire des résultats de recherche. C'est la version qui mérite le plus d'attention, et c'est celle sur laquelle ce guide se concentre le plus.
Comment la pagination influence-t-elle le SEO ?
La pagination influe sur l'explorabilité, l'indexation, la vitesse des pages et la façon dont le « link equity » (la valeur transmise par les liens) circule dans votre site. Bien faite, elle améliore les quatre. Mal faite, elle peut discrètement étouffer des pages que vous voulez justement voir classées.
Les avantages
La pagination améliore la vitesse des pages en limitant la quantité de contenu chargée à chaque requête, et la vitesse des pages est un facteur de classement confirmé. Elle crée aussi une piste de liens internes explorables que Google peut suivre pour atteindre des contenus enfouis profondément dans un catalogue ou des archives. Sans cette piste, les pages situées au-delà du premier écran peuvent devenir de fait orphelines : techniquement en ligne, mais jamais découvertes parce que rien ne pointe vers elles. Notre guide sur le maillage interne explique plus en détail la détection des pages orphelines si vous soupçonnez que c'est déjà le cas sur votre site.
Les inconvénients
Le mécanisme qui aide crée aussi un risque. Chaque URL paginée est un quasi-doublon de ses voisines : même modèle, même barre latérale, même structure générale, seuls dix ou vingt éléments au milieu changent. Les moteurs de recherche ont besoin d'un moyen de les distinguer sans les traiter comme du contenu dupliqué. C'est là qu'interviennent les balises canoniques, les URL uniques et un maillage cohérent. Si l'un de ces éléments est mal réglé, vous créez exactement la confusion que les moteurs de recherche cherchent à éviter. Google explore les URL qu'il trouve dans l'attribut href des balises d'ancre, et nulle part ailleurs. Il n'exécute pas les gestionnaires de clic « Charger plus » et ne déclenche généralement pas les fonctions JavaScript qui mettent à jour le contenu sans changement d'URL réel. Si votre pagination repose entièrement sur une interaction JavaScript sans href explorable, le contenu au-delà de la page 1 risque de ne jamais être indexé. Nous l'abordons plus en détail dans notre article sur pourquoi les applications monopages disparaissent de Google. La navigation dépendante de JavaScript est l'un des plus gros risques communs aux sites SPA et aux catalogues fortement paginés.
Les chiffres derrière l'impact de la pagination sur le classement
La plupart des conseils sur la pagination restent abstraits : « elle influe sur l'explorabilité », « elle influe sur la vitesse des pages ». Les chiffres réels sont plus concrets, et ils viennent de Google lui-même, pas du folklore SEO.
Commençons par la vitesse. Le programme Core Web Vitals de Google fixe trois seuils précis pour une bonne expérience de page. Le Largest Contentful Paint, le temps nécessaire pour afficher le contenu principal, doit rester sous 2,5 secondes. L'Interaction to Next Paint doit rester sous 200 millisecondes. Et le Cumulative Layout Shift doit rester sous 0,1. Ces chiffres viennent directement de la documentation web.dev de Google, la même équipe qui maintient les Core Web Vitals comme critère de classement. Une page de catégorie paginée affichant 24 produits part avec une avance évidente sur les trois indicateurs par rapport au même catalogue affiché sur une seule page ininterrompue de 400 produits. Il y a moins de HTML à analyser, moins d'images qui se disputent la bande passante au premier chargement, et moins de mise en page qui bouge à mesure que le contenu arrive. Ces seuils ne sont d'ailleurs pas des cibles abstraites. Search Console rapporte les performances des Core Web Vitals regroupées par modèles d'URL similaires. Un site peut donc réellement voir une série paginée passer de « à améliorer » à « bon » au fil des corrections, page après page, dans le même rapport que celui qui sert à diagnostiquer les problèmes d'indexation.
Le budget d'exploration est l'autre chiffre à connaître, et Google est ici inhabituellement direct sur ceux qui doivent s'en soucier. Sa documentation sur le budget d'exploration indique clairement que la plupart des sites n'ont pas du tout à y penser. Cela concerne spécifiquement les très grands sites dont les URL changent fréquemment. Ce n'est pas le cas d'un blog de quelques centaines d'articles, ni d'une boutique de quelques milliers de références. Le seuil pratique que la plupart des référenceurs retiennent, d'après la manière dont Google présente le guide, se situe quelque part autour de plusieurs dizaines de milliers d'URL et au-delà. En dessous, le budget d'exploration est rarement le goulot d'étranglement ; un serveur lent ou un lien cassé est bien plus probablement le vrai problème. Au-dessus, la prolifération de pages paginées devient l'un des premiers endroits à auditer. C'est particulièrement vrai sur les sites où les paramètres de filtre et de tri multiplient quelques milliers d'URL de base en centaines de milliers de combinaisons explorables.
Les deux chiffres sont liés. Une série qui se charge vite maintient les Core Web Vitals dans les clous sur chaque page, pas seulement sur la page 1. Une série tenue sobre, sans combinaisons de filtres incontrôlées ni variantes dupliquées à l'infini, garde le budget d'exploration braqué sur les pages qui peuvent réellement se classer. Si vous maîtrisez les deux, la pagination cesse d'être une taxe sur les performances et l'indexation et devient ce qui protège les deux.
Pagination mobile : zones tactiles et portée du pouce
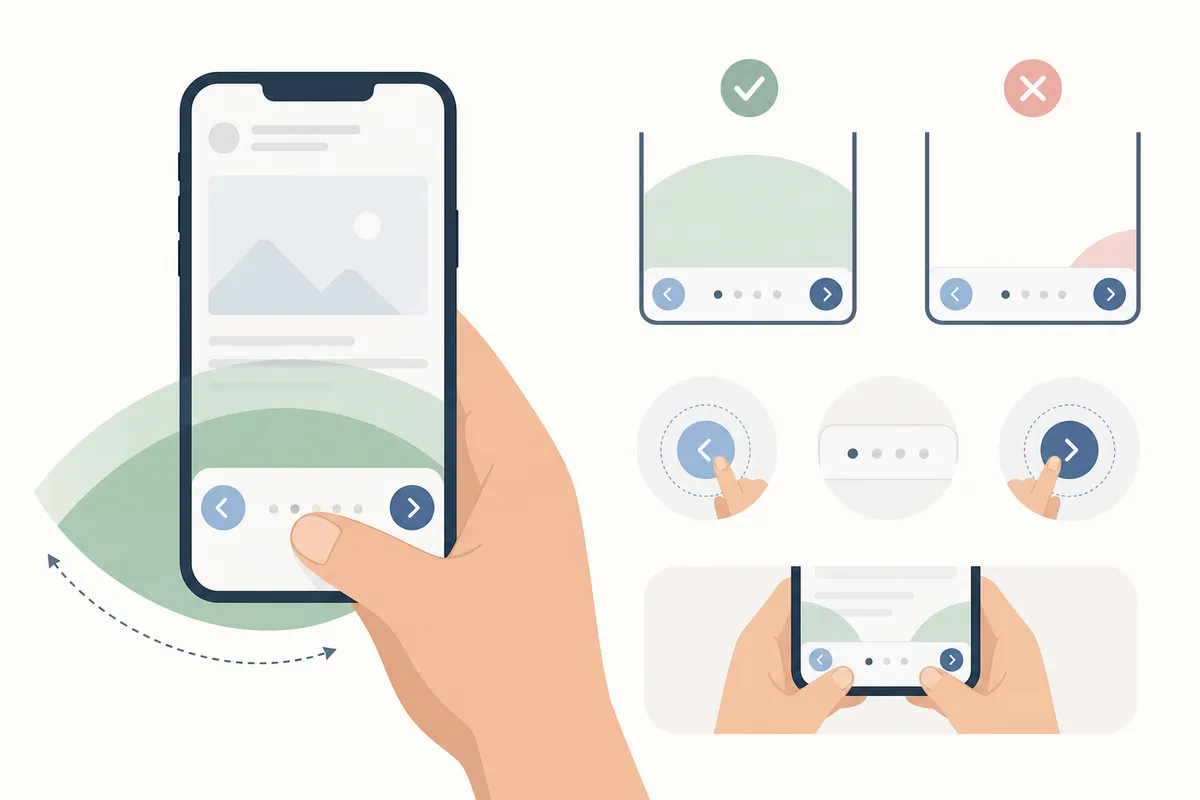
Les recommandations de Google sur la facilité d'utilisation sur mobile préconisent des zones tactiles d'au moins 48x48 pixels CSS, avec environ 8 px d'espacement entre elles, des chiffres tirés directement de la documentation de Google sur l'accessibilité et l'UX mobile. Les commandes de pagination entassées dans une minuscule rangée de numéros de page échouent souvent à ce test, surtout après la page 10, quand un nombre à deux chiffres doit se glisser dans la même case qu'un chiffre unique autrefois. La solution n'est pas compliquée : gardez des commandes « Précédent » et « Suivant » larges et bien espacées, et condensez le milieu numéroté sous une forme comme 1, 2, 3 … 9, 10, 11 plutôt que d'imprimer chaque numéro de page bord à bord. Une barre de pagination difficile à toucher avec précision sur un téléphone ne fait pas que frustrer les utilisateurs. Elle rend l'explorabilité sans objet si personne ne peut atteindre la page 4 sans trois erreurs de toucher. Comme l'essentiel du trafic commercial est mobile d'abord, mieux vaut tester sur un vrai téléphone, et pas seulement dans une fenêtre de navigateur de bureau redimensionnée, avant de supposer qu'une série paginée fonctionne comme la maquette le laissait penser.
Pagination, défilement infini et « charger plus »
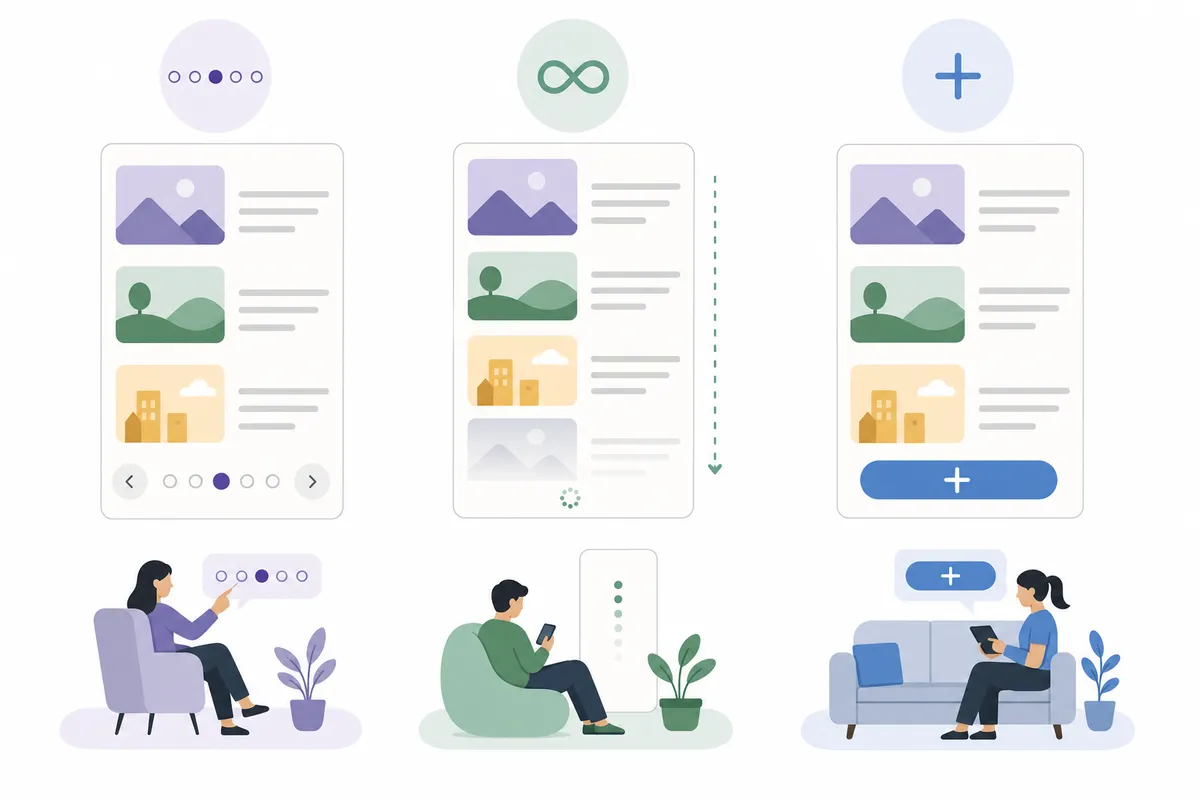
La pagination, le défilement infini et les boutons « charger plus » résolvent tous le même problème d'UX : trop de contenu pour un seul écran. Mais ils le font de façons différentes, avec des conséquences SEO différentes.
La pagination répartit le contenu sur des URL distinctes et adressables. Le défilement infini charge automatiquement plus de contenu à mesure que l'utilisateur descend sur une seule URL. Les boutons « charger plus » sont entre les deux : un clic manuel qui étend la page actuelle sans nécessairement changer l'URL. La différence n'est pas cosmétique. Elle détermine si un robot d'exploration peut atteindre votre contenu, tout simplement.
Comparaison des trois modèles
| Modèle | Explorabilité SEO | Expérience utilisateur | Le mieux adapté à |
|---|---|---|---|
| Pagination | Forte, chaque page a une URL unique et explorable | Bonne impression de progression et de taille totale ; facile de reprendre à une page précise | Catalogues de produits, archives, tout ce que les utilisateurs doivent comparer ou revisiter |
| Défilement infini | Faible, sauf s'il est associé en coulisses à des URL explorables | Sensation de continuité et d'immersion ; peut provoquer une « fatigue du défilement » sur de très longues listes | Fils sociaux, découverte d'images, navigation axée sur l'engagement |
| Charger plus | Faible, le contenu se charge généralement dans la même URL via JavaScript | Donne aux utilisateurs une impression de contrôle sans rechargement complet de la page | Listes de longueur moyenne pour lesquelles un défilement infini complet paraît excessif |
La documentation de Google est franche sur le compromis. La pagination permet aux utilisateurs de voir la longueur totale d'une liste et de savoir où ils en sont, au prix d'un clic supplémentaire entre les pages. Le défilement infini paraît sans effort mais masque la taille totale de la liste et peut rendre difficile le retour vers un contenu plus ancien.
Faire fonctionner le défilement infini pour la recherche
Le défilement infini n'est pas forcément une impasse SEO, mais il a besoin d'aide. La solution consiste à associer le comportement de défilement à de véritables URL paginées en dessous. Un robot qui accède directement à /products?page=2 doit obtenir le même contenu que celui qu'un utilisateur en train de faire défiler finirait par voir. Et history.pushState() doit mettre à jour la barre d'adresse pendant le défilement, afin que chaque segment reste partageable et accessible par un lien. Sans cette couche, le défilement infini devient une URL unique dont le contenu n'est tout simplement jamais atteint par un robot. L'accessibilité en pâtit aussi : le défilement infini peut désorienter les utilisateurs de lecteurs d'écran et enterrer le pied de page, ce que la pagination classique ne fait pas.
Normes d'accessibilité et défilement infini
La préoccupation d'accessibilité n'est pas qu'une règle empirique. Les Web Content Accessibility Guidelines, maintenues par la W3C Web Accessibility Initiative, posent deux exigences pertinentes. Les utilisateurs doivent pouvoir percevoir où ils se trouvent dans un ensemble de contenus. Et ils doivent pouvoir y naviguer uniquement au clavier, sans souris. Le défilement infini peut discrètement échouer sur les deux. Les utilisateurs de lecteurs d'écran qui parcourent une page avec la touche Tab comptent sur l'accès au pied de page pour savoir qu'une page est terminée. Si du nouveau contenu continue de se charger sous eux, le pied de page n'arrive jamais, et la page n'a de fait pas de fin. Les utilisateurs qui naviguent uniquement au clavier rencontrent un problème voisin : le focus peut sauter de façon imprévisible à mesure que de nouvelles sections s'affichent, les déposant à un endroit de la page qu'ils n'ont pas choisi.
Les solutions pratiques sont bien documentées. Associez le défilement à une commande « charger plus » visible, que les utilisateurs au clavier et avec lecteur d'écran peuvent déclencher volontairement plutôt que de dépendre de la position de défilement. Utilisez une région live ARIA, réglée sur « polite », pour annoncer le nouveau contenu à mesure qu'il se charge. Ainsi, les utilisateurs de lecteurs d'écran savent que quelque chose a changé sans que leur position dans le document soit bousculée. Et conservez un lien de pied de page réel et accessible, ou une commande « retour en haut », pour que la page ait toujours une fin navigable. Rien de tout cela n'est exotique. C'est le même niveau d'exigence que les WCAG fixent pour toute page qui se met à jour dynamiquement. Le défilement infini y échoue simplement plus souvent que la plupart des modèles, parce que le principe même de ce modèle est un contenu qui n'arrête jamais d'arriver.
Quand la pagination n'est pas la bonne solution
La pagination mérite sa place quand une liste est vraiment longue, mais beaucoup de listes ne le sont pas. Une catégorie de 18 produits n'a pas besoin de cinq pages de quatre éléments ; une seule page se charge tout aussi vite et donne à Google une page solide à classer au lieu de cinq pages minces. Le seuil pratique auquel la plupart des sites aboutissent, 40 à 60 éléments sur la page 1 avant de découper, garde une page unique bien en deçà des seuils des Core Web Vitals tout en évitant une duplication inutile. La même logique s'applique aux contenus longs : découper un article de 1 200 mots en trois « parties » minces, principalement pour gonfler les pages vues, tend à lui nuire, car chaque partie devient trop courte pour bien se classer seule et le découpage ajoute de la friction pour les lecteurs. Une seule page complète, bien structurée avec des titres clairs, est aussi plus facile à résumer ou à citer pour un système d'IA qu'une suite de courts fragments. Avant d'ajouter de la pagination à quoi que ce soit, il vaut la peine de se demander si la liste est réellement trop longue pour s'afficher correctement sur une seule page, ou si elle a simplement été découpée pour paraître plus fournie.
Les erreurs de pagination qui font couler vos classements en silence
C'est ici que se produisent la plupart des dégâts. Aucune de ces erreurs n'a l'air dramatique dans un navigateur : les pages se chargent toujours, le bouton « suivant » fonctionne toujours. Les dégâts apparaissent dans Google Search Console et dans les journaux d'exploration, des semaines après coup.
Erreur 1 : canonicaliser chaque page vers la page 1
C'est l'erreur de pagination la plus courante. Un développeur bien intentionné règle la balise canonique de chaque URL paginée pour pointer vers la page 1, pensant ainsi « consolider » les signaux de classement. Cela indique en fait à Google que les pages 2 à 50 ne sont pas destinées à être indexées seules, qu'elles sont des doublons de la page 1. Google respecte souvent cette instruction et retire ces pages de l'index. Si votre catalogue contient des produits uniques qui ne figurent que sur la page 4 ou la page 12, ces produits disparaissent de fait de la recherche. Chaque page d'une série paginée doit porter une canonique auto-référencée, une balise qui pointe vers elle-même, et non vers la page 1. Si vous n'êtes pas sûr que vos balises canoniques font ce que vous croyez, lisez notre analyse des erreurs de balise canonique qui provoquent du contenu dupliqué. Cette même erreur apparaît aussi très souvent en dehors de la pagination.
Erreur 2 : mettre les pages paginées en noindex « pour nettoyer l'index »
Certaines équipes font l'inverse : elles ajoutent noindex à toutes les pages au-delà de la page 1. L'hypothèse est que cela mettra de l'ordre dans les résultats de recherche et orientera l'autorité vers la page de catégorie principale. Cela se retourne généralement contre elles. Noindex indique à Google de retirer entièrement la page de l'index. Si cette page est le seul endroit où figure un produit, un article ou un message de forum particulier, ce contenu cesse d'apparaître dans la recherche, point final. Pire, combiner une balise noindex et une balise canonique sur la même page envoie des signaux contradictoires : l'une dit « ne m'indexez pas », l'autre « je suis la version faisant autorité de cette URL ». Google doit deviner laquelle croire, et son choix ne va pas toujours dans votre sens.
Erreur 3 : des commandes de navigation uniquement en JavaScript
Si votre commande « page suivante » est un <button> avec un gestionnaire onclick et sans véritable href, vous pariez vos pages profondes sur le fait que Googlebot exécutera parfaitement votre JavaScript. Il faudrait que cela se produise à chaque fois, à chaque exploration, sans exception. C'est un mauvais pari. Google explore les URL qu'il trouve dans les attributs href des balises d'ancre. Il ne clique pas sur les boutons, et il ne déclenche généralement pas le type de scripts dépendant d'une interaction utilisateur que beaucoup de frameworks front-end utilisent pour remplacer le contenu. Chaque commande « suivant » et « précédent » doit être une véritable balise d'ancre pointant vers une URL réelle et explorable. JavaScript peut toujours améliorer l'expérience du clic, mais le lien sous-jacent doit exister dans le balisage.
Erreur 4 : laisser les paramètres de filtre et de tri multiplier vos URL
Une page de catégorie paginée, c'est déjà une URL multipliée par des dizaines de pages. Ajoutez des filtres, taille, couleur, prix, marque, et des options de tri, prix croissant, nouveautés, meilleures ventes, et vous pouvez générer des milliers de combinaisons d'URL quasi identiques à partir d'une seule catégorie. Les moteurs de recherche ne veulent pas toutes les indexer ; la plupart n'apportent aucune valeur propre et ne font que diluer l'attention d'exploration sur du contenu quasi dupliqué. La solution est soit une balise meta noindex sur les variantes d'URL filtrées/triées, soit une règle disallow dans robots.txt pour les modèles de paramètres concernés. Dans les deux cas, les robots cessent de dépenser leur attention limitée sur des combinaisons qui ne se classeront jamais. La syntaxe disallow de robots.txt n'est d'ailleurs pas qu'une convention. C'est désormais une norme officielle de l'IETF, la RFC 9309, utile à connaître si un développeur se demande un jour si une règle disallow sera respectée de façon fiable par les principaux robots.
Erreur 5 : utiliser des fragments d'URL au lieu de vrais chemins
Certaines implémentations de pagination utilisent un identifiant de fragment, la partie d'une URL située après un #, pour représenter le numéro de page, comme /products#page2. Google ignore tout ce qui suit un # lorsqu'il évalue une URL. Si la seule différence entre deux URL est le texte après le #, Googlebot peut les traiter comme la même page déjà récupérée. Il peut tout simplement ne pas se donner la peine d'explorer ce qu'il croit être un doublon. Les numéros de page doivent figurer dans le chemin ou dans un vrai paramètre de requête, jamais dans un fragment.
Erreur 6 : sur-optimiser chaque page de la série
Il est tentant de rédiger un titre et une méta-description uniques et riches en mots-clés pour chaque page paginée, comme on le ferait pour des pages réellement distinctes. Ne le faites pas. La page 2 d'une catégorie « chaussures de running » en concurrence avec la page 1 de la même catégorie sur le même mot-clé, c'est de la cannibalisation de mots-clés contre vous-même. La solution habituelle consiste à désoptimiser les pages paginées au-delà de la page 1. Gardez des titres et des descriptions similaires ou identiques sur toute la série, Google a confirmé que c'est acceptable pour une séquence paginée, puisqu'il reconnaît la relation et indexe en conséquence. Concentrez ensuite votre ciblage de mots-clés principal, vos liens internes et votre optimisation sur la page pour la page de catégorie racine.
Erreur 7 : casser la chaîne de liens
Ce schéma repose sur des connexions explorables entre les pages. Si la page 3 pointe vers la page 4 mais que rien ne renvoie vers la page 1, ou si la séquence se rompt quelque part au milieu, Google a plus de mal à comprendre la série. Il lui est aussi plus difficile d'atteindre les pages les plus éloignées du début. La bonne pratique consiste à relier chaque page à la suivante dans la séquence, et à relier chaque page à la page 1. Cela signale à Google que la page 1 est le point d'entrée naturel de la série. Ce n'est en réalité qu'un cas particulier d'un problème bien plus large : des pages qui existent mais ne sont pas bien connectées au reste du site. Notre analyse approfondie des erreurs de structure de site qui coûtent des places au classement traite du même type de défaillance en dehors de la pagination.
Erreur 8 : traiter le défilement infini comme un raccourci d'explorabilité
Le défilement infini fait moderne, et il améliore réellement les indicateurs d'engagement sur les fils de contenu. Mais remplacer une navigation par pages par un défilement infini sans ajouter d'URL explorables en dessous est l'une des histoires les plus courantes en SEO du type « nous avons refondu le site et le trafic a chuté ». Si un robot ne voit que le premier lot d'éléments à l'URL de base, et que tout le reste se charge au défilement sans structure de liens correspondante, tout ce qui suit ce premier lot est de fait invisible pour les moteurs de recherche. Les utilisateurs peuvent tout voir ; Google, non.
Erreur 9 : ignorer le budget d'exploration sur de très grands catalogues
Pour un site de quelques centaines de pages, le budget d'exploration compte à peine. Pour un site de plusieurs dizaines de milliers de pages de produits ou d'archives paginées, il compte beaucoup. Chaque URL paginée mince et quasi dupliquée que Google explore est de l'attention qu'il ne consacre pas à vos pages de plus grande valeur. Une prolifération de pages excessive et mal élaguée, surtout combinée à des paramètres de filtre et de tri incontrôlés, peut ralentir sensiblement la vitesse à laquelle le contenu nouveau ou mis à jour est pris en compte ailleurs sur le site. Si vous voyez des pages rester non indexées pendant des semaines, la prolifération de pages paginées est une cause fréquente ; notre guide sur pourquoi des pages sont ignorées lors de l'indexation explique comment la diagnostiquer. La documentation de Google sur le budget d'exploration est directe sur les sites concernés. Les sites qui n'ont pas un grand nombre d'URL changeant fréquemment n'ont généralement pas à s'en préoccuper du tout. C'est précisément pourquoi un petit blog a rarement besoin de ce guide, alors qu'un catalogue de 200 000 références en a besoin.
Comment structurer la pagination pour qu'elle serve vraiment le classement
Corriger la pagination n'est pas compliqué une fois qu'on connaît la liste de contrôle. L'essentiel consiste à défaire l'une des neuf erreurs ci-dessus, de façon cohérente, sur toute la série.
1. Auto-canonicaliser chaque page
Chaque URL paginée doit porter une balise canonique qui pointe vers elle-même : la canonique de la page 2 pointe vers la page 2, celle de la page 3 vers la page 3, et ainsi de suite. Ne renvoyez jamais toute la série vers la page 1. Ce seul changement règle l'erreur la plus dommageable de cette liste.
2. Utiliser des URL claires, descriptives et explorables
Donnez à chaque page de la série sa propre URL réelle, accessible par un lien href standard, par exemple /category?page=2 ou /category/page/2, et non un remplacement de contenu déclenché par JavaScript sur une seule adresse. Des modèles d'URL clairs et cohérents facilitent aussi beaucoup l'audit ultérieur d'une série paginée à grande échelle.
3. Ne pas utiliser de fragments pour les numéros de page
Gardez le numéro de page dans le chemin ou dans un vrai paramètre de requête. Ne comptez jamais sur un fragment # pour différencier une page d'une autre, Google ignore entièrement cette partie de l'URL.
4. Désoptimiser les pages au-delà de la page 1
Laissez la page racine porter votre ciblage de mots-clés principal, vos liens internes les plus forts et votre meilleur contenu. Les pages 2 et suivantes peuvent partager des titres et des méta-descriptions similaires ; c'est un comportement attendu pour une série paginée, pas une pénalité de contenu dupliqué qui n'attend que de tomber.
5. Garder les pages paginées indexables
Résistez à l'envie de mettre en noindex les pages au-delà de la page 1 « au cas où ». Sauf si une page précise est vraiment de faible valeur (une variante filtrée/triée, par exemple), laissez-la indexable pour que tout contenu unique qu'elle contient puisse toujours être trouvé.
6. Relier les pages en séquence, et vers la page 1
Chaque page doit pointer vers la page suivante, et chaque page doit pointer vers la page 1. Cela donne à Google un chemin net et cohérent à travers toute la série et renforce l'idée que la page de la séquence qui mérite le plus d'autorité est la première.
7. Maîtriser la prolifération des paramètres de filtre et de tri
Décidez d'emblée quelles combinaisons de paramètres méritent d'être indexées (en général : aucune) et bloquez les autres avec des règles noindex ou robots.txt. Cela garde le budget d'exploration concentré sur les pages qui peuvent réellement se classer.
8. Aider les robots et les utilisateurs avec le preload et le prefetch
La documentation de Google recommande expressément de précharger (preload), de préconnecter (preconnect) ou de prérécupérer (prefetch) la page suivante d'une séquence. Cela accélère l'expérience des utilisateurs qui parcourent la série, un détail de performance qui soutient aussi le signal de vitesse de page que la pagination est en partie censée protéger.
9. Vérifier toute la chaîne avec un audit technique
La pagination touche en même temps les balises canoniques, le maillage interne, les directives d'indexation et les chemins d'exploration. C'est précisément pourquoi il est facile de bien régler un élément et d'en rater un autre sans s'en apercevoir. Un audit SEO technique complet vérifie les quatre ensemble au lieu de les examiner isolément, et il vaut généralement la peine d'en lancer un avant et après tout changement important de pagination.
Hreflang et pagination sur les sites multilingues
Les sites qui proposent plusieurs versions linguistiques d'un même catalogue paginé ajoutent une couche que la plupart des conseils sur la pagination ignorent totalement. Chaque URL paginée a besoin de son propre ensemble hreflang, pas seulement la page 1, ce qui signifie que la page 3 du catalogue anglais doit pointer vers la page 3 des versions française et allemande, et non vers leurs pages 1 respectives. L'erreur courante consiste à traiter hreflang comme un réglage réservé à la page 1 et à le laisser disparaître silencieusement de toutes les pages suivantes. Google doit alors deviner la bonne correspondance linguistique pour les pages 2 à 40 sur chaque marché. La disparition de hreflang sur les pages profondes de la pagination est tout aussi dommageable qu'une canonique manquante : elle indique discrètement aux moteurs de recherche que la relation entre les versions linguistiques s'arrête après la première page, alors que le catalogue se poursuit évidemment. Tout site qui gère une pagination internationale devrait vérifier cela spécifiquement lors d'un audit, plutôt que de supposer que le CMS l'a reporté automatiquement, car beaucoup de modèles traitent hreflang et pagination comme deux réglages sans rapport qui n'ont jamais été testés ensemble.
Exemple concret : reconstruire la pagination d'une catégorie de 40 pages
Les conseils abstraits sont faciles à approuver et difficiles à appliquer. Voici à quoi ressemble, étape par étape, la correction d'une vraie page de catégorie paginée, avec une boutique hypothétique dont la catégorie « Running Shoes » s'étend sur 40 pages de 20 produits chacune, soit 800 produits au total.
Étape 1 : trouver ce qui est réellement cassé
Avant de toucher au code, récupérez la balise canonique, la balise meta robots et le href du lien « suivant » sur un échantillon de cinq pages : page 1, page 2, page 10, page 25 et page 40. Dans cet exemple, les pages 2 à 40 portent toutes :
<link rel="canonical" href="https://example.com/running-shoes" />
C'est l'erreur la plus courante de cette liste : chaque page après la page 1 renvoie sa canonique vers la catégorie racine. On dit en fait à Google que les pages 2 à 40 n'existent pas en tant qu'entités propres.
Étape 2 : corriger le sens de la canonique
La correction est un changement d'une ligne dans le modèle, appliqué à l'ensemble du site plutôt que page par page. La canonique de la page 2 devrait être :
<link rel="canonical" href="https://example.com/running-shoes?page=2" />
Et ainsi de suite jusqu'à la page 40, chaque page pointant vers elle-même. Sur la plupart des plateformes CMS, il s'agit d'une seule condition dans le modèle de catégorie, et non de quarante modifications manuelles. C'est exactement pourquoi cette erreur est si courante : la personne qui a écrit le modèle a inversé la logique une fois, et cela s'est appliqué silencieusement à chaque page de chaque catégorie du site à partir de ce moment.
Étape 3 : vérifier la chaîne de liens
Une fois les canoniques corrigées, vérifiez que la page 2 pointe vers la page 3, la page 3 vers la page 4, et ainsi de suite jusqu'à la page 40, et que chaque page renvoie aussi vers la page 1. Une exploration avec un outil comme Screaming Frog, filtrée sur ce modèle d'URL, devrait montrer une chaîne continue sans trous. Dans cet exemple, la chaîne se rompt à la page 23 : un bug du composant de pagination supprime entièrement le lien « suivant » dès que le numéro de page atteint deux chiffres au-delà de 20. Cela vaut la peine d'être repéré avant de déclarer la correction terminée ; une canonique corrigée ne sert à rien si le robot ne peut jamais atteindre la page dont vous venez de corriger la canonique.
Étape 4 : désoptimiser tout ce qui suit la page 1
Le titre de la page 1, « Running Shoes | 800+ Styles, Free Shipping | Example Shop », reste intact ; c'est la page qui porte la cible de mot-clé principale. Les pages 2 à 40 reçoivent un titre quasi identique avec le numéro de page ajouté, par exemple « Running Shoes | Page 3 | Example Shop ». C'est préférable à quarante titres rédigés de façon unique qui se concurrencent avec la page 1 sur les mêmes termes de recherche. Google a confirmé que cette duplication sur une série paginée est attendue et acceptable ; ce sont quarante titres uniques visant un même mot-clé qui provoquent l'auto-concurrence, pas quarante titres similaires.
Étape 5 : réexplorer et resoumettre
Une fois les changements de modèle déployés, soumettez l'URL de la catégorie mise à jour via l'outil d'inspection d'URL de Search Console pour provoquer une réexploration plus rapide de la page 1, et laissez le reste de la série être pris en compte par l'exploration normale grâce aux liens internes désormais corrigés. Ne soumettez pas les 40 URL manuellement ; c'est le rôle de la chaîne de liens de l'étape 3.
Étape 6 : surveiller le rapport d'indexation pour confirmation
Attendez de deux à quatre semaines, puis retournez dans le rapport d'indexation des pages de Search Console et filtrez sur le modèle d'URL de la catégorie. Les pages auparavant marquées « Duplicate without user-selected canonical » devraient commencer à passer à « Indexed ». Cela se fait lot par lot plutôt que d'un coup, car Google réexplore les pages à des rythmes différents selon la fréquence à laquelle chacune a changé par le passé. Une page enfouie en position 35 dans la série, rarement explorée parce que rien n'y change souvent, peut mettre nettement plus de temps à basculer que la page 2. C'est normal, ce n'est pas le signe que la correction a échoué.
Ce qui a changé
Trois corrections au niveau du modèle, le sens de la canonique, un lien cassé dans la chaîne et la duplication des titres, remplacent ce qui aurait autrement été quarante corrections manuelles distinctes. Ce rapport est le véritable argument pour corriger la pagination au niveau du modèle : une seule erreur de logique a créé le problème sur tout un catalogue, et un seul modèle corrigé l'élimine de la même façon.
La pagination n'est pas qu'un choix de front-end : la pagination de type API
La plupart des discussions SEO sur la pagination portent sur la page que l'on voit dans un navigateur. Mais si votre site repose sur un CMS headless, une boutique sur mesure ou tout système qui récupère les données de produits et de contenus depuis une API, la méthode de pagination utilisée par votre back-end peut déterminer ce que le front-end est même capable d'exposer aux robots.
Comme l'a écrit le développeur Phil Sturgeon dans un article très lu sur la pagination d'API : « pagination is basically breaking down a large dataset into smaller chunks, which can be fetched incrementally by a client. » Les trois approches courantes présentent chacune de vrais compromis.
| Méthode | Fonctionnement | Le plus adaptée à | Point faible |
|---|---|---|---|
| Par page | Le client demande page=2&size=10 ; le serveur renvoie cette page ainsi que le nombre total de pages |
Les interfaces simples qui affichent des liens de pages numérotées | Compter l'ensemble des données devient plus lent à mesure qu'il grossit |
| Par décalage (offset) | Le client demande offset=10&limit=10 ; le serveur saute en avant et renvoie le lot suivant |
Les back-ends simples, requêtes SQL LIMIT/OFFSET |
Les performances se dégradent fortement pour de grands décalages sur de grandes tables |
| Par curseur | Le client envoie un curseur opaque (souvent un identifiant d'enregistrement encodé) indiquant où la dernière page s'est arrêtée | Les jeux de données très volumineux et qui changent souvent | Difficile d'en tirer directement une interface du type « page 1, 2, 3… 10 » |
Ce qu'il faut en retenir pour le SEO : si votre back-end utilise la pagination par curseur pour des raisons de performance, assurez-vous que le front-end génère tout de même des URL stables, explorables et pouvant être mises en favori pour chaque page. Ne vous contentez pas d'un curseur d'API opaque qui change à chaque mise à jour des données. Des URL incohérentes d'une exploration à l'autre rendent beaucoup plus difficile pour Google de reconnaître la « page 2 d'aujourd'hui » comme la même page que celle qu'il a indexée la semaine dernière.
Cela compte plus qu'avant, car de plus en plus, les pages ne sont pas seulement lues par des navigateurs et des robots d'exploration, elles sont lues par des systèmes d'IA qui résument ou citent le contenu. Une série paginée aux URL instables est aussi déroutante pour ces systèmes que pour Googlebot. Si c'est une priorité pour votre catalogue ou vos archives de contenu, notre page sur le generative engine optimization explique plus largement comment la cohérence structurelle alimente la découverte par l'IA.
Les séries paginées doivent-elles porter des données structurées ?
Les données structurées ne réparent ni une canonique erronée ni un lien manquant, mais elles répondent à une question que le reste de ce guide n'aborde pas : une série paginée doit-elle indiquer explicitement aux moteurs de recherche à quoi ressemble toute la collection, et pas seulement ce qui figure sur la page actuelle ?
Schema.org, le vocabulaire de données structurées maintenu conjointement par Google, Microsoft, Yahoo et Yandex, définit un type ItemList pour exactement cette situation : un ensemble d'éléments avec un ordre défini. Il décrit une série paginée comme une seule liste logique plutôt que comme quarante pages sans rapport. Une mise en œuvre minimale sur la page 3 d'une catégorie de 40 pages pourrait ressembler à ceci :
{
  "@context": "https://schema.org",
  "@type": "ItemList",
  "itemListElement": [
    { "@type": "ListItem", "position": 41, "url": "https://example.com/products/trail-runner-x1" },
    { "@type": "ListItem", "position": 42, "url": "https://example.com/products/trail-runner-x2" }
  ]
}
Les valeurs position se poursuivent sur toute la série au lieu de repartir de zéro à chaque page. Les éléments 41 et 42, par exemple, se trouvent sur la page 3 d'une série affichant 20 éléments par page. C'est ce qui permet à un consommateur de ce balisage de comprendre où se situe une page donnée dans l'ensemble de la collection.
Est-ce nécessaire ? Non. Google n'exige pas le balisage ItemList pour comprendre ou indexer correctement une série paginée. Les balises canoniques et les liens internes présentés plus haut dans ce guide suffisent à eux seuls. Ce qu'ItemList ajoute, c'est une description plus claire et lisible par machine de la collection pour tout système qui analyse les données structurées. Cela inclut les moteurs de réponse qui lisent de plus en plus le balisage d'une page plutôt que seulement son texte affiché. Un catalogue de produits qui balise sa série paginée avec ItemList donne à ces systèmes une vue explicite et ordonnée : « voici les éléments 41 à 60 d'une liste de 800 ». C'est mieux que de les forcer à déduire la structure à partir de quarante documents HTML distincts. Pour les sites qui investissent dans la visibilité au-delà des résultats de recherche traditionnels, c'est un ajout raisonnable et peu coûteux une fois que les fondamentaux de canoniques et de maillage sont solides, pas un remplacement.
L'ordre des opérations compte ici. Corriger une canonique inversée sur une série de 40 pages vaut la peine d'être fait cette semaine. Ajouter le balisage ItemList à la même série vaut la peine d'être fait un jour, une fois les fondamentaux acquis, et non à leur place.
Outils pour auditer la pagination à grande échelle
Vérifier la pagination à la main fonctionne pour un fil de forum de cinq pages ; cela ne passe pas à l'échelle d'un catalogue de 40 000 références. Screaming Frog est le point de départ le plus courant : sa version gratuite explore jusqu'à 500 URL, et une licence payante supprime cette limite et ajoute l'extraction personnalisée nécessaire pour récupérer en une seule passe les balises canoniques et les valeurs href de chaque page paginée. Sitebulb prolonge la même idée avec une carte d'exploration visuelle qui rend une chaîne de liens cassée plus facile à repérer qu'en parcourant une feuille de calcul. JetOctopus et ContentKing surveillent tous deux le comportement d'exploration en continu plutôt que par un instantané unique, ce qui compte particulièrement ici, car un bug de modèle peut réintroduire silencieusement une canonique cassée des mois après le déploiement de la correction initiale. Aucun de ces outils ne remplace le rapport d'indexation des pages de Google Search Console, le seul outil qui montre comment Google traite réellement chaque URL paginée à l'instant présent. Mais un robot d'exploration vous donne le « pourquoi » de ce que Search Console signale comme un symptôme. Utiliser les deux ensemble, une exploration plus Search Console, permet de détecter des problèmes qu'aucun des deux outils ne fait ressortir clairement seul.
Auditer et corriger les problèmes de pagination
Trouver un problème de pagination demande généralement moins d'efforts qu'on ne le croit, les signaux sont cohérents une fois qu'on sait quoi vérifier.
Ce qu'il faut vérifier en premier
Commencez par le rapport d'indexation des pages de Google Search Console. Cherchez les URL paginées marquées « Duplicate without user-selected canonical » ou « Alternate page with proper canonical tag ». Les deux sont de forts indices que votre stratégie de canoniques pointe dans le mauvais sens. Explorez ensuite le site directement avec un outil comme Screaming Frog, en filtrant sur les modèles d'URL paginées. Vérifiez ce que disent réellement la balise canonique et la balise meta robots de chaque page, par rapport à ce que vous attendez.
| Vérification | Où regarder | À quoi ressemble un problème |
|---|---|---|
| Sens de la canonique | Source de la page, <link rel="canonical"> |
Les pages 2+ ont pour canonique la page 1 au lieu d'elles-mêmes |
| Statut d'indexation | Google Search Console → Page Indexing | URL paginées marquées comme doublons ou exclues |
| Accessibilité des liens | Exploration du site (Screaming Frog, JetOctopus, etc.) | Liens « Suivant » sans href, ou présents uniquement en JS |
| Prolifération de paramètres | Rapport d'exploration, nombre de paramètres d'URL | Des centaines de combinaisons de filtre/tri explorées |
| Usage de fragments | Revue de la structure des URL | Numéros de page apparaissant après un # |
Corriger ce que vous trouvez
Une fois que vous avez identifié l'erreur en cause, la correction est presque toujours l'une des neuf corrections ci-dessus. Inversez le sens de la canonique, retirez un noindex inutile, remplacez une commande uniquement JS par un vrai lien, ou resserrez les règles robots sur les variantes de paramètres. Le plus difficile est généralement de fixer les priorités. Sur un catalogue de milliers d'URL paginées, corriger le sens de la canonique sur tout le site tend à produire la récupération la plus importante et la plus rapide, puisqu'elle touche en une fois chaque page de chaque série. Un guide plus large sur la correction technique SEO est une bonne lecture suivante si la pagination n'est qu'un symptôme d'un problème plus vaste de budget d'exploration ou d'indexation sur votre site.
Combien de temps dure la récupération après une correction de pagination
C'est la question que la plupart des guides esquivent, et c'est pourtant celle à laquelle les gens veulent vraiment une réponse : après avoir corrigé une canonique cassée ou une balise noindex, au bout de combien de temps les pages reviennent-elles ?
Il n'y a pas de chiffre fixe, et la documentation de Google sur l'exploration et l'indexation ne prétend pas le contraire. Elle décrit le calendrier de réexploration comme dépendant de la demande d'exploration, de l'importance que Google accorde à une URL et de la fréquence à laquelle elle a changé par le passé, plutôt que d'un calendrier garanti. Cela dit, un schéma approximatif se vérifie sur la plupart des sites qui effectuent une correction de pagination à l'échelle du site.
La page 1 et les pages de catégorie à fort trafic sont généralement réexplorées en quelques jours, puisque Google les visite déjà fréquemment. Si vous soumettez l'URL via l'outil d'inspection d'URL de Search Console, cela peut se réduire à un jour ou deux.
Les pages du milieu de la série (environ les pages 2 à 10) suivent généralement dans un délai d'une à trois semaines, prises en compte par l'exploration normale de la chaîne de liens internes désormais corrigée plutôt que par une soumission manuelle.
Les pages profondes de la série (page 20 et au-delà) peuvent prendre un mois ou plus, surtout sur les sites que Google explore moins souvent dans l'ensemble. Ces pages avaient la plus faible priorité d'exploration avant la correction. Une canonique corrigée ne relève pas automatiquement cette priorité, elle supprime simplement l'obstacle actif qui les maintenait hors de l'index.
La récupération complète du classement, par opposition à la simple réindexation, suit généralement la réindexation avec quelques semaines de retard. Une page peut revenir dans l'index et mettre encore du temps à retrouver les classements qu'elle occupait. C'est parce que Google réévalue aussi la place de cette page dans la version actuelle du site, au lieu de simplement restaurer un classement en cache d'avant l'erreur.
Quelques éléments accélèrent le processus : une chaîne de liens internes propre et ininterrompue, un sitemap qui liste les URL corrigées et l'autorité globale du site. Un site bien établi, visité fréquemment par Googlebot, récupérera toujours plus vite qu'un site plus petit que Google explore chaque semaine. Quelques éléments le ralentissent aussi : un grand catalogue où le schéma cassé a touché des dizaines de milliers d'URL à la fois, ou un site dont le budget d'exploration était déjà contraint avant la correction.
La réserve honnête : si quatre à six semaines passent sans aucun mouvement sur la page 1 et les pages de catégorie à plus fort trafic, la correction n'a probablement pas pleinement pris. C'est différent d'une récupération simplement lente, et il vaut mieux réaliser un nouvel audit que d'attendre plus longtemps.
La pagination selon les plateformes
Les paramètres par défaut de la pagination varient beaucoup d'une plateforme à l'autre, et un réglage correct sur un CMS peut être un handicap sur un autre.
Les plateformes e-commerce sont le cas où les enjeux sont les plus élevés, puisque les pages de catégorie paginent souvent des centaines de produits et génèrent directement du chiffre d'affaires. Si votre catalogue suit les bonnes pratiques de SEO e-commerce, la canonicalisation de la pagination et la maîtrise des paramètres méritent de figurer en haut de la liste de contrôle. Elles ne devraient pas être une réflexion après coup traitée une fois par an.
Au-delà du e-commerce, les plateformes CMS diffèrent dans la quantité de contrôle sur la pagination qu'elles proposent d'emblée. Certaines génèrent par défaut des pages d'archive paginées auto-canonicalisées ; d'autres exigent des modifications manuelles de modèle pour obtenir la bonne structure de canoniques et de liens. Si vous travaillez dans les contraintes d'une plateforme précise, nos guides SEO par CMS présentent les réglages importants pour votre stack, y compris les endroits où les paramètres par défaut de la pagination ont tendance à nécessiter des ajustements.
Quelques exemples concrets montrent à quel point les paramètres par défaut diffèrent réellement. La pagination native de WordPress (/blog/page/2/, générée par sa fonction intégrée paginate_links()) est auto-canonicalisée par défaut. Chaque archive paginée reçoit sa propre canonique qui pointe vers elle-même, et les plugins SEO populaires préservent généralement ce comportement au lieu de le remplacer. L'erreur courante sur WordPress n'est pas le comportement par défaut de la plateforme ; c'est un thème ou un plugin de constructeur de pages superposé qui réécrit silencieusement la canonique vers la page 1.
Les pages de collection de Shopify paginent automatiquement au-delà d'un certain nombre de produits, couramment 36 ou 50, selon le thème. Shopify génère des balises canoniques qui pointent chaque page de collection paginée vers elle-même plutôt que vers la première page, un comportement par défaut correct. Les boutiques Shopify rencontrent généralement des problèmes avec les paramètres de filtre et de tri ajoutés par-dessus les collections, via des applications ou des widgets de filtrage personnalisés. Ceux-ci peuvent générer de grands volumes de combinaisons de paramètres explorables en dehors des comportements par défaut de la plateforme.
WooCommerce, qui fonctionne sur WordPress, hérite de la mécanique de pagination de WordPress pour ses archives de boutique et de catégories, de sorte que le même comportement d'auto-canonicalisation par défaut s'applique généralement. Mais les boutiques WooCommerce ajoutent couramment des plugins de filtrage tiers, pour la fourchette de prix, les attributs ou la marque, qui introduisent le même problème de prolifération de paramètres que celui des boutiques Shopify, simplement via un autre ensemble de plugins.
Les boutiques headless et sur mesure n'ont aucun comportement par défaut. Ce que l'équipe front-end met en œuvre est le comportement que vous obtenez, ce qui explique aussi pourquoi les sites headless sont surreprésentés dans les erreurs de sens de canonique. Aucune convention de plateforme ne les protège discrètement comme c'est le cas avec WordPress ou Shopify.
Le schéma commun à toutes ces plateformes : la plateforme de base est rarement l'endroit où la pagination casse. C'est presque toujours un thème, un plugin, une application ou un modèle personnalisé superposé qui remplace un bon comportement par défaut par un mauvais. C'est la première chose à vérifier sur n'importe quelle plateforme, avant de supposer que le CMS lui-même est le problème.
Mythes courants sur la pagination à retirer du circuit
Quelques croyances sur la pagination continuent de circuler longtemps après avoir cessé d'être vraies. La première : que rel="next"/"prev" aide encore Google à comprendre une série, alors que Google ignore ces deux balises depuis avant son annonce de 2019. La deuxième : que davantage de pages paginées signifie toujours plus de budget d'exploration dépensé, alors qu'en pratique une série sobre et bien reliée de pages auto-canonicalisées est peu coûteuse à explorer pour Google. Ce sont la prolifération de paramètres et les canoniques cassées qui gaspillent le budget, pas le nombre de pages en soi. La troisième : que le défilement infini est automatiquement pire pour le SEO que la pagination numérotée, alors que le vrai facteur déterminant est l'existence d'URL explorables sous le défilement, pas le modèle choisi par un designer. Et la quatrième : que mettre les pages profondes en noindex est une option par défaut prudente et sûre, alors que c'est généralement le contraire, une façon de retirer discrètement un contenu que Google aurait très bien indexé autrement. Chacun de ces mythes renvoie à la même cause profonde : traiter la pagination comme un problème résolu depuis 2015 au lieu de vérifier ce qui se passe réellement dans l'exploration d'aujourd'hui.
Comment décider si la pagination doit être corrigée maintenant
Tous les problèmes de pagination ne sont pas urgents. Un forum avec des liens next/prev propres et des canoniques correctes n'a pas besoin d'attention simplement parce que ce guide existe. La pagination mérite une revue immédiate lorsque l'une des situations suivantes se vérifie. Une grande part de votre catalogue ou de vos archives se trouve à deux pages de profondeur ou plus. Vos balises canoniques ont été configurées avant 2019 et n'ont pas été revues depuis l'abandon de rel=next/prev. Votre site a récemment ajouté un défilement infini ou un bouton « charger plus » sans vérifier ce qu'il advient des URL sous-jacentes. Ou Search Console affiche un nombre croissant d'URL paginées « en doublon » ou « exclues ». Si l'une de ces situations correspond à la vôtre, traitez la pagination comme une correction prioritaire plutôt que comme un chantier pour plus tard. Plus tôt une chaîne de canoniques cassée est corrigée, plus vite les pages profondes reviennent dans l'index.
Une courte liste de contrôle de pagination avant lancement
Avant de livrer le moindre changement à un modèle paginé, passez en revue une courte liste de validation plutôt que de vous fier à votre mémoire. Chaque page porte-t-elle une canonique auto-référencée, confirmée en affichant réellement la source de trois pages, et pas seulement de la page 1 ? La commande « suivant » a-t-elle un vrai href, visible dans la source de la page avec JavaScript désactivé ? La page 2 renvoie-t-elle vers la page 1, et la chaîne tient-elle jusqu'à la dernière page ? Les variantes d'URL filtrées et triées sont-elles bloquées pour l'indexation plutôt que laissées ouvertes par défaut ? Le numéro de page est-il dans le chemin ou dans un paramètre de requête, jamais après un # ? Répondre oui aux cinq permet de repérer l'écrasante majorité des erreurs de pagination avant leur mise en ligne, plutôt que de les découvrir trois semaines plus tard dans un rapport Search Console, une fois le mal fait.
Questions fréquentes
Google utilise-t-il encore rel="next" et rel="prev" pour la pagination ?
Non. Google a confirmé le 21 mars 2019 qu'il avait cessé d'utiliser ces balises et qu'il les ignorait déjà depuis un moment avant cette annonce. Il traite désormais chaque page paginée comme une page ordinaire, en s'appuyant plutôt sur le maillage interne et les balises canoniques. Certains autres moteurs de recherche peuvent encore lire ces balises, mais elles ne sont plus nécessaires pour Google.
Faut-il mettre les pages paginées en noindex ?
En général, non. Mettre une page paginée en noindex la retire entièrement de l'index, ce qui peut masquer du contenu unique, produits, articles, messages, qui n'existe que sur cette page précise. Gardez les pages paginées indexables avec des balises canoniques auto-référencées, et réservez noindex aux variantes réellement peu utiles, comme les URL filtrées ou triées.
Le défilement infini est-il mauvais pour le SEO ?
Le défilement infini n'est pas intrinsèquement mauvais pour le SEO, mais il est risqué sans travail supplémentaire. Si le contenu se charge dynamiquement sur une seule URL sans liens explorables en dessous, les moteurs de recherche risquent de ne jamais en découvrir la majeure partie. Associer le défilement infini à de vraies URL adressables pour chaque segment (et mettre à jour la barre d'adresse pendant le défilement) comble cet écart.
Quelle est la différence entre la pagination et une page « tout afficher » ?
La pagination répartit le contenu sur plusieurs URL ; une page « tout afficher » met tout sur une seule URL, avec souvent les pages paginées qui ont pour canonique cette page. Les pages « tout afficher » peuvent consolider les signaux de classement, mais elles exigent une forte optimisation des performances. Une page lente avec des centaines d'éléments peut nuire davantage à l'expérience utilisateur et aux signaux de vitesse de page que ne l'aurait fait la pagination.
À partir de combien de pages paginées en a-t-on trop pour le SEO ?
Il n'y a pas de limite fixe, mais une pagination très profonde (des centaines de pages dans une même série) augmente le budget d'exploration dépensé sur du contenu quasi dupliqué. Des techniques comme la pagination par point médian affichent des liens de pages du type 1, 2, 3 … 9, 10, 11 au lieu de chaque numéro. Cela réduit la profondeur d'exploration vers les pages éloignées et garde la structure de liens gérable sans sacrifier l'accessibilité.
Corriger la pagination commence par voir toute la chaîne
Les problèmes de pagination s'annoncent rarement. Ils se manifestent par des pages qui ne sont plus indexées, des catégories qui ne se classent plus et des rapports d'exploration que personne n'a pris le temps de lire de près. La solution est rarement une refonte. C'est généralement une balise canonique pointée dans le mauvais sens, une balise noindex qui ne devrait pas être là, ou un bouton « page suivante » sans vrai lien derrière.
Si vous voulez voir précisément lesquelles de ces erreurs de pagination votre propre site commet, contactez l'équipe et obtenez un exemple de rapport SEO construit autour de votre site réel.
Ressources / Références
Sources
- Pagination Best Practices for Google | Google Search Central
- Pagination
- API Design Basics: Pagination
- Pagination.com - The fastest path from data to documents
Avertissement : cet article constitue une information générale sur des règles et des chiffres en vigueur à la date de sa rédaction, et non un conseil financier, fiscal ou d'investissement personnalisé. Il ne tient pas compte de vos revenus, de vos obligations, de votre tolérance au risque ni de vos objectifs, et les taux et les seuils évoluent. Vérifiez la situation actuelle auprès de l'autorité compétente, et consultez un conseiller agréé ou un comptable qualifié avant d'agir.
À propos de l'auteur
SearchBlueprint a recherché, rédigé et noté cet article avec la chaîne de production de contenu que nos clients utilisent sur leurs propres sites. La note affichée dans la signature est celle que notre moteur de contenu a attribuée à cette page avant sa publication. Rien ici n'est relu à la main, et c'est tout l'intérêt : c'est le résultat du produit, publié là où chacun peut le vérifier.