Qu'est-ce que l'indexation par les moteurs de recherche et comment fonctionne-t-elle (et pourquoi certaines pages sont ignorées)
Par Toy Wen Da, Cofondateur · Mis à jour le · 21 min de lecture
Traduit de l'original en anglais. Lire en anglais
Qu'est-ce que l'indexation par les moteurs de recherche et comment fonctionne-t-elle ? C'est le processus par lequel un moteur de recherche analyse une page, stocke son contenu dans une base de données consultable et décide si elle peut apparaître dans les résultats. Sans indexation, une page n'existe pas pour Google ou Bing, quelle que soit sa qualité.

Si vous avez déjà publié une page en vous demandant pourquoi elle n'apparaît jamais sur Google, la réponse tient presque toujours à cette étape. L'exploration trouve une page. L'indexation décide de la conserver ou non. Le classement détermine sa position une fois qu'elle est dans l'index. Si l'étape du milieu échoue, le reste n'a plus d'importance.
C'est plus important que ne le pensent la plupart des propriétaires de sites. Vous pouvez réussir votre recherche de mots-clés, rédiger un article vraiment utile et n'obtenir aucun trafic si la page n'entre jamais dans l'index. Ce n'est pas un problème de classement. C'est un problème d'indexation, et il demande une autre solution.
Qu'est-ce que l'indexation par les moteurs de recherche ?
L'indexation par les moteurs de recherche est le processus par lequel un moteur analyse le contenu d'une page web et l'ajoute à son index, une base de données consultable des pages qu'il juge éligibles à l'affichage dans les résultats. C'est la deuxième des trois étapes qu'une page traverse avant de pouvoir être classée : l'exploration, l'indexation et le classement.
Pensez à une bibliothèque. L'exploration, c'est le bibliothécaire qui parcourt les rayons et note les livres présents. L'indexation consiste à cataloguer chaque livre par sujet, auteur et mot-clé pour pouvoir le retrouver en quelques secondes. Le classement décide quel livre sera remis en premier à un lecteur donné.
Être indexé ne garantit pas du trafic. Cela signifie simplement que vous êtes dans la course. Une page doit être indexée avant de pouvoir se classer sur quoi que ce soit, ce qui explique pourquoi cette étape sous-tend presque toutes les autres décisions SEO que vous prendrez, y compris les choix on-page et techniques abordés dans les fondamentaux du SEO.
Comment fonctionne l'indexation par les moteurs de recherche ?
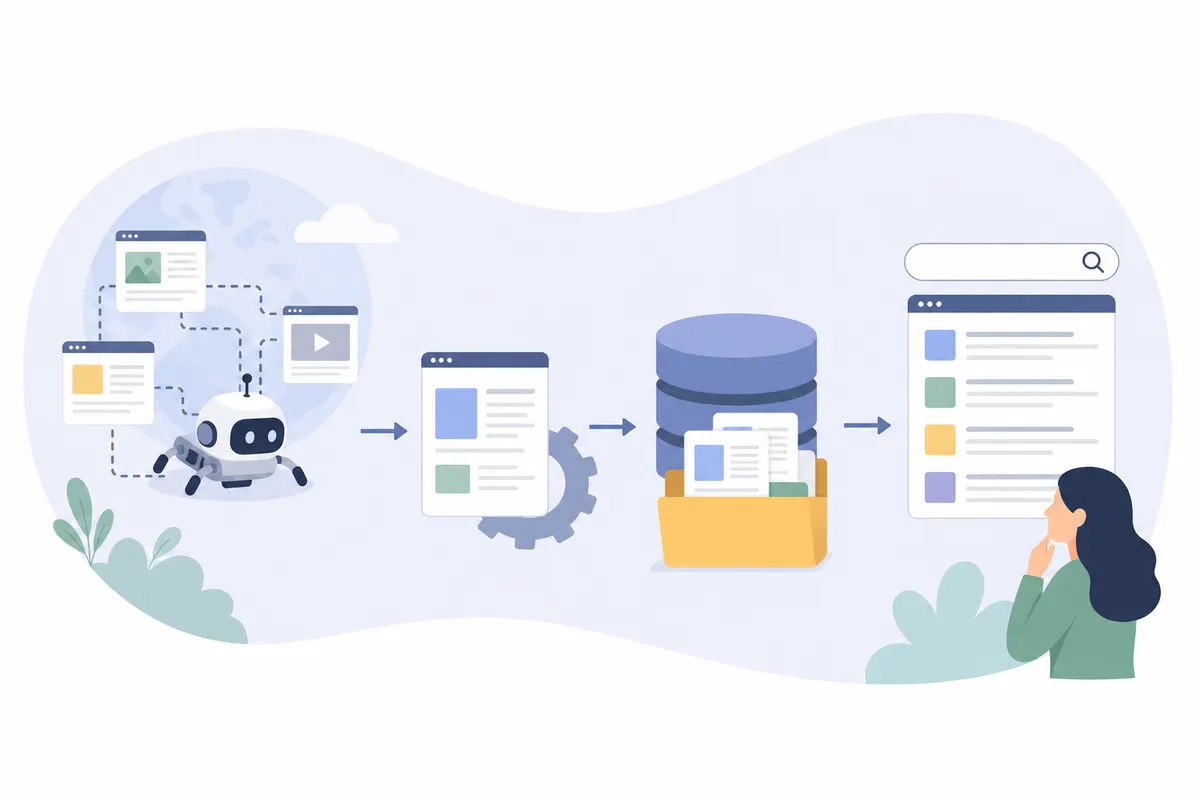
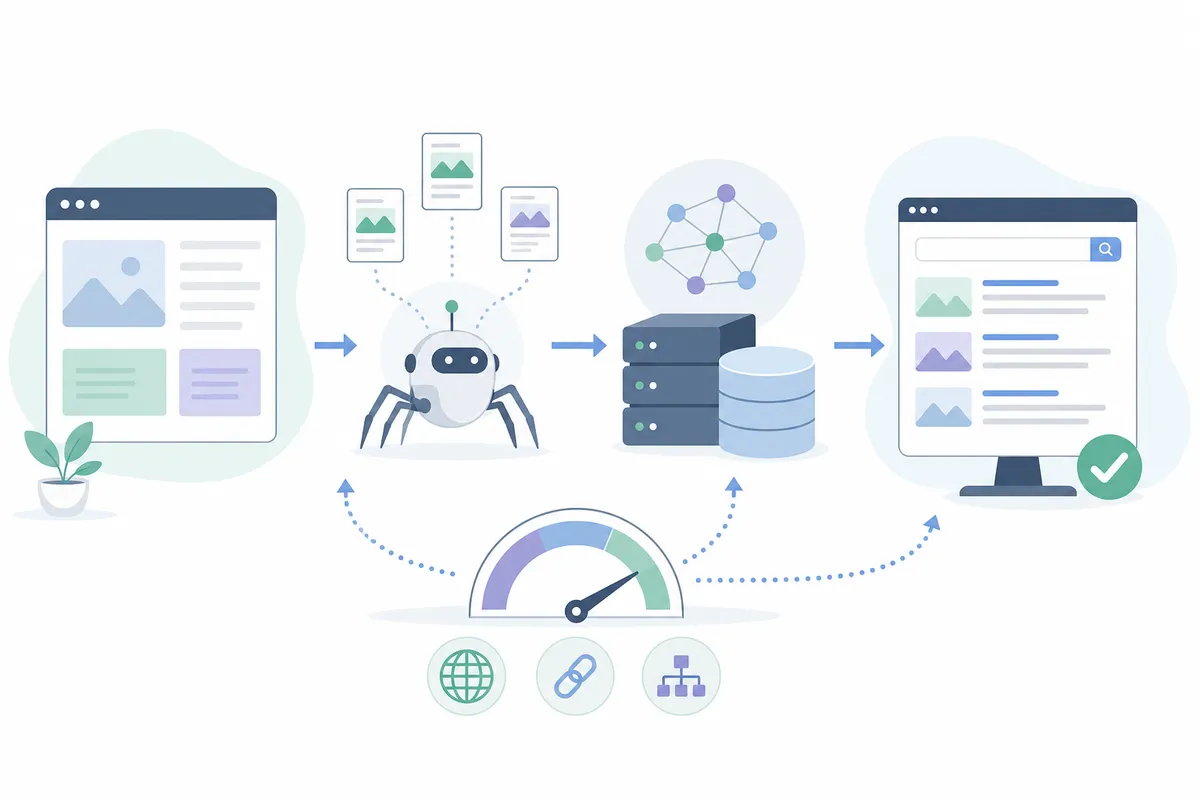
L'indexation se déroule en séquence. Un robot d'exploration trouve la page, le moteur l'affiche et l'analyse, puis décide si elle mérite une place dans l'index. Voici chaque étape dans l'ordre.
Étape 1 : l'exploration trouve la page
Pour qu'un contenu puisse être indexé, il faut d'abord qu'il soit découvert. Les moteurs de recherche utilisent des programmes automatisés, souvent appelés robots d'exploration, bots ou spiders, qui suivent les liens de page en page sur le web. Googlebot et Bingbot fonctionnent tous deux ainsi.
Un robot atteint votre page soit par un lien depuis une autre page qu'il connaît déjà, soit parce que vous avez soumis directement l'URL via un sitemap ou un outil comme Google Search Console. Les nouvelles pages sans aucun lien entrant et sans entrée dans un sitemap peuvent rester indéfiniment non découvertes.
Étape 2 : affichage et analyse
Lorsqu'un robot arrive sur une page, le moteur de recherche l'affiche à peu près comme le ferait un navigateur, en chargeant le HTML, le CSS et le JavaScript pour voir la page finale. Selon Google Search Central, les systèmes de Google affichent le contenu de la page et prennent note de signaux clés, des mots-clés à la fraîcheur, avant de décider quoi en faire.
Durant cette étape, le moteur lit le texte de la page, la balise title, les titres, le texte alternatif des images, les liens internes et les données structurées. Il vérifie aussi la présence de contenu dupliqué, de contenu pauvre et de signaux techniques comme les balises canoniques. C'est à ce stade que la qualité des métadonnées commence à compter : les signaux présentés dans l'importance réelle des métadonnées pour le SEO influencent directement la façon dont un moteur classe la page.
Étape 3 : l'indexation stocke ce qui compte
Si le moteur de recherche estime que la page apporte assez de valeur unique, il stocke l'URL de la page et ses signaux de contenu dans l'index. C'est l'étape d'indexation à proprement parler : le contenu fait désormais partie de la base de données consultable.
Durant cette étape, Google détermine aussi la canonicalisation. Si plusieurs URL affichent un contenu quasi identique, Google les regroupe et choisit une version canonique pour représenter le groupe dans les résultats de recherche. Les autres sont conservées comme versions alternatives, mais n'apparaissent généralement pas de façon indépendante dans les résultats.
Étape 4 : le classement décide de ce qui s'affiche
Être indexée ne signifie pas qu'une page apparaît pour toutes les requêtes pertinentes. Le classement est le processus distinct et continu qui consiste à noter les pages indexées par rapport à une requête précise et à les ordonner dans les résultats. Une page peut rester des mois dans l'index sans jamais atteindre la première page pour son mot-clé cible.

Exploration, indexation et classement : pourquoi la distinction est importante
Ces trois étapes sont souvent confondues dans la conversation courante, mais ce sont des processus bien distincts, avec des points de défaillance différents. Une page « explorée » a simplement été visitée. Une page « indexée » a été stockée et jugée digne d'être conservée. Une page qui « se classe » est en compétition pour une requête précise.
| Étape | Ce qui se passe | Qui/quoi l'exécute | À quoi ressemble un échec |
|---|---|---|---|
| Exploration | Le robot découvre et visite l'URL | Googlebot, Bingbot ou d'autres robots d'exploration | URL jamais visitée ; aucun lien ni entrée de sitemap ne pointe vers elle |
| Indexation | Le contenu est analysé et stocké dans l'index | Les systèmes d'indexation du moteur de recherche | Page explorée, mais marquée « Explorée, actuellement non indexée » (Crawled – currently not indexed) |
| Classement | Les pages indexées sont notées et ordonnées pour une requête | Algorithme de classement, appliqué à chaque recherche | Page indexée mais reléguée en page 5 ou plus pour son mot-clé cible |
Une page peut être explorée sans être indexée. C'est beaucoup plus rare, mais une page peut même être indexée sans avoir été entièrement explorée récemment, si Google dispose déjà de données plus anciennes à son sujet. Garder ces étapes bien séparées dans votre tête facilite beaucoup le diagnostic : vous cessez de traiter « elle ne se classe pas » et « elle n'est pas indexée » comme un seul et même bug.
Qu'est-ce qu'un index de moteur de recherche ?
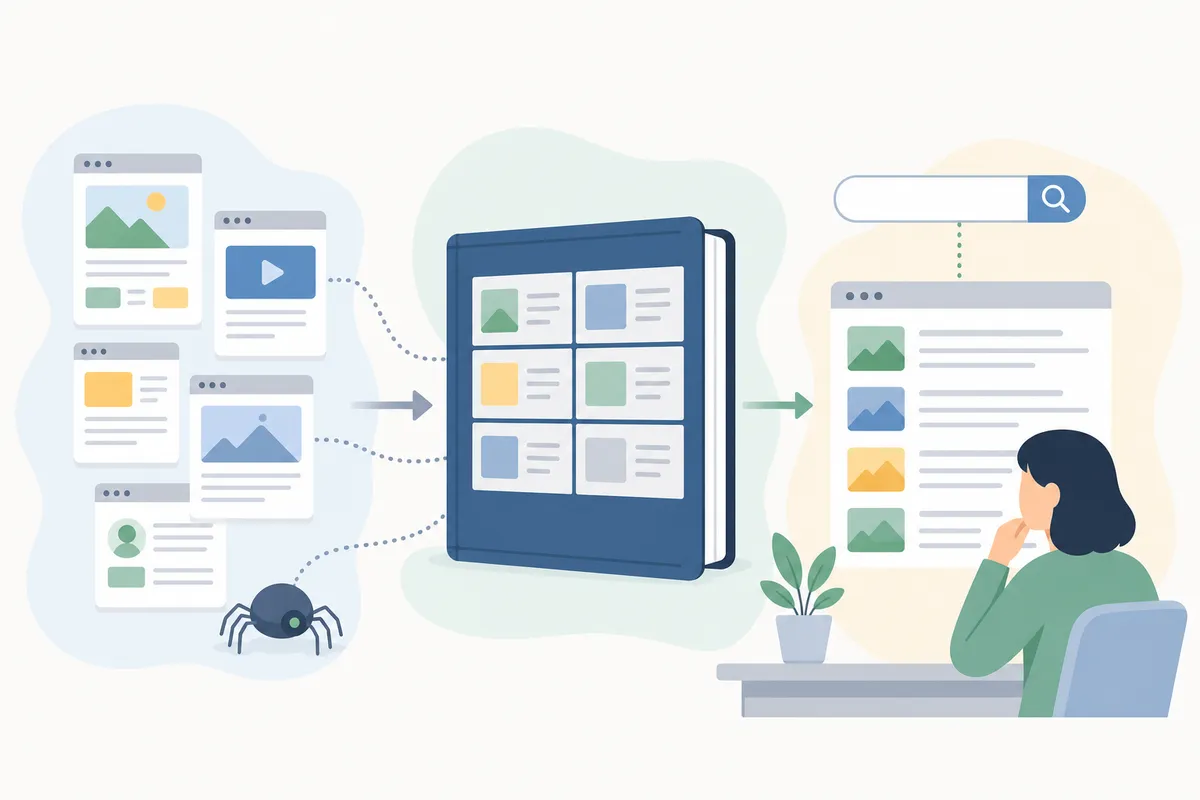
Un index de moteur de recherche est l'énorme base de données, mise à jour en continu, qu'un moteur construit en explorant les pages web et en stockant des informations à leur sujet. C'est ce que le moteur interroge réellement lorsque vous saisissez une requête, et non l'internet en direct.
Quand vous lancez une recherche, le moteur ne parcourt pas le web en temps réel. Il puise les correspondances dans cet index préconstruit, ce qui explique que les résultats arrivent en une fraction de seconde alors que des milliards de pages sont en jeu. L'index contient l'URL de la page, un résumé de son contenu et des métadonnées comme la langue, la pertinence géographique et la compatibilité avec les mobiles.
Sans ce catalogue stocké, il serait impossible de renvoyer un résultat pertinent à une requête en un temps proche du temps réel. Chaque grand moteur de recherche, Google, Bing et les plus petits, maintient sa propre version de cette structure, et figurer dans l'un ne vous fait pas automatiquement figurer dans un autre.
Qu'est-ce qu'un index inversé ?
Un index inversé est la structure de données que les moteurs de recherche utilisent pour rendre cette consultation instantanée possible. Au lieu d'organiser les données par page, « cette page contient ces mots », un index inversé retourne la logique et organise par mot : « ce mot apparaît dans ces pages ».
Ce renversement est ce qui rend la recherche rapide. Quand vous cherchez « meilleures chaussures de running » (« best running shoes »), le moteur ne parcourt pas chaque page pour y vérifier la présence de ces mots. Il cherche « best », « running » et « shoes » dans l'index inversé et récupère instantanément la liste des pages déjà associées à chaque terme, puis en fait l'intersection et les classe.
Cette structure est l'une des raisons essentielles pour lesquelles la recherche paraît instantanée, même à l'échelle du web moderne. C'est aussi pourquoi la pertinence des mots-clés reste importante : si les mots de votre page n'ont jamais été associés aux bonnes entrées de cet index inversé, elle n'apparaîtra pas pour la requête, même si elle est par ailleurs bien indexée. Un contenu clair et bien structuré, du type de celui décrit dans un guide pratique du SEO on-page, fournit à l'index un langage propre à exploiter.

L'indexation mobile-first : pourquoi la version vue par Googlebot compte
Depuis 2023, Google indexe par défaut la version mobile d'une page et non la version desktop, un changement qu'il appelle l'indexation mobile-first. L'équipe Search Central de Google a confirmé sur son blog officiel que la migration était pour l'essentiel terminée sur l'ensemble du web, ce qui signifie que Googlebot Smartphone est désormais le robot principal utilisé pour construire l'index de pratiquement tous les sites, l'ancien robot desktop étant réservé à un petit nombre d'exceptions.
Cela compte parce que ce qui est indexé, c'est ce que contient réellement la version mobile, et non ce que voit un visiteur sur ordinateur. Une erreur courante et coûteuse : masquer du contenu derrière un accordéon ou un onglet mobile est généralement sans problème et ce contenu est quand même indexé, mais un contenu absent du HTML mobile, comme une navigation réduite, des descriptions de produits raccourcies ou des données structurées ajoutées uniquement au modèle desktop, n'est tout simplement pas là pour que Google l'indexe.
Les sites qui utilisent encore un sous-domaine mobile distinct, généralement avec le préfixe m., courent un risque supplémentaire. Si les versions mobile et desktop ne sont pas correctement reliées par des balises rel=alternate et rel=canonical concordantes, Google peut finir par indexer la mauvaise version, ou les traiter comme des doublons et en abandonner une, soit le même conflit de canonicalisation évoqué plus haut, simplement déclenché par le type d'appareil plutôt que par des paramètres d'URL.
La solution pratique est simple : utilisez un design responsive, de sorte qu'il n'y ait qu'un seul document HTML et une seule URL par page, ce qui élimine entièrement le décalage mobile/desktop comme source de problèmes d'indexation. Pour les sites qui ne peuvent pas abandonner rapidement un modèle mobile distinct, la meilleure solution suivante consiste à vérifier que la version mobile contient tous les éléments que vous voulez voir indexés : texte, images avec texte alternatif et données structurées.
Quelle est la taille de l'index ? Les chiffres de Google et de Bing
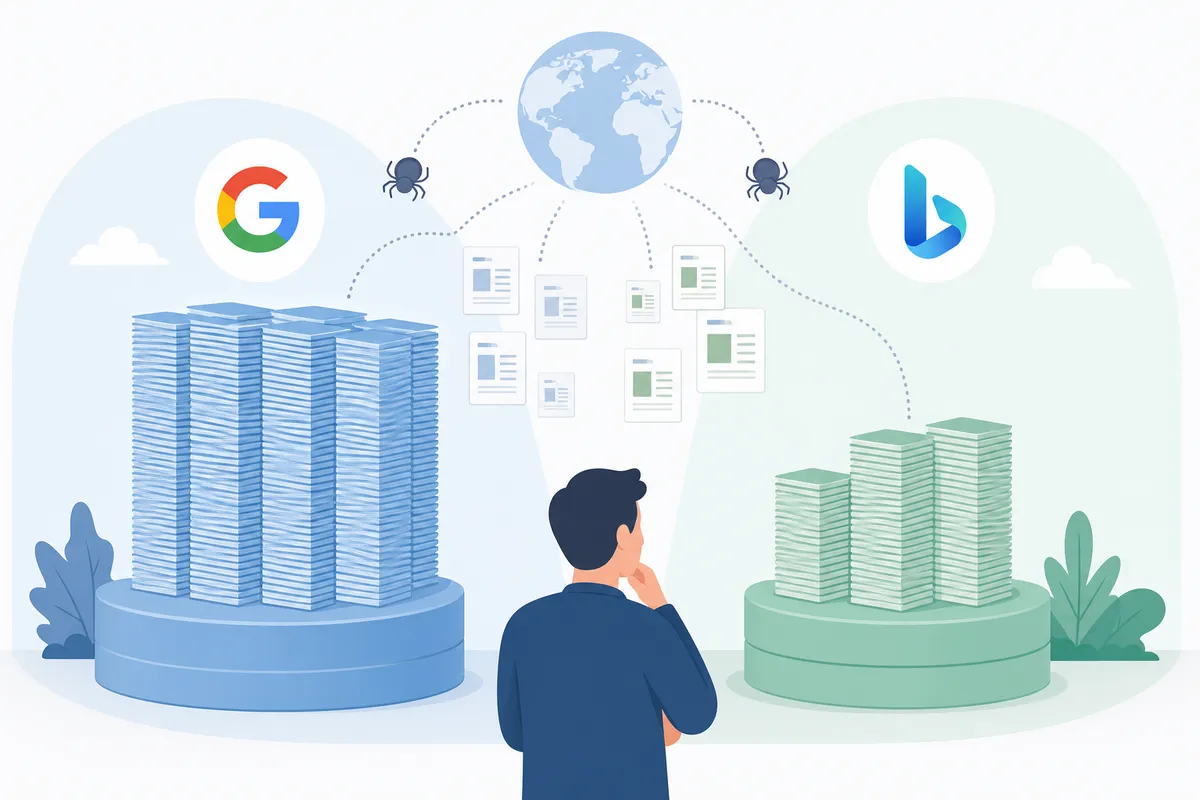
Il est difficile de se représenter ce que contient réellement « l'index » sans avoir une idée de l'échelle. Le document explicatif How Search Works de Google indique que son index contient des centaines de milliards de pages web et pèse bien plus de 100 000 000 gigaoctets au total, construit à partir de systèmes fonctionnant dans des centres de données du monde entier. Ce chiffre n'est pas figé ; Google a déclaré que l'index est reconstruit en continu à mesure que des pages sont ajoutées, mises à jour ou supprimées, ce qui explique en partie qu'une page puisse en disparaître sans aucune action du propriétaire du site, point abordé dans la FAQ ci-dessous.
Microsoft ne publie pas de chiffre aussi précis pour Bing, mais le Webmaster Blog de Bing a décrit son index comme contenant des dizaines de milliards de pages, construit à partir de son propre robot, Bingbot, et de données partagées via des partenariats, notamment les données de recherche qui alimentent les résultats web de Yahoo et de DuckDuckGo pour les requêtes où DuckDuckGo ne s'appuie pas sur sa propre exploration.
L'écart d'échelle entre les deux index est l'une des raisons pour lesquelles une page peut être tranquillement indexée sur Bing tout en restant absente de Google, ou l'inverse. Chaque moteur utilise son propre robot, ses propres filtres de qualité et son propre index ; figurer dans l'un ne vous fait pas figurer dans l'autre, et un diagnostic qui ne vérifie que Google Search Console peut passer complètement à côté d'un problème d'indexation propre à Bing.
Pourquoi l'indexation par les moteurs de recherche compte pour le SEO
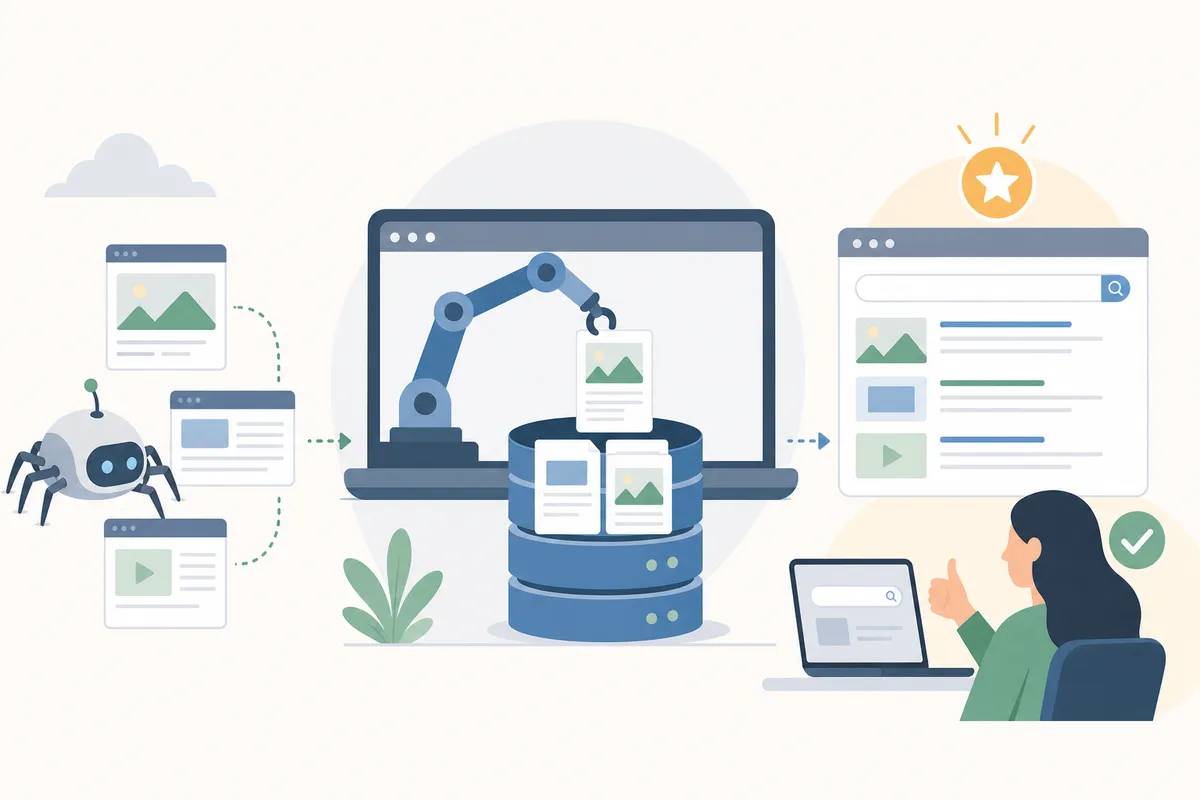
Si une page n'est pas indexée, elle n'a aucune chance de se classer, aucune chance d'apparaître dans un AI Overview et aucune chance de générer du trafic organique. Toutes les autres tactiques SEO, backlinks, ciblage de mots-clés, qualité du contenu, ne commencent à porter leurs fruits qu'après l'indexation.
C'est pourquoi les problèmes d'indexation comptent souvent parmi les erreurs les plus coûteuses d'un site. Une entreprise peut passer des semaines à produire du contenu, le publier et ne jamais remarquer qu'il est invisible pour les moteurs de recherche jusqu'à ce que quelqu'un vérifie. Le suivi de l'état de l'indexation doit se faire en parallèle de la production de contenu, et non après, ce qui explique en partie pourquoi un plan d'action SEO structuré sur 90 jours inclut généralement une vérification de l'indexation comme jalon précoce, et non comme une réflexion après coup.
L'indexation agit aussi comme un filtre de qualité. Google a clairement dit qu'il n'ajoute à l'index que les pages ayant une véritable valeur ; les pages qui pratiquent le bourrage de mots-clés, les schémas de liens de mauvaise qualité ou le contenu pauvre et dupliqué ont tendance à être signalées ou simplement ignorées. Les mises à jour d'algorithme, en particulier les core updates de Google, réévaluent périodiquement quelles pages d'un site méritent de rester indexées. Si une grande part des pages d'un site ne passe pas ce seuil, Google peut aussi réduire l'exploration et l'indexation du reste du site, ce qui explique en partie pourquoi une poignée de pages faibles peut tirer vers le bas la visibilité de tout un domaine.
Pourquoi des pages sont ignorées : les causes courantes d'échec de l'indexation
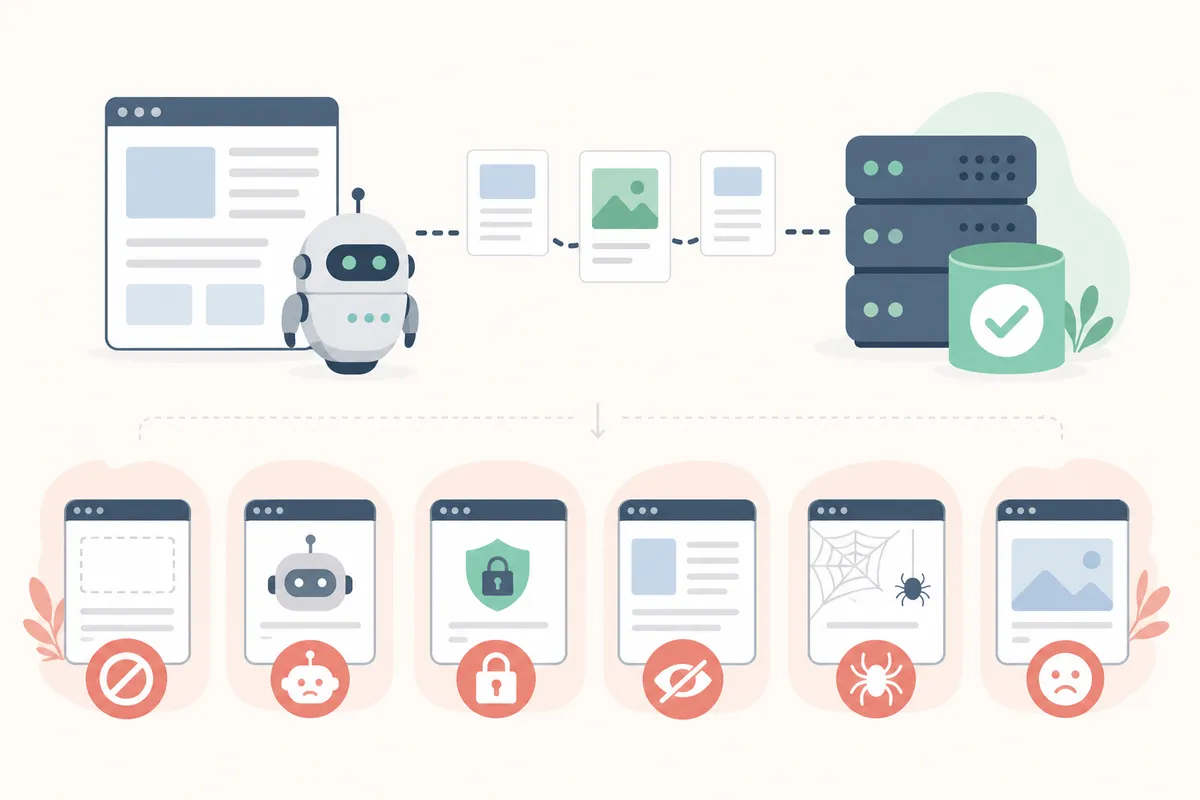
Les pages ne sont pas ignorées au hasard. Il y a presque toujours une raison précise et identifiable, et la plupart tiennent dans une courte liste de coupables récurrents.
Contenu pauvre ou dupliqué
Les pages à faible valeur unique, comme les fiches produits courtes reprenant le texte du fabricant, les pages de localisation quasi identiques ou les filtres générés automatiquement, sont la cause la plus fréquente pour laquelle Google choisit de ne pas indexer une page. Le contenu existe, le robot l'a vu, mais le moteur a décidé qu'il ne valait pas la peine d'être stocké séparément.
Balises noindex et blocages robots.txt
Une balise meta ou un en-tête noindex dit directement au moteur de recherche : n'indexez pas cette page. Ces balises sont constamment laissées sur des pages par accident : une balise d'un site de préproduction jamais retirée avant le lancement, ou un réglage par défaut du CMS qui met discrètement certains types de pages en noindex. Une règle disallow du fichier robots.txt a un effet voisin mais différent : elle peut bloquer entièrement l'exploration, ce qui empêche l'indexation par extension. Le protocole d'exclusion robots.txt n'est d'ailleurs pas qu'une simple convention informelle ; l'IETF l'a formellement normalisé en 2022 sous la référence RFC 9309, ce qui explique que les robots conformes de différents moteurs respectent tous la même syntaxe disallow.
Budget d'exploration et taille du site
Les moteurs de recherche allouent une attention d'exploration limitée à chaque site, en fonction approximativement de sa taille, de sa fréquence de mise à jour et de la santé des réponses de son serveur. Sur de très grands sites, les pages de faible valeur peuvent consommer un budget d'exploration qui devrait aller aux pages que vous voulez réellement voir indexées, laissant certaines pages rarement explorées, voire jamais.
Pages riches en JavaScript et applications monopages
Les moteurs de recherche savent afficher le JavaScript, mais c'est une étape plus lente et plus gourmande en ressources que la lecture d'un HTML simple, et elle ne réussit pas toujours proprement. Un contenu qui n'apparaît qu'après l'exécution de JavaScript côté client, fréquent dans les applications monopages, peut être manqué ou indexé avec un délai. C'est un mode de défaillance bien documenté ; consultez pourquoi les applications monopages disparaissent de Google pour les mécanismes en détail.
Conflits de canonicalisation
Lorsqu'une page porte une balise canonique pointant vers une autre URL, volontairement ou par erreur, Google indexe généralement la version canonique plutôt que celle qu'il a explorée. Une balise canonique mal configurée peut discrètement écarter de l'index une page par ailleurs bonne, au profit de la mauvaise URL.
| Raison pour laquelle des pages sont ignorées | Ce que l'on voit dans la Search Console | Solution habituelle |
|---|---|---|
| Contenu pauvre ou dupliqué | « Doublon, Google a choisi une URL canonique différente » (Duplicate, Google chose different canonical) ou « Explorée, actuellement non indexée » (Crawled – currently not indexed) | Regrouper ou réécrire avec un contenu unique et substantiel |
| Balise noindex ou blocage robots.txt | « Exclue par la balise "noindex" » (Excluded by 'noindex' tag) ou « Bloquée par le fichier robots.txt » (Blocked by robots.txt) | Supprimer la balise ou modifier la règle disallow |
| Limites du budget d'exploration (grands sites) | « Détectée, actuellement non indexée » (Discovered – currently not indexed) | Élaguer les pages de faible valeur ; améliorer le maillage interne vers les pages prioritaires |
| Échecs d'affichage du JavaScript | Contenu absent de la version en cache/affichée | Rendu côté serveur ou prérendu du contenu clé |
| Conflits de canonicalisation | « Autre page avec balise canonique appropriée » (Alternate page with proper canonical tag) | Corriger ou supprimer les balises canoniques incorrectes |
La plupart de ces problèmes relèvent des fondamentaux du SEO technique plutôt que de la seule qualité du contenu. Si vous constatez un schéma d'exclusions touchant de nombreuses pages, il vaut la peine de passer en revue les corrections de SEO technique qui font vraiment bouger vos classements avant de supposer que le contenu lui-même est en cause.
Un exemple concret : suivre une page de sa publication à son indexation
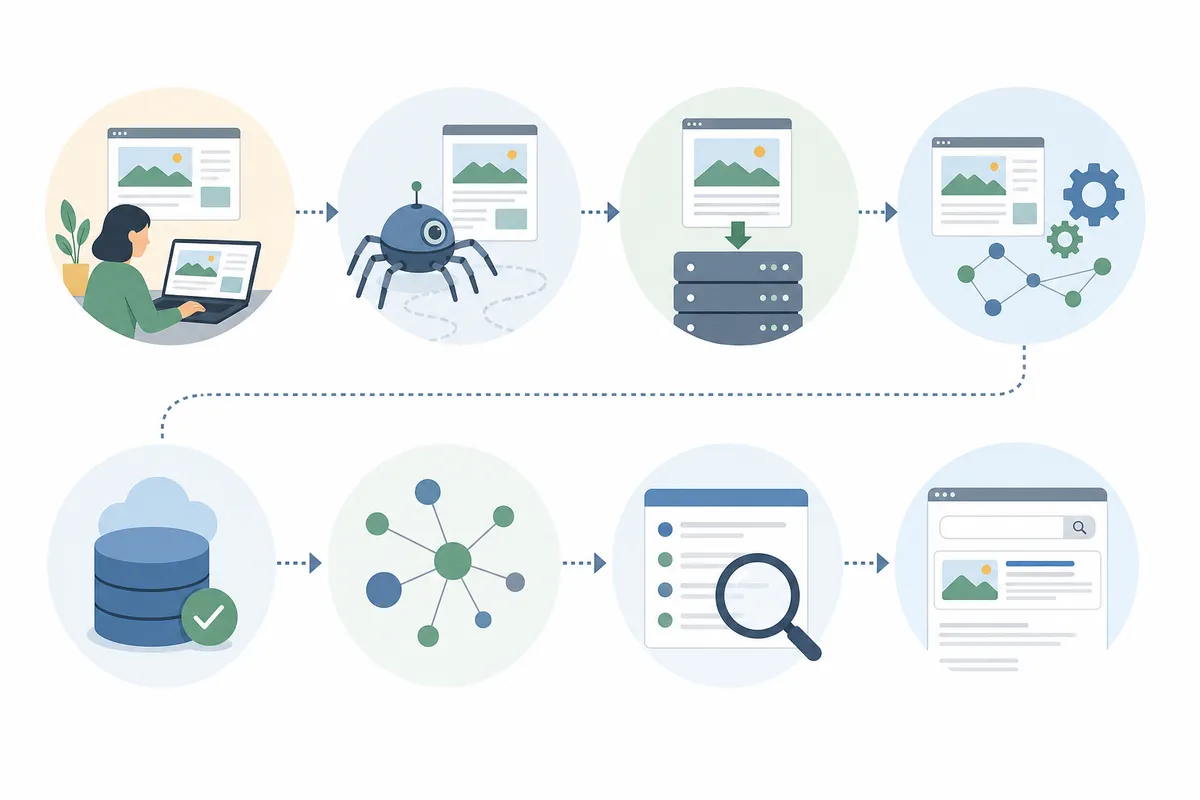
Il est utile de voir le calendrier mis en regard d'une série d'actions réelles, plutôt que de traiter l'indexation comme une boîte noire. Voici une séquence réaliste pour un nouvel article de blog sur un site établi dont l'historique d'exploration est sain :
- Jour 0 : la page est publiée. Le sitemap XML du site est configuré pour se régénérer automatiquement, si bien que la nouvelle URL est ajoutée au fichier sitemap en quelques minutes.
- Jour 0-1 : comme le site compte déjà d'autres pages qui font des liens internes vers le nouvel article, et que son sitemap se met à jour automatiquement, Googlebot découvre l'URL lors de sa prochaine exploration programmée du sitemap, généralement en moins d'un jour pour un domaine établi.
- Jour 1-3 : Googlebot explore et affiche la page. L'outil d'inspection d'URL (URL Inspection) de la Search Console, consulté manuellement au jour 2, n'indique pas encore « L'URL est sur Google » (URL is on Google), mais une exploration a bien été enregistrée.
- Jour 3-7 : la page est évaluée en termes d'unicité et de qualité par rapport au reste du contenu du site. Si elle passe cette évaluation, elle est ajoutée à l'index. Une consultation du rapport Couverture (Coverage) vers les jours 5 à 7 montrerait généralement l'URL passer de « Détectée, actuellement non indexée » (Discovered – currently not indexed) (si elle y est jamais apparue) à « Indexée » (Indexed).
- À partir du jour 7 : la page peut désormais apparaître dans les résultats de recherche et entrer en compétition pour le classement, même s'il peut falloir beaucoup plus de temps pour obtenir des positions significatives sur un terme concurrentiel ; c'est l'étape du classement, qui se déroule indépendamment de l'indexation.
Comparez maintenant avec un domaine tout neuf, sans backlinks ni historique d'exploration. La même page pourrait ne pas être découverte du tout tant qu'un sitemap n'est pas soumis manuellement via la Search Console, puisqu'il n'existe aucun schéma d'exploration établi à suivre pour Googlebot ni aucune équité de liens internes pour l'attirer. Une fois la page découverte, le délai entre l'exploration et l'indexation peut passer de quelques jours à plusieurs semaines, et les propres recommandations de Google reconnaissent que les nouveaux sites mettent généralement plus de temps à être explorés et indexés de façon régulière que ceux qui ont un historique établi.
La différence entre ces deux scénarios ne tient pas au contenu, mais à tout ce qui l'entoure : fraîcheur du sitemap, maillage interne et historique d'exploration du domaine. C'est aussi pourquoi la même action, par exemple demander l'indexation via l'inspection d'URL, donne un résultat le jour même sur un site et ne change presque rien sur un autre. L'outil ne fait que pousser la file d'attente, il ne l'emporte pas sur les signaux sous-jacents sur lesquels repose la décision d'indexation.
Pouvez-vous résoudre vous-même les problèmes d'indexation ?
Oui, dans la plupart des cas courants. Retirer une balise noindex posée par accident, corriger une règle robots.txt, soumettre un sitemap ou demander l'indexation d'une seule URL via Google Search Console, ce sont autant d'actions qu'un propriétaire de site peut réaliser sans aide spécialisée, généralement en moins d'une heure.
Le plus difficile est le diagnostic, pas l'exécution. La solution pour « Explorée, actuellement non indexée » (Crawled – currently not indexed) peut être une réécriture du contenu, une correction de balise canonique, une modification du maillage interne ou un problème de budget d'exploration, et la Search Console ne vous dira pas toujours laquelle s'applique à votre cas précis. Bien lire le rapport de couverture, et savoir quels motifs d'exclusion sont urgents et lesquels sont attendus, demande une certaine familiarité avec la manière dont les décisions d'indexation sont réellement prises.
Une approche raisonnable : traitez d'abord vous-même les corrections claires et mécaniques, comme les balises noindex, le robots.txt et la soumission du sitemap. Si des pages restent non indexées après quelques semaines sans cause évidente, c'est le moment où un audit de SEO technique plus approfondi vaut son coût.
Comment faire indexer vos pages plus vite
Aucune de ces méthodes ne force un moteur de recherche à indexer une page de mauvaise qualité ; cette décision dépend toujours du contenu et des signaux techniques. Elles suppriment en revanche le délai entre la publication et la découverte, ce qui compte beaucoup pour les contenus sensibles au temps.
Sitemaps XML
Un sitemap XML est un fichier qui liste toutes les URL de votre site que vous voulez faire connaître aux moteurs de recherche. Il sert de plan aux robots d'exploration et les oriente vers des pages qu'ils pourraient autrement manquer, surtout sur les sites vastes ou profondément imbriqués. En soumettre un ne garantit pas l'indexation, mais cela élimine entièrement le problème « le robot n'a jamais trouvé cette page ».
Pour soumettre un sitemap dans Google Search Console : ouvrez le rapport Sitemaps, cliquez sur « Add a new sitemap », saisissez l'URL du sitemap (généralement yoursite.com/sitemap.xml) et validez. Bing Webmaster Tools propose une section Sitemaps équivalente, avec la même démarche de base.
L'outil d'inspection d'URL de Google Search Console
Pour une page isolée qui demande une attention immédiate, l'outil d'inspection d'URL (URL Inspection) de Google Search Console vous permet de vérifier l'état d'indexation d'une URL précise et de demander directement une exploration. Collez l'URL, examinez les problèmes signalés et, si rien ne la bloque, vous pouvez demander l'indexation sur-le-champ.
C'est le bon outil pour « je viens de corriger une balise noindex et je veux que Google le remarque vite », pas pour soumettre des centaines d'URL en lot, ce pour quoi il n'est pas conçu.
L'Indexing API de Google
L'Indexing API de Google vous permet de notifier Google par programmation de l'existence d'URL nouvelles ou mises à jour, sans attendre l'exploration d'un sitemap ni une demande manuelle d'inspection d'URL. Google la présente comme particulièrement utile pour les sites à contenu éphémère, comme les offres d'emploi, les pages de diffusion en direct ou les listes d'événements, où la rapidité compte plus que la couverture.
Sa mise en place exige de créer un projet Google Cloud et un compte de service, de vérifier la propriété dans la Search Console et de générer un jeton d'accès, ce qui représente un effort nettement plus technique qu'un sitemap. Google recommande toujours de soumettre aussi un sitemap complet, car l'API est un complément, pas un remplacement.
Bing Webmaster Tools et IndexNow
Bing Webmaster Tools inclut sa propre fonction de soumission d'URL, qui permet de soumettre jusqu'à 10 000 URL par jour pour une exploration et une évaluation quasi immédiates. Les pages qui atteignent le niveau de qualité de Bing peuvent apparaître dans les résultats peu après la soumission.
Bing soutient aussi IndexNow, un protocole qui permet à un site de prévenir les moteurs de recherche à l'instant même où une page est publiée, mise à jour ou supprimée, plutôt que d'attendre la prochaine exploration programmée. Comme IndexNow est partagé entre les moteurs participants, une soumission par ce biais peut notifier plusieurs moteurs en un seul ping. Microsoft a décrit IndexNow comme une initiative commune développée avec Yandex, conçue spécialement pour réduire l'exploration répétée et spéculative sur laquelle les deux moteurs s'appuient autrement pour simplement remarquer qu'une page a changé.
Maillage interne et backlinks
Une page vers laquelle d'autres pages de votre site font des liens, en particulier des pages que les robots visitent déjà souvent, est plus facile à trouver et signale qu'elle mérite d'être revisitée. Les pages orphelines, qui n'ont aucun lien interne pointant vers elles, comptent parmi les plus lentes à être indexées. Auditer et combler les lacunes de maillage interne est souvent un levier plus puissant que n'importe quel outil de soumission, car c'est un signal permanent plutôt qu'un ping ponctuel.
Les backlinks externes aident aussi, puisqu'un robot qui suit un lien depuis un autre site est l'une des manières originelles de découvrir de nouvelles pages. Les signaux sociaux peuvent parfois accélérer la découverte de façon indirecte, un lien partagé est cliqué, exploré ou relayé, mais ce n'est pas un mécanisme d'indexation direct comme le sont un sitemap ou l'Indexing API.
| Méthode | Moteur(s) de recherche | Meilleur usage | Limite pratique | Rapidité habituelle |
|---|---|---|---|---|
| Sitemap XML | Google, Bing | Couverture de tout le site, découverte continue | Une soumission couvre l'ensemble du site | Quelques jours, revisité selon le calendrier d'exploration |
| Outil d'inspection d'URL | Une seule page urgente | Une URL à la fois | De quelques heures à quelques jours | |
| Indexing API | Google (officiellement pour les offres d'emploi et les diffusions en direct) | Pages éphémères qui changent fréquemment | Quota quotidien par projet | Quasi immédiat une fois en place |
| Soumission d'URL Bing | Bing | Soumission en lot de pages nouvelles ou mises à jour | Jusqu'à 10 000 URL par jour | Évaluation quasi immédiate |
| IndexNow | Bing et moteurs participants | Notification instantanée à la publication, mise à jour ou suppression | Aucun plafond quotidien fixe indiqué | Ping quasi immédiat |
Comment vérifier si vos pages sont indexées
Avant de corriger un problème d'indexation, vérifiez qu'il existe vraiment. Il y a plusieurs moyens fiables de le faire.
- Le rapport Couverture/Indexation de Google Search Console (Coverage/Indexing) indique précisément quelles URL sont indexées, lesquelles sont exclues et la raison exacte de chaque exclusion ; c'est la source de vérité la plus précise pour Google.
- L'opérateur de recherche
site:(en saisissantsite:yourdomain.com/page-urldans Google) offre une vérification rapide et approximative, même s'il est connu pour être imprécis pour obtenir des chiffres exacts. - Bing Webmaster Tools dispose de son propre rapport de couverture de l'index, parallèle à celui de Google, pour vérifier l'état propre à Bing.
- L'outil d'inspection d'URL donne une réponse définitive page par page, avec la date de la dernière exploration et les problèmes détectés, pour Google spécifiquement.
Il est important d'effectuer cette vérification régulièrement, et pas seulement une fois après le lancement, car des pages peuvent sortir de l'index plus tard à cause d'une refonte du site, d'une balise noindex introduite par accident lors d'une mise à jour de modèle, ou d'une core update qui réévalue la qualité du contenu sur l'ensemble du site.
Google, Bing et DuckDuckGo : en quoi l'indexation diffère selon le moteur

Tous les moteurs de recherche n'indexent pas le web de la même façon, et ces différences influencent la manière dont vous diagnostiqueriez une page manquante.
| Moteur | Robot propre | Index propre | Rapidité de découverte habituelle | Principal outil de soumission |
|---|---|---|---|---|
| Googlebot | Oui, des centaines de milliards de pages selon les chiffres de Google | De quelques heures à quelques semaines, selon l'autorité du site | Search Console (sitemaps, inspection d'URL, Indexing API) | |
| Bing | Bingbot | Oui, des dizaines de milliards de pages selon les chiffres de Bing | Fourchette similaire à Google, souvent plus rapide pour les petits sites via IndexNow | Bing Webmaster Tools, IndexNow |
| DuckDuckGo | Limité (DuckDuckBot) | Partiel ; combine sa propre exploration avec des résultats sous licence de Bing | Dépend de la source sous-jacente qui fait remonter la page | Pas d'outil de soumission dédié pour la plupart des résultats |
Google et Bing exploitent tous deux, dès le départ, des systèmes d'exploration et d'indexation à grande échelle, ce qui explique que les solutions de ce guide, sitemaps, audits noindex, IndexNow, s'appliquent aux deux avec seulement de légères différences d'outils. DuckDuckGo est un cas nettement différent : il a déclaré publiquement qu'une part importante de ses résultats web provient de l'index de Bing, plutôt que d'explorer et d'indexer tout le web de façon indépendante, en plus de son propre robot et de centaines d'autres sources. En pratique, cela signifie qu'une page indexée et bien classée sur Bing a beaucoup plus de chances d'apparaître sur DuckDuckGo qu'une page indexée uniquement sur Google, et qu'il n'existe aucun équivalent DuckDuckGo de la Search Console pour vérifier directement l'état.
Ce qu'il faut en retenir : si une entreprise dépend de sa visibilité sur plusieurs moteurs, et pas seulement sur Google, vérifier qu'une page est indexée sur Bing couvre plus de terrain qu'il n'y paraît, puisque cet index alimente plus d'une page de résultats. Se contenter de vérifier site:yourdomain.com sur Google en supposant que la situation est la même partout est un angle mort fréquent.
Quand faire appel à un professionnel pour l'indexation
La plupart des problèmes d'indexation ponctuels se règlent sans aide extérieure. Faites appel à un professionnel lorsque le problème dépasse une seule page : de larges pans d'un site bloqués en « Détectée, actuellement non indexée » (Discovered – currently not indexed), une migration qui a fait s'effondrer l'indexation de tout le site, ou un framework JavaScript que les robots n'ont jamais affiché correctement.
Ces situations demandent généralement quelqu'un capable de lire les logs serveur, de tester le HTML réellement affiché par rapport à ce que voit un robot, et de remonter le fil à travers un ensemble de causes possibles plutôt qu'une seule cause évidente. Si vous produisez régulièrement du nouveau contenu et voulez avoir la certitude qu'il est à la fois bien structuré et indexable dès le départ, il vaut la peine d'examiner comment votre processus de création de contenu gère la rédaction de contenu SEO qui se classe avant que le problème d'indexation ne se propage à des dizaines de pages.
Questions fréquentes
Quelle est la différence entre l'exploration et l'indexation ?
L'exploration, c'est un robot qui découvre et visite une page. L'indexation, c'est le moteur de recherche qui décide de stocker le contenu de cette page dans sa base de données. Une page peut être explorée sans jamais être indexée.
Combien de temps prend l'indexation par les moteurs de recherche ?
Cela varie beaucoup : de quelques minutes pour un site bien établi et fréquemment exploré qui utilise l'Indexing API ou IndexNow, à plusieurs semaines pour un nouveau site dont les pages reçoivent peu de liens internes ou externes.
Pourquoi Google explorerait-il ma page sans l'indexer ?
Cela signifie généralement que Google a jugé le contenu trop pauvre, trop proche d'une autre page qu'il possède déjà, ou qu'il a estimé qu'une autre URL canonique la représentait mieux. Des blocages techniques comme les balises noindex peuvent aussi en être la cause.
Soumettre un sitemap garantit-il l'indexation ?
Non. Un sitemap aide seulement les moteurs de recherche à découvrir une URL plus vite. Son indexation effective dépend toujours de la qualité du contenu et de signaux techniques comme les balises noindex ou la canonicalisation.
Une page peut-elle perdre son statut d'indexation après avoir été indexée une première fois ?
Oui. Des pages peuvent être retirées de l'index par la suite à cause de modifications de contenu, de balises noindex posées par accident, de migrations de site ou d'une réévaluation lors d'une core update de l'algorithme.
Google indexe-t-il les PDF, les images et les vidéos de la même façon que les pages web ?
Oui, avec des différences. Google peut indexer les PDF et en extraire le texte, et Google comme Bing indexent les images et les vidéos grâce à des signaux comme le texte alternatif, les noms de fichiers et le contenu de la page environnante, comme le décrit la documentation de Google sur l'indexation des images et des vidéos, plutôt qu'en comprenant visuellement le fichier comme ils analysent le texte HTML.
Combien de pages l'index de Google contient-il réellement ?
La page How Search Works de Google indique que l'index contient des centaines de milliards de pages web, même si Google ne publie pas de chiffre exact et constamment mis à jour ; ce chiffre évolue au fil des ajouts et des suppressions de pages.
Existe-t-il un moyen de voir le nombre total de mes pages indexées ?
Le rapport Pages de la section Indexation de Google Search Console est le décompte le plus fiable pour votre propre site, réparti entre URL indexées et non indexées avec un motif pour chaque exclusion. L'opérateur site: donne une estimation publique approximative, mais Google a prévenu qu'il n'est pas précis pour obtenir des chiffres exacts.
Faites diagnostiquer vos problèmes d'indexation
Comprendre ce qu'est l'indexation par les moteurs de recherche et comment elle fonctionne prend tout son sens lorsqu'on l'applique à son propre site : l'indexation est la porte que chaque page doit franchir avant de pouvoir se classer, et la plupart des sites ont au moins quelques pages discrètement bloquées derrière sans que personne ne s'en aperçoive. Le moyen le plus rapide de savoir où cela se produit sur votre site est de voir vos données réelles d'indexation et de classement réunies au même endroit. Parlez à l'équipe et obtenez un exemple de rapport qui montre exactement lesquelles de vos pages sont indexées, lesquelles sont à risque et ce qu'il vaut mieux corriger en premier.
À lire aussi : Décourager les moteurs de recherche d'indexer ce site : guide de configuration.
À lire aussi : « Détectée, actuellement non indexée » : ce que cela signifie et comment y remédier.
Sources
- How Does Search Engines Work?
- How Search Engines Work - On Digital Marketing
- How Do Search Engines Work?
- How Search Engines Work: Crawling to Ranking
Avertissement : cet article fournit des informations générales sur la santé, et non un avis médical individuel. Il ne peut pas tenir compte de vos antécédents, de vos médicaments ni des résultats d'un examen. Pour un conseil concernant vos propres symptômes, adressez-vous à un clinicien qualifié ; si les symptômes sont sévères ou s'aggravent, consultez en urgence.
À propos de l'auteur
SearchBlueprint a recherché, rédigé et noté cet article avec la chaîne de production de contenu que nos clients utilisent sur leurs propres sites. La note affichée dans la signature est celle que notre moteur de contenu a attribuée à cette page avant sa publication. Rien ici n'est relu à la main, et c'est tout l'intérêt : c'est le résultat du produit, publié là où chacun peut le vérifier.