«No se ha podido leer el sitemap»: 7 soluciones que funcionan de verdad
Por Toy Wen Da, Cofundador · · 6 min de lectura
Traducido del original en inglés. Léelo en inglés
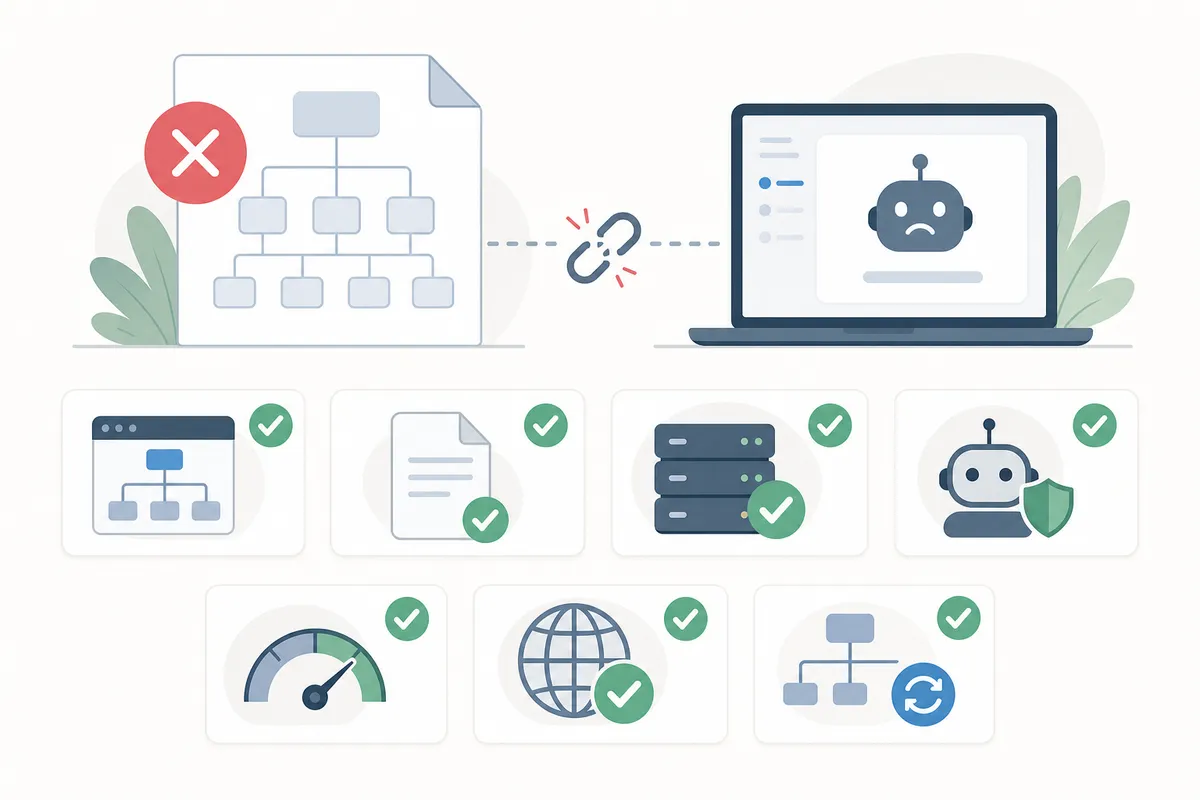
Si Google Search Console muestra «No se ha podido leer el sitemap» (Sitemap could not be read), normalmente significa que el rastreador de Google no pudo obtener o interpretar correctamente el archivo de la URL que enviaste, ya sea por una URL incorrecta, un bloqueo del servidor, un error de formato o, a veces, un fallo temporal por parte de Google. En la mayoría de los casos puedes solucionarlo en minutos en cuanto sabes dónde mirar.
Qué significa realmente «No se ha podido leer el sitemap»
El informe de Sitemaps de Google Search Console muestra dos estados de error muy parecidos: «No se ha podido obtener» (Couldn't fetch) y este. Ambos significan que Googlebot intentó solicitar tu archivo de sitemap y, o bien no obtuvo una respuesta utilizable, o bien obtuvo una respuesta que no pudo interpretar como XML válido. No es una penalización y no afecta directamente a tus posiciones. Pero sí impide que Google use el sitemap como señal de descubrimiento y de prioridad de rastreo, lo que puede retrasar la indexación de páginas nuevas o actualizadas.
Causas habituales del error «No se ha podido leer»
La mayoría de los casos se deben a una de unas pocas causas de fondo. Antes de empezar a cambiar ajustes, pasa la URL de tu sitemap por un verificador de sitemaps gratuito para ver exactamente lo que vería Googlebot; una URL incorrecta, una redirección o un XML roto suelen aparecer al instante.
| Causa | Cómo se manifiesta | Cómo confirmarlo | Solución habitual |
|---|---|---|---|
| Se envió una URL de sitemap incorrecta | Errata, subdominio equivocado o apunta al entorno equivocado | Abre la URL exacta en una ventana de navegador privada | Vuelve a enviar la URL correcta y completa |
| El servidor o el cortafuegos bloquea a Googlebot | El sitemap carga para ti, pero no para Google | Revisa en los registros del servidor si se deniega el user agent de Googlebot | Permite a Googlebot en las reglas del cortafuegos o la CDN |
| El robots.txt bloquea la ruta | El directorio del sitemap está bloqueado | Revisa si el robots.txt tiene una regla Disallow que afecte al sitemap | Elimina el bloqueo o mueve el archivo |
| XML mal formado o tipo de archivo incorrecto | Caracteres de más, etiquetas de cierre ausentes, se devuelve HTML en lugar de XML | Valida con un verificador de XML o de sitemaps | Corrige la sintaxis, vuelve a exportar y reenvía |
| Archivo demasiado grande o con demasiadas URL | El sitemap supera los 50 MB sin comprimir o las 50.000 URL | Comprueba el tamaño del archivo y el número de URL | Divídelo en varios sitemaps con un índice de sitemaps |
| Fallo temporal por parte de Google | El sitemap devuelve 200, se valida sin errores y aun así muestra el error | Vuelve a comprobarlo pasadas 24-48 horas | Reenvíalo; a menudo se resuelve sin ningún cambio |
Cómo arreglar un sitemap que no se puede leer
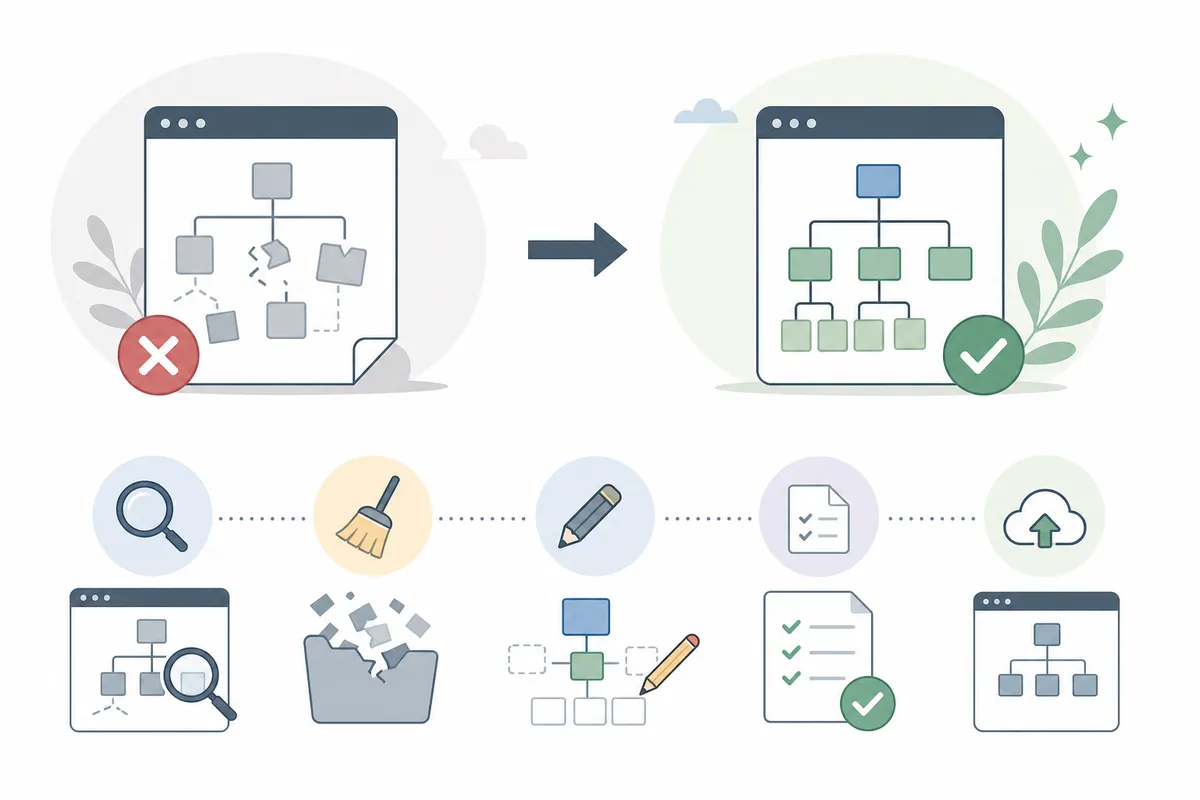
Comprueba la URL y el estado HTTP
Empieza por lo sencillo. Pega en un navegador la URL del sitemap que enviaste. Debería cargar al instante y devolver XML limpio, no una página de inicio de sesión, un 404 ni una cadena de redirecciones. Después confirma que el código de respuesta del servidor es un 200 sin más; una herramienta como httpstatus.io o la pestaña de red de tu navegador te lo mostrará. Una redirección 301 a otra URL es una causa frecuente que se pasa por alto: Google a veces no la sigue como esperarías.
Revisa el robots.txt y el acceso al servidor
Si el sitemap carga bien en tu navegador pero aun así no se obtiene, puede que algo esté bloqueando específicamente a Googlebot y no a los visitantes en general. Abre tu archivo robots.txt y asegúrate de que ninguna regla bloquee la carpeta del sitemap. Comprueba también si un cortafuegos, un servicio de protección contra bots o una contraseña de entorno de pruebas están bloqueando discretamente a los rastreadores mientras dejan pasar a las personas.
Valida la estructura del XML
Incluso un solo ampersand sin escapar o una etiqueta sin cerrar pueden hacer que un sitemap de apariencia correcta resulte ilegible para Google. Pasa el archivo por un validador de XML o por un verificador específico para sitemaps, ya que los validadores genéricos a veces pasan por alto problemas del protocolo de sitemaps que una herramienta diseñada para ello sí detecta.
Reenvía el sitemap y dale tiempo
Una vez que hayas confirmado que la URL, el código de estado y el XML están bien, elimina la entrada antigua del sitemap en Search Console y vuelve a enviarlo desde cero en lugar de limitarte a esperar. La propia documentación de Google sobre rastreo e indexación señala que el procesamiento de los sitemaps no es instantáneo y que el reprocesamiento puede tardar desde unas horas hasta un par de días.
Cuando es una falsa alarma
Si buscas este error, verás que es una queja frecuente: propietarios de sitios que confirman que su sitemap devuelve un estado 200 y pasa la validación, y aun así siguen viendo el mismo mensaje en el informe. Un hilo muy comentado de la Google Search Central Community describe exactamente esto: un sitemap válido, con funcionamiento confirmado, y aun así marcado como ilegible. Varios comerciantes de Shopify han informado del mismo patrón durante semanas, con páginas que se desindexan y envíos manuales de URL que devuelven «No referring sitemaps detected» incluso después de reenviar el sitemap varias veces.
Si has confirmado de verdad que la URL, el estado y el XML son correctos, el error puede ser un retraso en los informes y no un problema real. Reenvíalo, espera 48 horas y vuelve a comprobarlo antes de suponer que algo de tu parte está roto.
¿Puedes solucionarlo tú mismo?
Sí, en la mayoría de los casos puedes solucionar este error por tu cuenta. Comprobar una URL, leer un código de estado HTTP y validar un XML no requiere un desarrollador; una herramienta de verificación gratuita hace el trabajo técnico. Donde sí conviene buscar ayuda: catálogos grandes de comercio electrónico con sitemaps generados automáticamente, configuraciones con varias CDN en las que no es fácil saber quién está bloqueando a Googlebot, o casos en los que el error persiste más de una semana a pesar de tener un sitemap limpio y confirmado. En ese punto, alguien que pueda leer tu informe completo de Search Console junto con los registros del servidor, y que sepa cómo leer un informe SEO sin limitarse a adivinar, detectará lo que es fácil pasar por alto desde dentro de un único panel.
Preguntas frecuentes
¿Por qué Search Console dice «No se ha podido leer el sitemap» aunque mi sitemap funciona bien?
Normalmente significa que tu sitemap devuelve realmente un estado 200 y un XML válido, pero el rastreador de Google tuvo un problema temporal: un tiempo de espera agotado, un user agent bloqueado en una solicitud o un retraso en los informes. Es una queja documentada y recurrente en la Google Search Central Community, y reenviar el sitemap pasadas 24-48 horas suele resolverlo sin cambiar nada en el archivo.
¿Este error perjudica mis posiciones?
No directamente. Un sitemap es una ayuda para el descubrimiento, no un factor de posicionamiento. Pero si sigue fallando, las páginas nuevas o actualizadas pueden rastrearse e indexarse más despacio, lo que puede retrasar el posicionamiento del contenido nuevo.
¿Cuánto tarda Google en volver a obtener un sitemap después de arreglarlo?
No hay una garantía fija, pero la mayoría de los sitios ven actualizarse el estado en uno o dos días tras reenviar un sitemap corregido.
¿Puede un archivo robots.txt causar «No se ha podido leer el sitemap»?
Sí. Si el robots.txt bloquea la carpeta donde está tu sitemap, o bloquea el propio archivo del sitemap, Googlebot puede no ser capaz de obtenerlo aunque la URL cargue bien en un navegador.
¿Cuál es la diferencia entre «No se ha podido obtener» y «No se ha podido leer el sitemap»?
Son errores de obtención muy relacionados que aparecen en el mismo informe de Search Console. «No se ha podido obtener» suele apuntar a un problema de conexión o de acceso; «No se ha podido leer» apunta más a menudo a un problema de interpretación una vez que se accedió al archivo. Ambos se solucionan con las mismas comprobaciones: URL, código de estado, robots.txt y validez del XML.
Haz que revisen bien el estado de tu sitemap
Un sitemap que «no se ha podido leer» casi siempre tiene arreglo en cuanto sabes si se trata de un problema de URL, de un bloqueo, de un error de sintaxis o simplemente de que Google va con retraso. Si quieres una segunda opinión sobre tu sitemap y el resto de la salud técnica de tu sitio, habla con el equipo y consigue un informe SEO de muestra elaborado a partir de tu propio sitio.
Fuentes
Sobre el autor
SearchBlueprint investigó, escribió y puntuó este artículo con el mismo flujo de contenido que nuestros clientes usan en sus propios sitios. La puntuación que aparece junto al autor es la que nuestro motor de contenido dio a esta página antes de publicarla. Nada de esto se revisa a mano, y ese es el punto: es el resultado del producto, publicado donde cualquiera puede comprobarlo.