Cos'è l'indicizzazione nei motori di ricerca e come funziona (e perché alcune pagine vengono saltate)
Di Toy Wen Da, Co-founder · Aggiornato · 21 min di lettura
Tradotto dall'originale in inglese. Leggilo in inglese
Cos'è l'indicizzazione nei motori di ricerca e come funziona? È il processo con cui un motore di ricerca scansiona una pagina, ne salva il contenuto in un database consultabile e decide se la pagina può comparire nei risultati. Senza indicizzazione, una pagina per Google o Bing non esiste, per quanto sia valida.

Se hai pubblicato una pagina e ti sei chiesto perché non compare mai su Google, la risposta quasi sempre sta in questo passaggio. La scansione (crawling) trova una pagina, l'indicizzazione decide se conservarla e il posizionamento (ranking) decide dove si colloca una volta entrata. Se salta il passaggio di mezzo, tutto il resto non conta.
Puoi fare un'ottima ricerca di parole chiave e scrivere un articolo davvero utile, e poi non ricevere alcun traffico perché la pagina non è mai entrata nell'indice. Qui il problema non è il posizionamento ma l'indicizzazione, e serve una soluzione diversa.
Cos'è l'indicizzazione nei motori di ricerca?
L'indicizzazione nei motori di ricerca è il processo con cui un motore analizza il contenuto di una pagina web e lo aggiunge al proprio indice, un database consultabile delle pagine che considera idonee a comparire nei risultati. È la seconda delle tre fasi che una pagina attraversa prima di potersi posizionare: scansione, indicizzazione e posizionamento.
Pensa a una biblioteca. La scansione è il bibliotecario che percorre gli scaffali e annota quali libri esistono. L'indicizzazione è catalogare ogni libro per argomento, autore e parola chiave, in modo da ritrovarlo in pochi secondi. Il posizionamento è decidere quale libro consegnare per primo a un certo lettore.
Essere indicizzati non garantisce traffico: significa solo che sei in gara. Una pagina deve essere indicizzata prima di potersi posizionare per qualsiasi ricerca, ed è per questo che questo passaggio sta alla base di quasi ogni altra decisione SEO che prenderai, comprese le scelte on-page e tecniche trattate in le basi della SEO.
Come funziona l'indicizzazione nei motori di ricerca?
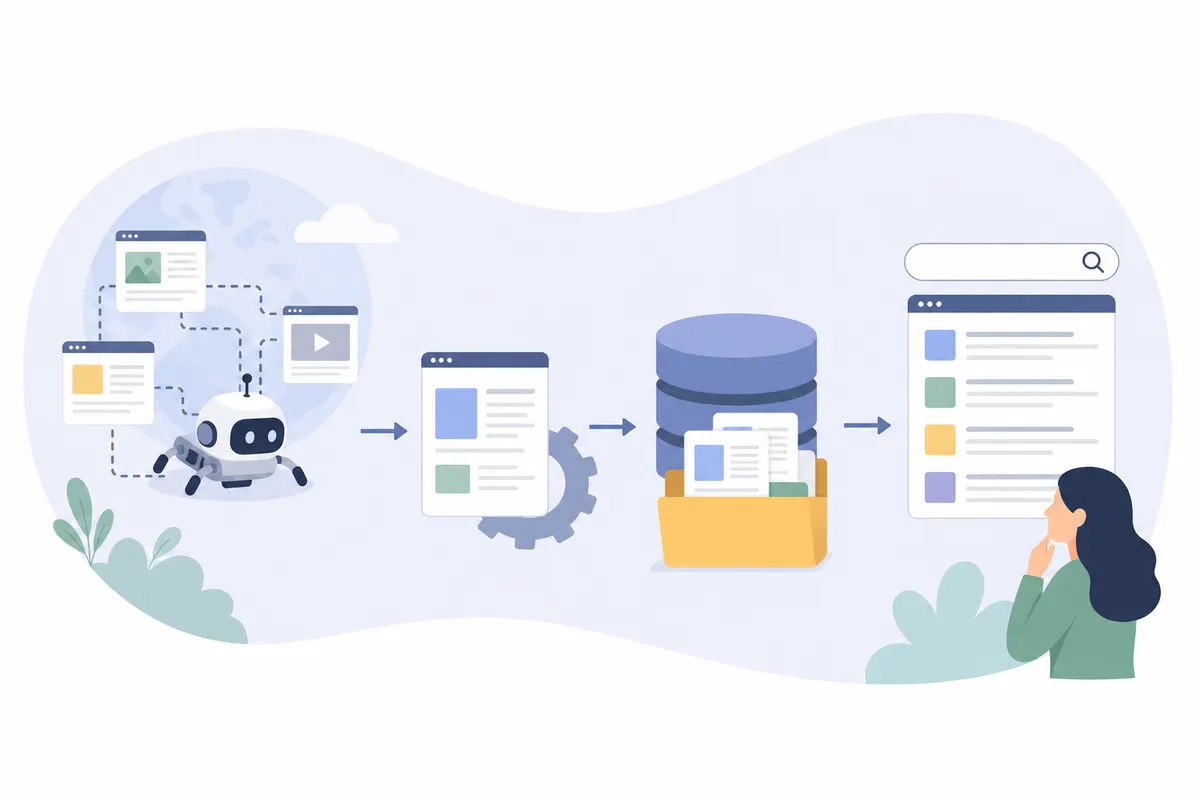
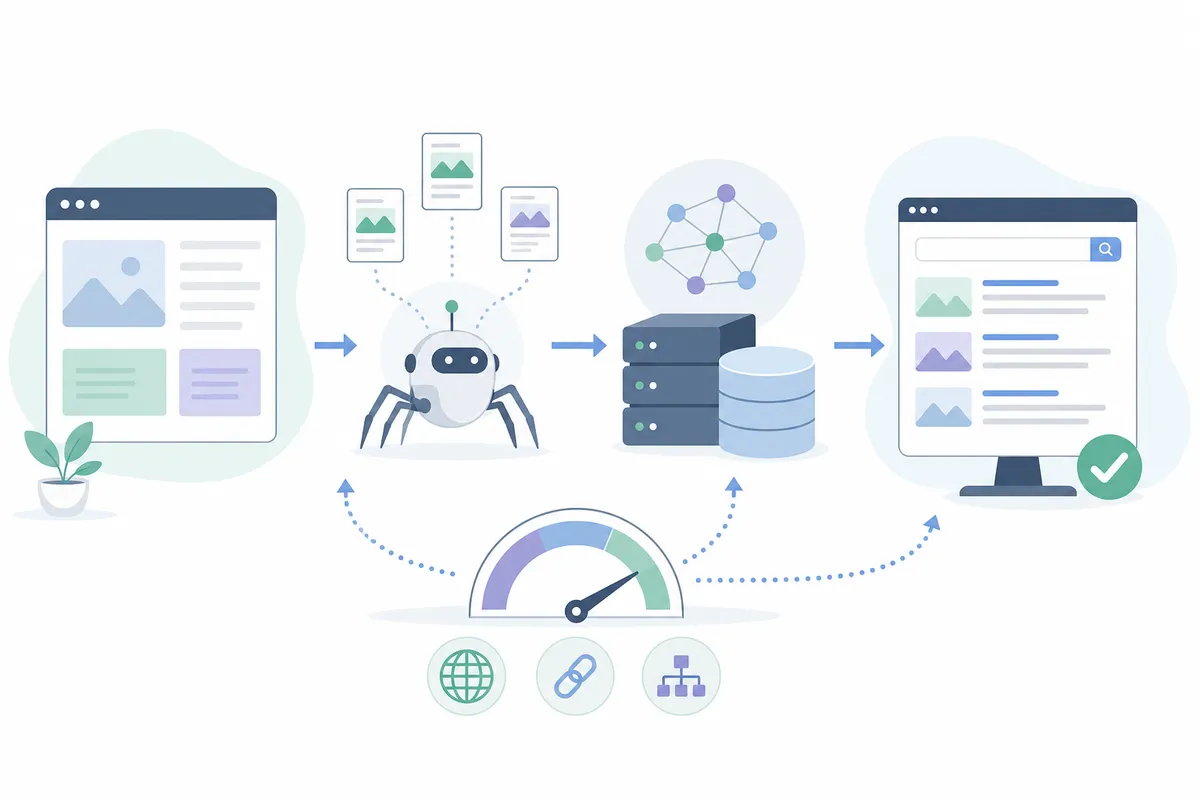
L'indicizzazione procede in sequenza. Un crawler trova la pagina, il motore di ricerca la renderizza e la analizza, quindi decide se merita un posto nell'indice.
Fase 1: la scansione trova la pagina
Prima di poter essere indicizzato, un contenuto deve essere scoperto. I motori di ricerca usano programmi automatici, spesso chiamati crawler, bot o spider, che seguono i link da una pagina all'altra in tutto il web. Googlebot e Bingbot funzionano entrambi così.
Un crawler raggiunge la tua pagina o tramite un link da una pagina che già conosce, oppure perché hai inviato l'URL con una sitemap o con uno strumento come Google Search Console. Le pagine nuove, senza link in entrata e senza una voce nella sitemap, possono restare non scoperte a tempo indeterminato.
Fase 2: renderizzazione e analisi
Quando un crawler arriva su una pagina, il motore di ricerca la renderizza più o meno come farebbe un browser, caricando HTML, CSS e JavaScript per vedere la pagina completa. Secondo Google Search Central, i sistemi di Google renderizzano il contenuto della pagina e prendono nota di segnali importanti, dalle parole chiave alla freschezza, prima di decidere cosa farne.
In questa fase il motore legge il testo della pagina, il tag title, i titoli, il testo alternativo delle immagini, i link interni e i dati strutturati. Controlla anche la presenza di contenuti duplicati, contenuti scarsi e segnali tecnici come i tag canonical. Qui la qualità dei metadati comincia a contare, e i segnali trattati in l'importanza reale dei metadati per la SEO influenzano direttamente il modo in cui un motore di ricerca classifica la pagina.
Fase 3: l'indicizzazione archivia ciò che conta
Se il motore di ricerca ritiene che la pagina abbia abbastanza valore unico, salva nell'indice l'URL e i segnali relativi al contenuto. È questo il passaggio dell'indicizzazione vera e propria: il contenuto entra a far parte del database consultabile.
In questa fase Google determina anche la canonicalizzazione. Se più URL mostrano contenuti quasi identici, Google li raggruppa e sceglie una versione canonica che rappresenti il gruppo nei risultati. Le altre vengono conservate come alternative, ma di norma non compaiono in modo autonomo.
Fase 4: il posizionamento decide cosa compare
Essere indicizzata non significa che una pagina compaia per ogni ricerca pertinente. Il posizionamento è il processo separato e continuo che assegna un punteggio alle pagine indicizzate rispetto a una specifica ricerca e le ordina nei risultati. Una pagina può restare nell'indice per mesi senza arrivare in prima pagina per la sua parola chiave di riferimento.

Scansione, indicizzazione e posizionamento: perché la distinzione è importante
Nelle conversazioni informali queste tre parole si usano come sinonimi, ma sono processi diversi, con punti di rottura diversi. Una pagina "scansionata" è stata semplicemente visitata. Una pagina "indicizzata" è stata archiviata e ritenuta degna di essere conservata, mentre una pagina che "si posiziona" sta competendo per una ricerca specifica.
| Fase | Cosa succede | Chi o cosa la esegue | Come si presenta un errore |
|---|---|---|---|
| Scansione | Il bot scopre e visita l'URL | Googlebot, Bingbot o altri crawler | L'URL non viene mai visitato; nessun link o voce di sitemap che punti a lui |
| Indicizzazione | Il contenuto viene analizzato e archiviato nell'indice | I sistemi di indicizzazione del motore di ricerca | Pagina scansionata, ma segnalata come "Crawled – currently not indexed" |
| Posizionamento | Le pagine indicizzate ricevono un punteggio e vengono ordinate per una ricerca | Algoritmo di ranking, applicato a ogni ricerca | Pagina indicizzata ma sepolta dalla pagina 5 in poi per la sua parola chiave di riferimento |
Una pagina può essere scansionata senza essere indicizzata. Molto più raramente, una pagina può persino essere indicizzata senza essere stata scansionata di recente in modo completo, se Google ha già dati più vecchi su di essa. Tenere separate le fasi rende la diagnosi molto più semplice, perché "non si posiziona" e "non è indicizzata" smettono di sembrare lo stesso problema.
Cos'è l'indice di un motore di ricerca?
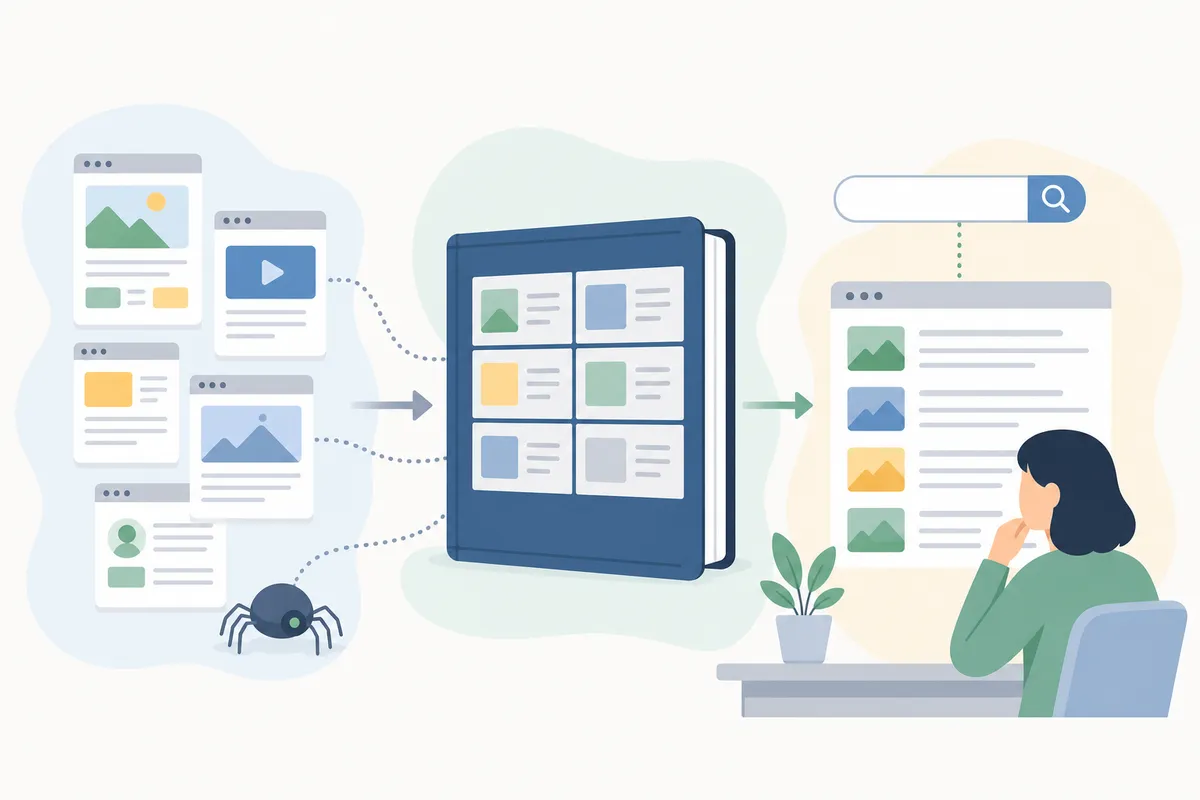
L'indice di un motore di ricerca è l'enorme database, aggiornato di continuo, che il motore costruisce scansionando e archiviando informazioni sulle pagine web. Quando digiti una ricerca, è questo che il motore consulta davvero, non il web in tempo reale.
Il motore estrae le corrispondenze da questo indice già costruito invece di scandagliare il web in tempo reale, ed è per questo che i risultati arrivano in una frazione di secondo anche con miliardi di pagine in gioco. L'indice contiene l'URL di ogni pagina, un riepilogo del suo contenuto e metadati come lingua, pertinenza geografica e ottimizzazione per i dispositivi mobili.
Ogni grande motore di ricerca mantiene una propria versione di questa struttura, e rientrare in uno non significa entrare automaticamente in un altro.
Cos'è un indice inverso?
Un indice inverso è la struttura di dati che rende possibile quella ricerca istantanea. Invece di organizzare i dati per pagina ("questa pagina contiene queste parole"), li organizza per parola: "questa parola compare in queste pagine".
Quando cerchi "migliori scarpe da corsa", il motore non scorre ogni pagina alla ricerca di quelle parole. Cerca "migliori", "da corsa" e "scarpe" nell'indice inverso, recupera l'elenco delle pagine già associate a ciascun termine, poi le interseca e le ordina.
È uno dei motivi principali per cui la ricerca sembra istantanea alla scala del web di oggi. È anche il motivo per cui la pertinenza delle parole chiave conta ancora: se le parole della tua pagina non sono mai state associate alle voci giuste, la pagina non comparirà per quella ricerca, anche se è indicizzata correttamente sotto ogni altro aspetto. Contenuti chiari e ben strutturati, come quelli descritti in una guida pratica alla SEO on-page, offrono all'indice un linguaggio pulito con cui lavorare.

Mobile-first indexing: perché conta la versione vista da Googlebot
Dal 2023 Google indicizza per impostazione predefinita la versione mobile di una pagina invece di quella desktop, un cambiamento che chiama mobile-first indexing. Il team di Google Search Central ha confermato sul suo blog ufficiale che la migrazione era sostanzialmente completata in tutto il web. Googlebot Smartphone è ormai il crawler principale usato per costruire l'indice di praticamente ogni sito, mentre il vecchio crawler desktop è riservato a un piccolo numero di eccezioni.
Viene indicizzato ciò che la versione mobile contiene davvero, non ciò che vede chi visita il sito da desktop. Nascondere contenuti dietro una fisarmonica o una scheda nella versione mobile in genere va bene e i contenuti vengono comunque indicizzati. Diverso è il caso dei contenuti lasciati completamente fuori dall'HTML mobile: navigazione ridotta, descrizioni di prodotto accorciate o dati strutturati aggiunti solo al template desktop semplicemente non ci sono, e Google non può indicizzarli.
I siti che usano ancora un sottodominio mobile separato, di solito con il prefisso m., corrono un rischio in più. Se le versioni mobile e desktop non sono collegate correttamente con i tag rel=alternate e rel=canonical corrispondenti, Google può indicizzare la versione sbagliata oppure trattare le due come duplicati ed eliminarne una. È lo stesso conflitto di canonicalizzazione trattato sopra, innescato però dal tipo di dispositivo invece che dai parametri dell'URL.
La soluzione pratica è il design responsive, così c'è un solo documento HTML e un solo URL per pagina, e la discrepanza tra mobile e desktop smette di essere una fonte di problemi di indicizzazione. Per i siti che non possono abbandonare in fretta un template mobile separato, il passo migliore successivo è verificare la versione mobile per ogni elemento che vuoi far indicizzare: testo, immagini con testo alternativo e dati strutturati.
Quanto è grande l'indice? I numeri di Google e Bing
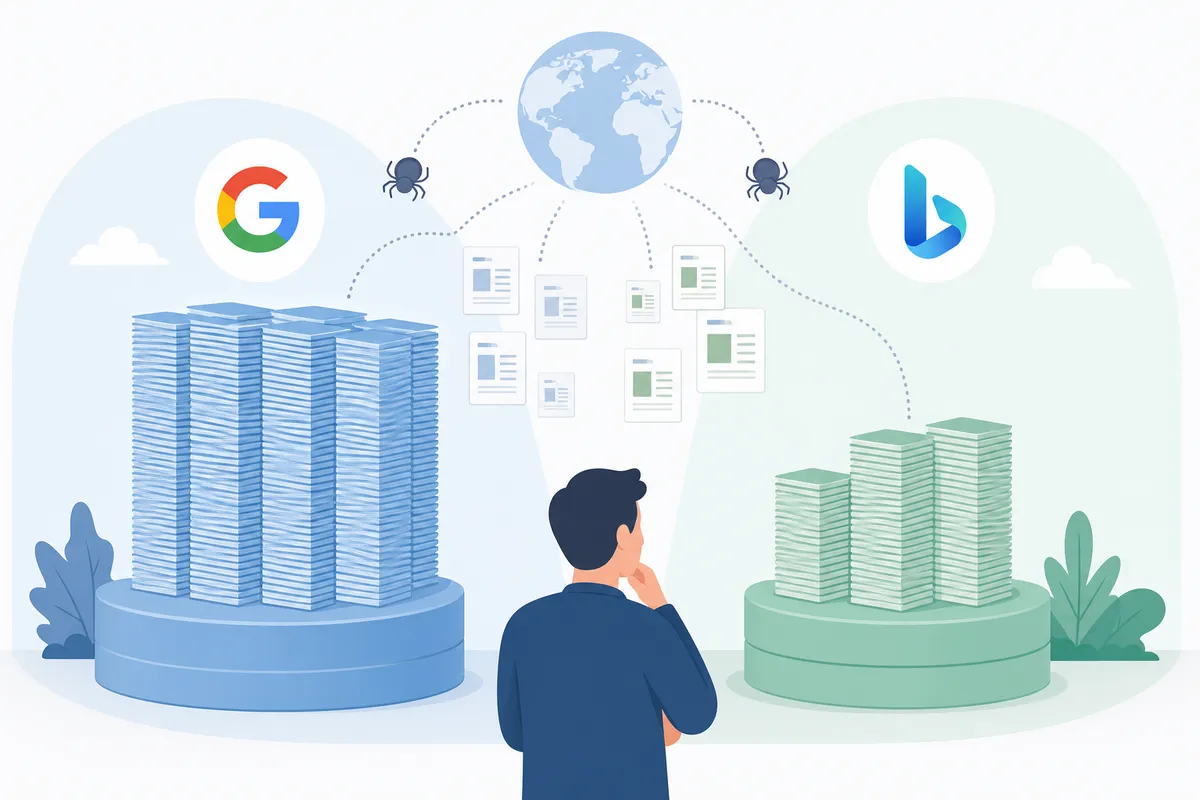
La pagina di Google How Search Works afferma che il suo indice contiene centinaia di miliardi di pagine web e ha una dimensione complessiva ben superiore a 100.000.000 di gigabyte, costruita da sistemi che girano nei data center di tutto il mondo. La cifra cambia, perché Google ha dichiarato che l'indice viene ricostruito continuamente man mano che le pagine vengono aggiunte, aggiornate o rimosse. È anche in parte il motivo per cui una pagina può uscirne senza alcuna azione da parte del proprietario del sito, come spiegano le domande frequenti qui sotto.
Microsoft non pubblica una cifra così dettagliata per Bing. Il Webmaster Blog di Bing ha descritto il proprio indice come contenente decine di miliardi di pagine, costruito dal suo crawler, Bingbot, e da dati condivisi tramite partnership. Tra queste partnership ci sono i dati di ricerca alla base dei risultati web di Yahoo e dei risultati di DuckDuckGo per le ricerche in cui DuckDuckGo non si affida alla propria scansione.
La differenza di scala è uno dei motivi per cui una pagina può essere indicizzata senza problemi su Bing e mancare su Google, o viceversa. Ogni motore ha il proprio crawler, i propri filtri di qualità e il proprio indice, quindi una diagnosi che controlla solo Google Search Console può non accorgersi affatto di un problema specifico di Bing.
Perché l'indicizzazione conta per la SEO
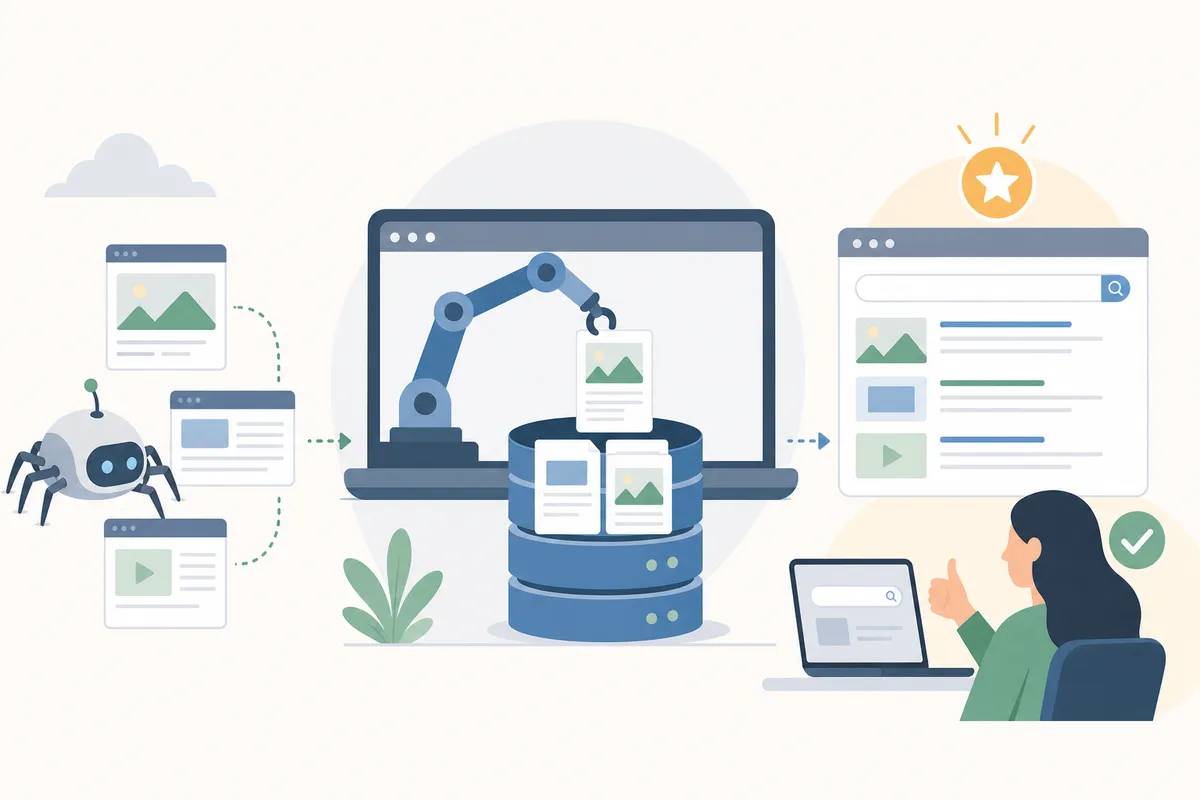
Se una pagina non è indicizzata, non ha alcuna possibilità di posizionarsi, di comparire in una AI Overview o di ottenere traffico organico. Backlink, targeting delle parole chiave e qualità dei contenuti cominciano a dare frutti solo dopo che l'indicizzazione è avvenuta.
Questo rende i problemi di indicizzazione tra gli errori più costosi di un sito. Un'azienda può passare settimane a produrre contenuti senza accorgersi che sono invisibili ai motori di ricerca finché qualcuno non controlla. Il monitoraggio dello stato dell'indice va affiancato alla produzione dei contenuti, non fatto dopo, ed è per questo che un piano d'azione SEO strutturato di 90 giorni di solito prevede un controllo dell'indicizzazione come tappa iniziale.
L'indicizzazione funziona anche da filtro di qualità. Google ha dichiarato chiaramente di aggiungere all'indice solo pagine con un valore autentico, quindi le pagine con keyword stuffing, schemi di link di bassa qualità o contenuti scarsi e duplicati tendono a essere segnalate o saltate. Gli aggiornamenti core rivalutano periodicamente quali pagine di un sito valga la pena mantenere indicizzate. Se una grossa parte delle pagine di un sito non supera la soglia, Google può ridurre la scansione e l'indicizzazione anche del resto del sito, ed è uno dei motivi per cui poche pagine deboli possono trascinare giù la visibilità di un intero dominio.
Perché le pagine vengono saltate: i motivi più comuni per cui l'indicizzazione fallisce
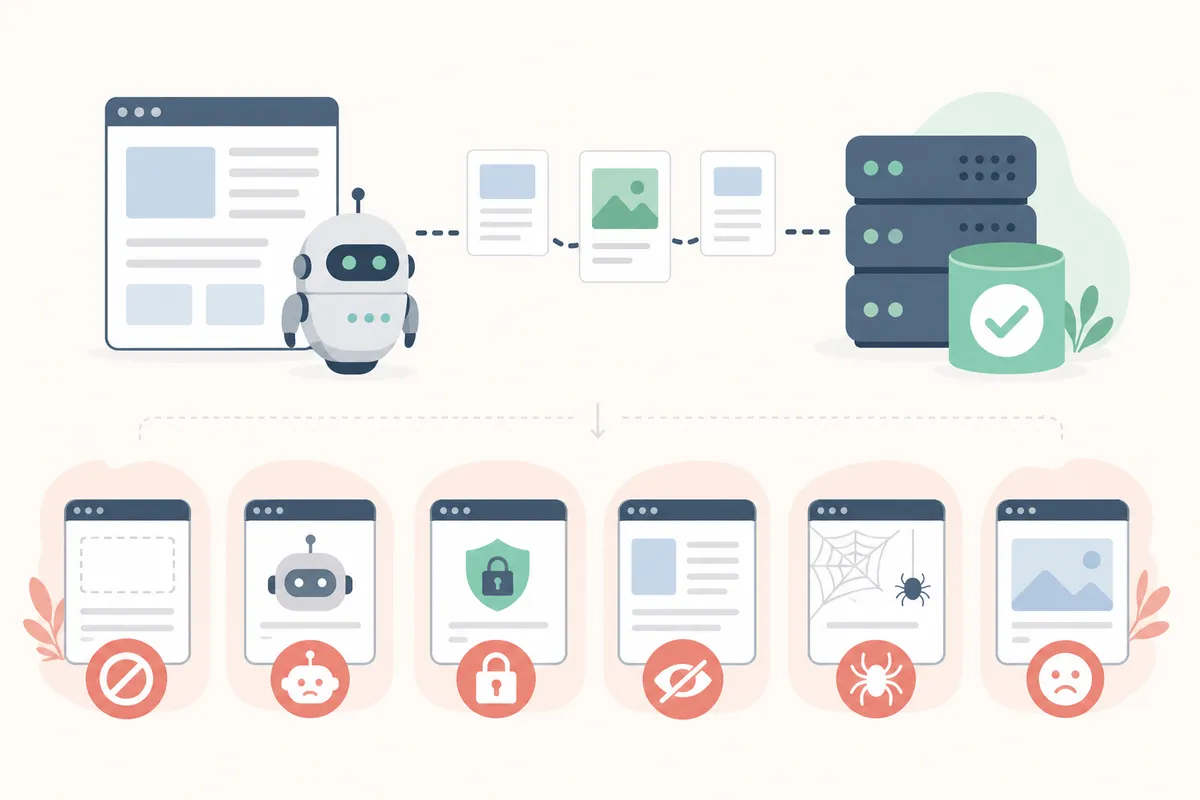
Le pagine non vengono saltate a caso. C'è quasi sempre un motivo preciso e diagnosticabile, e la maggior parte rientra in un breve elenco di cause ricorrenti.
Contenuti scarsi o duplicati
Le pagine con poco valore unico sono il motivo più comune per cui Google sceglie di non indicizzare una pagina. Esempi tipici sono le schede prodotto brevi con testi del produttore, le pagine di località quasi identiche e i filtri generati automaticamente. Il crawler ha visto il contenuto, ma il motore di ricerca ha deciso che non valeva la pena archiviarlo separatamente.
Tag noindex e blocchi nel file robots.txt
Un meta tag o un header noindex dice direttamente al motore di ricerca di non indicizzare la pagina. Capita di continuo che vengano lasciati su pagine per errore, che si tratti di un tag di un sito di staging mai rimosso prima del lancio o di un'impostazione predefinita del CMS che applica in silenzio il noindex a certi tipi di pagina. Una regola disallow nel file robots.txt ha un effetto affine ma diverso: può bloccare del tutto la scansione, e di conseguenza impedisce l'indicizzazione. Il protocollo di esclusione robots.txt è più di una semplice convenzione informale, dato che l'IETF lo ha standardizzato formalmente come RFC 9309 nel 2022, e i crawler conformi di motori di ricerca diversi rispettano tutti la stessa sintassi disallow.
Crawl budget e dimensioni del sito
I motori di ricerca dedicano a ciascun sito una quantità limitata di attenzione di scansione, in base più o meno alle sue dimensioni, alla frequenza di aggiornamento e allo stato di salute delle risposte del server. Sui siti molto grandi, le pagine di poco valore possono consumare crawl budget che dovrebbe andare alle pagine che vuoi davvero indicizzare, quindi alcune pagine finiscono per essere scansionate raramente o per niente.
Pagine con molto JavaScript e single-page app
I motori di ricerca sanno renderizzare il JavaScript, ma è un passaggio più lento e dispendioso rispetto alla lettura del semplice HTML, e non sempre riesce senza intoppi. I contenuti che compaiono solo dopo l'esecuzione di JavaScript lato client, frequenti nelle single-page application, possono essere ignorati o indicizzati in ritardo. È una modalità di errore ben documentata, e perché le single-page app spariscono da Google ne approfondisce i meccanismi.
Conflitti di canonicalizzazione
Quando una pagina ha un tag canonical che punta a un URL diverso, che sia voluto o per errore, Google in genere indicizza la versione canonica invece di quella scansionata. Un tag canonical configurato male può tenere in silenzio fuori dall'indice una pagina altrimenti valida, a favore dell'URL sbagliato.
| Motivo per cui le pagine vengono saltate | Come appare in Search Console | Soluzione tipica |
|---|---|---|
| Contenuti scarsi o duplicati | "Duplicate, Google chose different canonical" o "Crawled – currently not indexed" | Unire o riscrivere con contenuti unici e sostanziosi |
| Tag noindex o blocco nel robots.txt | "Excluded by 'noindex' tag" o "Blocked by robots.txt" | Rimuovere il tag o aggiornare la regola disallow |
| Limiti di crawl budget (siti grandi) | "Discovered – currently not indexed" | Eliminare le pagine di poco valore; migliorare i link interni verso le pagine prioritarie |
| Errori di renderizzazione JavaScript | Contenuto mancante nella versione in cache o renderizzata | Fare il rendering lato server o pre-renderizzare i contenuti chiave |
| Conflitti di canonicalizzazione | "Alternate page with proper canonical tag" | Correggere o rimuovere i tag canonical errati |
La maggior parte di questi problemi risale ai fondamenti della SEO tecnica più che alla sola qualità dei contenuti. Se vedi uno schema di esclusioni su molte pagine, analizza gli interventi di SEO tecnica che spostano davvero il posizionamento prima di dare per scontato che il problema siano i contenuti.
Un esempio pratico: seguire una pagina dalla pubblicazione all'indice
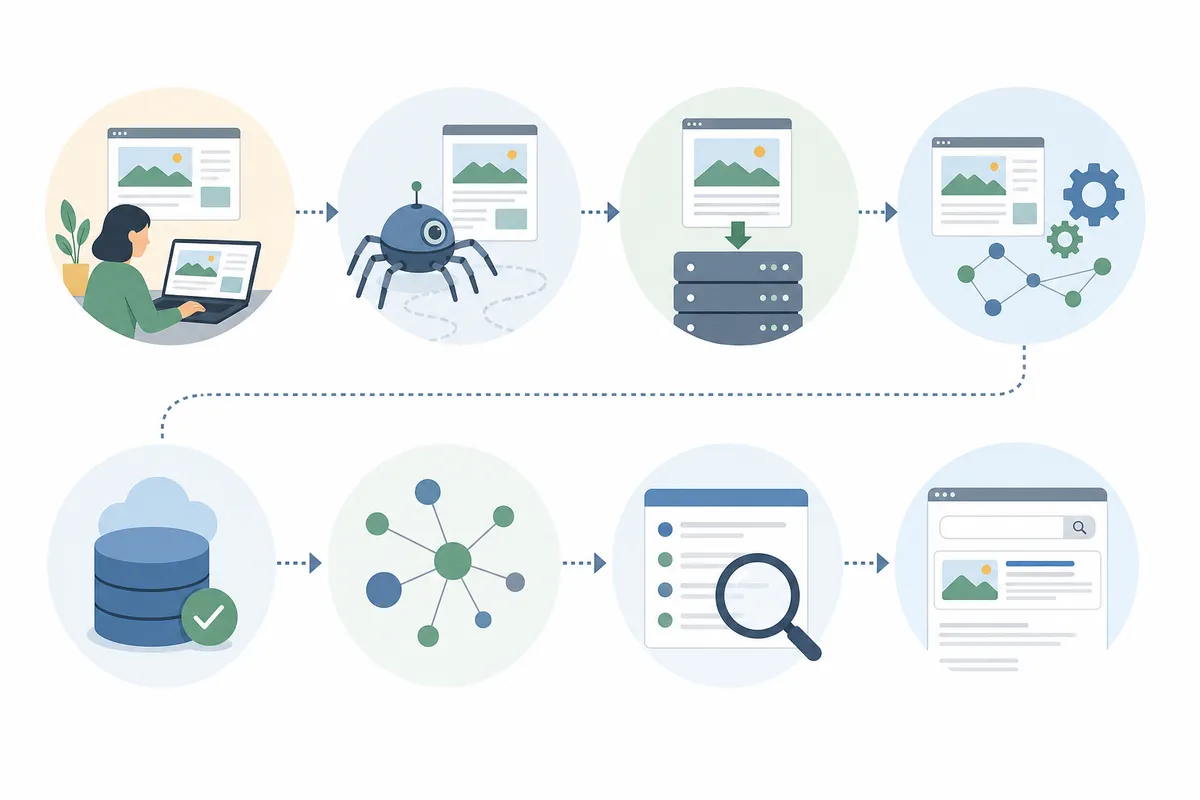
Ecco una sequenza realistica per un nuovo articolo di blog su un sito consolidato con un buon storico di scansione, descritta attraverso azioni concrete invece di trattare l'indicizzazione come una scatola nera.
- Giorno 0: la pagina viene pubblicata. La sitemap XML del sito si rigenera automaticamente, quindi il nuovo URL viene aggiunto al file della sitemap nel giro di pochi minuti.
- Giorno 0-1: altre pagine hanno già link interni verso il nuovo articolo e la sitemap è aggiornata, quindi Googlebot scopre l'URL alla successiva scansione programmata della sitemap, di solito entro un giorno per un dominio consolidato.
- Giorno 1-3: Googlebot scansiona e renderizza la pagina. Lo strumento Controllo URL (URL Inspection) di Search Console, controllato a mano il giorno 2, non mostra ancora "URL is on Google", ma una scansione è stata registrata.
- Giorno 3-7: la pagina viene valutata per unicità e qualità rispetto al resto dei contenuti del sito. Se supera la valutazione, viene aggiunta all'indice, e il report Copertura (Coverage) intorno ai giorni 5-7 mostrerebbe in genere l'URL passare da "Discovered – currently not indexed" (se mai vi è comparso) a "Indexed".
- Dal giorno 7 in poi: la pagina può comparire nei risultati di ricerca e iniziare a competere. Ottenere posizionamenti significativi per un termine competitivo può richiedere molto più tempo, ma questo appartiene alla fase di posizionamento, che procede in modo indipendente dall'indicizzazione.
Prendi ora un dominio nuovo di zecca, senza backlink e senza storico di scansione. La stessa pagina potrebbe non essere scoperta affatto finché non invii a mano una sitemap tramite Search Console, dato che Googlebot non ha uno schema di scansione consolidato da seguire né link equity interna che lo attiri. Una volta scoperta, il tempo che passa dalla scansione all'indicizzazione può dilatarsi da giorni a diverse settimane, e le indicazioni di Google stesso riconoscono che i siti nuovi in genere impiegano più tempo a essere scansionati e indicizzati in modo costante rispetto ai siti con uno storico consolidato.
La differenza tra i due scenari non sta nel contenuto, ma in tutto ciò che lo circonda: aggiornamento della sitemap, link interni e storico di scansione del dominio. È per questo che la stessa soluzione, come richiedere l'indicizzazione tramite Controllo URL, dà un risultato in giornata su un sito e non fa quasi nulla su un altro. Lo strumento si limita a dare una spinta alla coda; non scavalca i segnali su cui si basa la decisione di indicizzare.
Puoi risolvere da solo i problemi di indicizzazione?
Sì, nella maggior parte dei casi comuni. Rimuovere un tag noindex accidentale, correggere una regola del robots.txt, inviare una sitemap o richiedere l'indicizzazione di un singolo URL tramite Google Search Console sono tutte operazioni che un proprietario di sito può fare senza aiuto specializzato, di solito in meno di un'ora.
La diagnosi è più difficile dell'esecuzione. La soluzione per "Crawled – currently not indexed" può essere la riscrittura di un contenuto, una correzione del canonical, una modifica ai link interni o un problema di crawl budget, e Search Console non sempre dice quale sia il caso. Leggere correttamente il report di copertura, e sapere quali motivi di esclusione sono urgenti e quali sono normali, richiede una certa familiarità con il modo in cui vengono prese le decisioni di indicizzazione.
Un approccio ragionevole è partire dagli interventi meccanici: tag noindex, robots.txt e invio della sitemap. Se dopo qualche settimana le pagine risultano ancora non indicizzate e non c'è una causa evidente, un audit di SEO tecnica più approfondito vale il suo costo.
Come far indicizzare le pagine più in fretta
Nessuno di questi metodi obbliga un motore di ricerca a indicizzare una pagina di bassa qualità, perché quella decisione dipende ancora dai segnali di contenuto e tecnici. Quello che fanno è ridurre il ritardo tra pubblicazione e scoperta, cosa che conta molto per i contenuti legati a una scadenza temporale.
Sitemap XML
Una sitemap XML è un file che elenca ogni URL del tuo sito che vuoi far conoscere ai motori di ricerca. Funziona da mappa per i crawler, indicando loro le pagine che altrimenti potrebbero sfuggire, soprattutto sui siti grandi o con una struttura molto profonda. Inviarla non garantisce l'indicizzazione, ma elimina il problema del "il crawler non ha mai trovato questa pagina".
Per inviare una sitemap in Google Search Console, apri il report Sitemap (Sitemaps), fai clic su "Aggiungi una nuova sitemap" ("Add a new sitemap"), inserisci l'URL della sitemap (di solito yoursite.com/sitemap.xml) e invia. Bing Webmaster Tools ha una sezione Sitemaps equivalente, con lo stesso procedimento di base.
Lo strumento Controllo URL di Google Search Console
Per una singola pagina che richiede attenzione subito, lo strumento Controllo URL (URL Inspection) ti permette di verificare lo stato di indicizzazione di un URL specifico e di richiedere direttamente una scansione. Incolla l'URL, controlla gli eventuali problemi segnalati e, se nulla blocca la pagina, richiedi subito l'indicizzazione.
Usalo per casi come "ho appena corretto un tag noindex e voglio che Google se ne accorga in fretta". Non è pensato per inviare in blocco centinaia di URL.
L'Indexing API di Google
L'Indexing API di Google ti permette di notificare a Google in modo programmatico URL nuovi o aggiornati, senza aspettare la scansione di una sitemap o una richiesta manuale con Controllo URL. Google l'ha indicata come particolarmente utile per i siti con contenuti di breve durata, come offerte di lavoro, pagine di livestream ed elenchi di eventi, dove la velocità conta più della copertura.
La configurazione richiede di creare un progetto Google Cloud e un account di servizio, verificare la proprietà in Search Console e generare un token di accesso, un impegno tecnico decisamente maggiore rispetto a una sitemap. Google consiglia comunque di inviare anche una sitemap completa, perché l'API è un'integrazione e non un sostituto.
Bing Webmaster Tools e IndexNow
Bing Webmaster Tools include una propria funzione di invio degli URL, che permette di inviarne fino a 10.000 al giorno per una scansione e una valutazione quasi immediate. Le pagine che rispettano la soglia di qualità di Bing possono comparire nei risultati poco dopo l'invio.
Bing sostiene anche IndexNow, un protocollo che permette a un sito di avvisare i motori di ricerca nel momento stesso in cui una pagina viene pubblicata, aggiornata o eliminata, invece di aspettare la successiva scansione programmata. Poiché i motori che aderiscono lo condividono, un solo invio può notificare più di uno di essi. Microsoft ha descritto IndexNow come un'iniziativa congiunta sviluppata insieme a Yandex, pensata per ridurre le scansioni ripetute e speculative su cui entrambi i motori altrimenti si basano per accorgersi che una pagina è cambiata.
Link interni e backlink
Una pagina collegata da altre pagine del tuo sito, soprattutto da pagine che i crawler visitano già spesso, è più facile da trovare e segnala che vale la pena tornare a visitarla. Le pagine orfane, senza link interni che puntino a loro, sono tra le più lente a essere indicizzate. Correggere le lacune nei link interni è spesso una leva più efficace di qualsiasi strumento di invio, perché è un segnale permanente e non un impulso una tantum.
Aiutano anche i backlink esterni, dato che un crawler che segue un link da un altro sito è uno dei modi originari in cui scopre nuove pagine. I segnali social possono a volte accelerare la scoperta in modo indiretto, quando un link condiviso viene cliccato, scansionato o rilanciato, ma non sono un meccanismo di indicizzazione diretto come lo sono una sitemap o l'Indexing API.
| Metodo | Motore/i di ricerca | Utilizzo ideale | Limite pratico | Velocità tipica |
|---|---|---|---|---|
| Sitemap XML | Google, Bing | Copertura dell'intero sito, scoperta continua | Un solo invio copre tutto il sito | Giorni, rivisitata in base al calendario di scansione |
| Strumento Controllo URL | Una singola pagina urgente | Un URL alla volta | Da ore a qualche giorno | |
| Indexing API | Google (ufficialmente per offerte di lavoro e livestream) | Pagine che cambiano spesso e di breve durata | Quota giornaliera per progetto | Quasi immediata una volta configurata |
| Invio URL di Bing | Bing | Invio in blocco di pagine nuove o aggiornate | Fino a 10.000 URL al giorno | Valutazione quasi immediata |
| IndexNow | Bing e motori aderenti | Notifica istantanea alla pubblicazione, aggiornamento o eliminazione | Nessun limite giornaliero fisso dichiarato | Notifica quasi immediata |
Come verificare se le tue pagine sono indicizzate
Prima di risolvere un problema di indicizzazione, verifica che esista davvero. Alcuni metodi sono affidabili.
- Il report Copertura/Indicizzazione di Google Search Console (Coverage/Indexing) mostra quali URL sono indicizzati, quali sono esclusi e il motivo specifico di ogni esclusione. È la fonte di verità più precisa per Google.
- L'operatore di ricerca
site:(digitandosite:yourdomain.com/page-urlsu Google) offre un controllo rapido e approssimativo, anche se è noto che non è preciso per i conteggi esatti. - Bing Webmaster Tools ha un proprio report sulla copertura dell'indice, parallelo a quello di Google, per lo stato specifico su Bing.
- Lo strumento Controllo URL fornisce una risposta definitiva per singola pagina su Google, compresa la data dell'ultima scansione e gli eventuali problemi rilevati.
Esegui il controllo con regolarità, non una sola volta dopo il lancio. Le pagine possono uscire dall'indice in un secondo momento a causa di un restyling del sito, di un tag noindex accidentale introdotto con l'aggiornamento di un template o di un aggiornamento core che rivaluta la qualità dei contenuti su tutto il sito.
Google, Bing e DuckDuckGo: come cambia l'indicizzazione da un motore all'altro
Non tutti i motori di ricerca indicizzano il web allo stesso modo, e le differenze influenzano il modo in cui diagnosticheresti una pagina mancante.
| Motore | Crawler proprio | Indice proprio | Velocità tipica di scoperta | Strumento principale di invio |
|---|---|---|---|---|
| Googlebot | Sì, centinaia di miliardi di pagine secondo le cifre di Google | Da ore a settimane, in base all'autorevolezza del sito | Search Console (sitemap, Controllo URL, Indexing API) | |
| Bing | Bingbot | Sì, decine di miliardi di pagine secondo le cifre di Bing | Intervallo simile a Google, spesso più rapido per i siti piccoli tramite IndexNow | Bing Webmaster Tools, IndexNow |
| DuckDuckGo | Limitato (DuckDuckBot) | Parziale; combina la propria scansione con risultati su licenza di Bing | Legata alla fonte sottostante che fa emergere la pagina | Nessuno strumento di invio dedicato per la maggior parte dei risultati |
Google e Bing gestiscono entrambi da zero sistemi di crawler e indice su larga scala, quindi gli interventi di questa guida, come sitemap, controlli sul noindex e IndexNow, valgono per entrambi con solo piccole differenze negli strumenti. DuckDuckGo è un caso diverso. Ha dichiarato pubblicamente di ricavare una grossa parte dei suoi risultati web dall'indice di Bing invece di scansionare l'intero web in modo indipendente, accanto al proprio crawler e a centinaia di altre fonti. Una pagina indicizzata e ben posizionata su Bing ha quindi molte più probabilità di comparire su DuckDuckGo rispetto a una pagina indicizzata solo su Google, e non esiste un equivalente di Search Console per DuckDuckGo con cui controllare lo stato direttamente.
Se un'azienda dipende dalla visibilità su più motori, verificare che una pagina sia indicizzata su Bing copre più terreno di quanto sembri, dato che quell'unico indice alimenta più di una pagina di risultati. Controllare solo site:yourdomain.com su Google e dare per scontato che il quadro sia lo stesso ovunque è un punto cieco molto comune.
Quando rivolgersi a un professionista per l'indicizzazione
La maggior parte dei problemi di indicizzazione isolati si risolve senza aiuto esterno. Rivolgiti a un professionista quando il quadro è più ampio di una singola pagina: grandi porzioni del sito bloccate in "Discovered – currently not indexed", una migrazione che ha fatto crollare l'indicizzazione su tutto il sito, o un framework JavaScript che i crawler non hanno mai renderizzato correttamente.
Queste situazioni di solito richiedono qualcuno in grado di leggere i log del server, confrontare l'HTML renderizzato reale con quello che vede un crawler e risalire al problema attraverso una pila di cause possibili invece che una sola evidente. Se pubblichi regolarmente nuovi contenuti e vuoi che siano ben strutturati e indicizzabili fin dall'inizio, guarda come il tuo processo gestisce la scrittura di contenuti SEO che si posizionano prima che il problema si moltiplichi su decine di pagine.
Domande frequenti
Qual è la differenza tra scansione e indicizzazione?
La scansione è un bot che scopre e visita una pagina. L'indicizzazione è il motore di ricerca che decide di archiviare il contenuto di quella pagina nel proprio database. Una pagina può essere scansionata senza mai essere indicizzata.
Quanto tempo richiede l'indicizzazione nei motori di ricerca?
Varia molto: da pochi minuti per un sito consolidato e scansionato spesso che usa l'Indexing API o IndexNow, fino a diverse settimane per un sito nuovo con pochi link interni o esterni che puntano alle sue pagine.
Perché Google dovrebbe scansionare la mia pagina ma non indicizzarla?
Di solito significa che Google ha giudicato il contenuto troppo scarso, troppo simile a un'altra pagina che ha già, oppure meglio rappresentato da un URL canonical diverso. Possono causarlo anche blocchi tecnici come i tag noindex.
Inviare una sitemap garantisce l'indicizzazione?
No. Una sitemap aiuta solo i motori di ricerca a scoprire un URL più in fretta. L'indicizzazione dipende comunque dalla qualità dei contenuti e da segnali tecnici come i tag noindex o la canonicalizzazione.
Una pagina può perdere lo stato di indicizzata dopo essere stata indicizzata una volta?
Sì. Le pagine possono essere eliminate dall'indice in un secondo momento per modifiche ai contenuti, tag noindex accidentali, migrazioni del sito o una rivalutazione durante un aggiornamento core dell'algoritmo.
Google indicizza PDF, immagini e video allo stesso modo delle pagine web?
Sì, con alcune differenze. Google può indicizzare i PDF ed estrarne il testo. Sia Google sia Bing indicizzano immagini e video attraverso segnali come il testo alternativo, i nomi dei file e il contenuto della pagina circostante, come descrive la documentazione di Google sull'indicizzazione di immagini e video, invece di comprendere visivamente il file come analizzano il testo HTML.
Quante pagine contiene davvero l'indice di Google?
La pagina How Search Works di Google afferma che l'indice contiene centinaia di miliardi di pagine web. Google non pubblica un conteggio esatto e aggiornato di continuo, perché la cifra cambia man mano che le pagine vengono aggiunte e rimosse.
C'è un modo per vedere il numero totale delle mie pagine indicizzate?
Il report Pagine (Pages) nella sezione Indicizzazione di Google Search Console è il conteggio più affidabile per il tuo sito, suddiviso in URL indicizzati e non indicizzati con un motivo per ogni esclusione. L'operatore site: offre una stima approssimativa visibile a tutti, ma Google ha avvertito che non è accurato per i conteggi esatti.
Fai diagnosticare i tuoi problemi di indicizzazione
L'indicizzazione nei motori di ricerca è il varco che ogni pagina deve superare prima di potersi posizionare, e la maggior parte dei siti ha almeno qualche pagina rimasta in silenzio bloccata lì. Il modo più rapido per scoprire dove succede sul tuo sito è vedere in un unico posto i tuoi dati reali di indicizzazione e posizionamento. Parla con il team e ricevi un report di esempio che mostra quali delle tue pagine sono indicizzate, quali sono a rischio e cosa conviene sistemare per primo.
Letture correlate: Discourage Search Engines From Indexing This Site: A Setup Guide.
Letture correlate: "Discovered – Currently Not Indexed": What It Means and How to Fix It.
Letture correlate: SEO for News Sites: How to Get Articles Indexed and Ranking Fast.
Letture correlate: How to Get Google to Crawl My Site: A Step-by-Step Fix.
Fonti
Sull'autore
SearchBlueprint ha ricercato, scritto e valutato questo articolo con la stessa pipeline di contenuti che i nostri clienti usano sui loro siti. Il punteggio indicato nella firma è quello che il nostro motore di contenuti ha assegnato a questa pagina prima della pubblicazione. Nulla qui è rivisto a mano, ed è proprio questo il punto: è il risultato del prodotto, pubblicato dove chiunque può verificarlo.